
python爬虫简单代码爬取郭德纲单口相声
搜索老郭的单口相声,打开检查模式,刷新
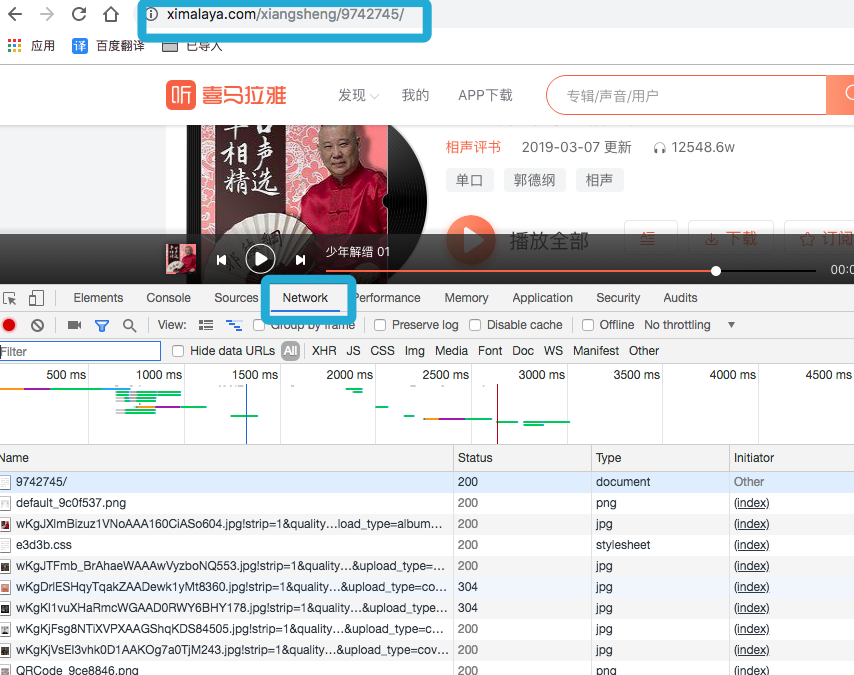
没有什么有价值的东东, 不过....清掉内容, 点击一个相声,再看看有些什么
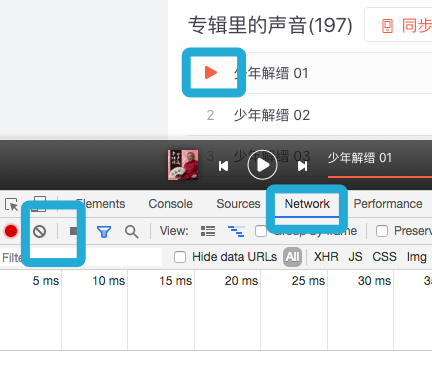
是不是发现了些什么
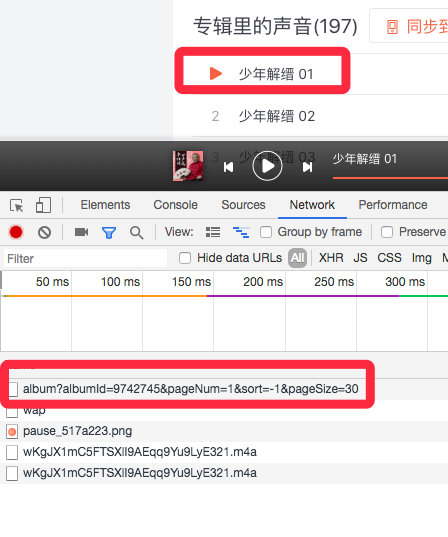
我们来点击这个看看, 首先看一下headers, 这个url是不是看起来很顺眼
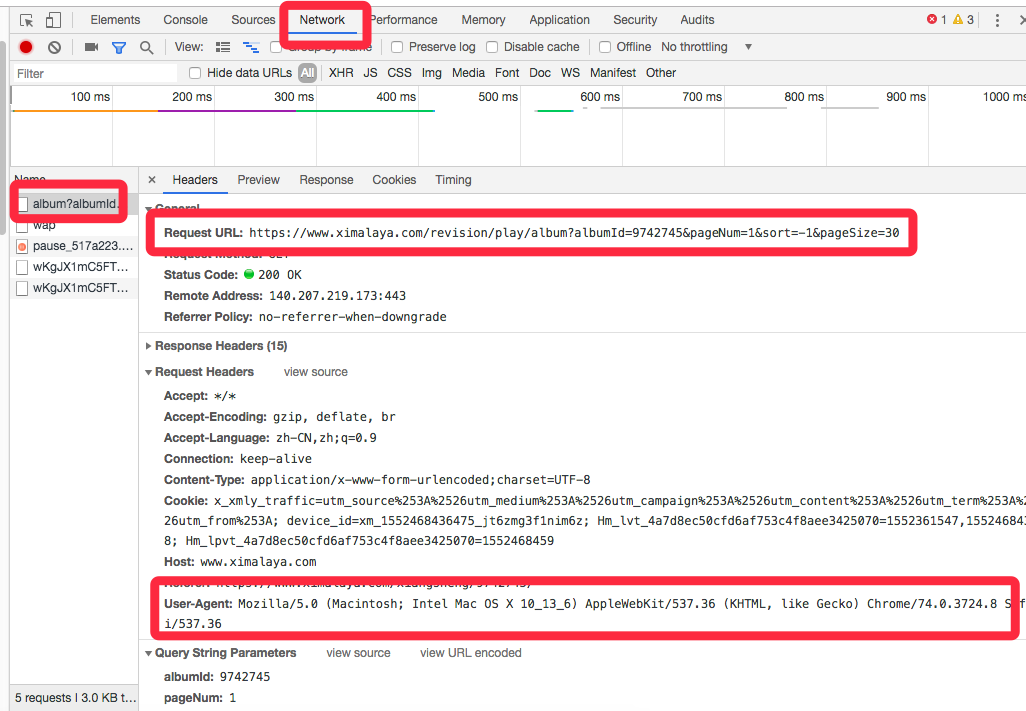
再来preview, 或者打开那个Request URL
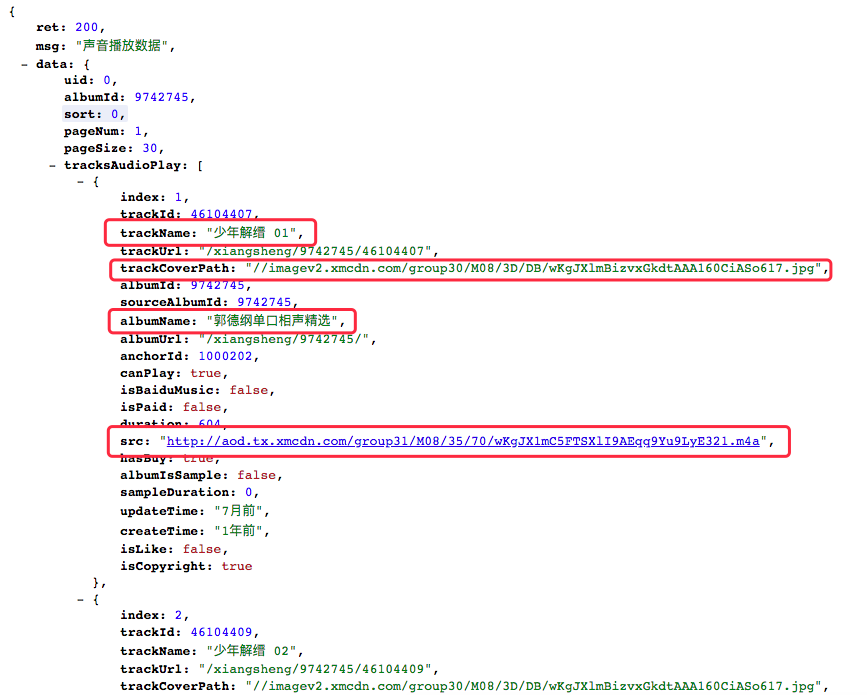
# -*- coding:utf-8 -*-

# Author : Niuli

# Data : 2019-03-13 16:08

import requests,os

# 数据来源

URL = 'https://www.ximalaya.com/revision/play/album?albumId=9742745&pageNum=1&sort=-1&pageSize=30'

# 伪造请求头

XMLY_HEADER = {'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3724.8 Safari/537.36'}

res = requests.get(URL,headers=XMLY_HEADER)

res_json = res.json()

play_list = res_json['data']['tracksAudioPlay']

ALL_PATH = play_list[0]['albumName']

# 创建本地专辑文件夹

os.system(f'mkdir -p {ALL_PATH}/MUSIC')

os.system(f'mkdir -p {ALL_PATH}/COVER')

MUSIC_PATH = ALL_PATH + '/MUSIC'

COVER_PATH = ALL_PATH + '/COVER'

for i in play_list:

    # print(i['trackName'])

    # print(i['trackCoverPath'])

    # print(i['src'])

    # 获取文件信息 (标题 音乐路径 图片路径)

    url_title = i['trackName']

    url_music_path = i['src']

    url_cover_path = 'https:' + i['trackCoverPath']

    # 下载保存音乐文件

    music_file = requests.get(url_music_path)  # 下载文件

    local_music_path = os.path.join(MUSIC_PATH,f'{url_title}.mp3')  # 保存路径+文件名+后缀

    # 写入音乐文件

    with open(local_music_path,'wb') as f:

        f.write(music_file.content)

    # 下载保存图片信息

    cover_file = requests.get(url_cover_path)  # 下载文件

    local_cover_path = os.path.join(COVER_PATH,f'{url_title}.jpg')  # 保存路径+文件名+后缀

    # 写入图片文件

    with open(local_cover_path, 'wb') as f:

        f.write(cover_file.content)
同理可以获取其他音频咯
python爬虫简单代码爬取郭德纲单口相声的更多相关文章
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
- Python 爬虫入门之爬取妹子图
Python 爬虫入门之爬取妹子图 来源:李英杰 链接: https://segmentfault.com/a/1190000015798452 听说你写代码没动力?本文就给你动力,爬取妹子图.如果 ...
随机推荐
- visual2017专业版MFC编程环境搭建及第一个MFC程序的创建
1.MFC介绍及环境搭建 MFC全程为Microsoft Foundation class Library,即微软的基本类库,MFC实际上是一个庞大的文件库,它由指向文件和源文件组成. 首先,打开vi ...
- appendChild()方法遇到的问题
在使用appendChild()方法中遇到了一个问题: 下面的代码可以正常插入多个新元素 <input type="button" value="在后面插入新元素& ...
- MFC文件IO和串行化
一. MFC中CFile对象实现了磁盘文档的读写,但是大部分MFC应用程序的IO服务都使用CArchive对象来完成.不管CFile和Archive输入输出的都是二进制数据,非文本数据. int a ...
- Flask中的before_request after_request
1.@app.before_request 在请求(request)之前做出响应 @app.before_request 也是一个装饰器,他所装饰的函数,都会在请求进入视图函数之前执行 2.@app. ...
- MessageBeep - Play a System sound
There is a interesting function which can play a System sound. First let's see the WinAPI. //声明: Mes ...
- Win10手记-为应用集成SQLite(一)
SQLite是什么?熟悉移动端开发的朋友都会经常接触,无论是iOS的CoreData还是安卓的内置数据库,他们都是采用了SQLite这个轻量高效数据库,微信也是如此.可以说SQLite是目前移动端最为 ...
- H5拖动火狐自动打开新标签
写在前面的话:<H5拖动火狐自动打开新标签>原因是为什么百度很多了我就不细说,本文章只说我自己的解决方法... 自定义数据里写个链接,如果火狐自动打开就跳到这个链接 这个页面就写一句话:关 ...
- Java 基础学习总结(一)抽象类和接口
接触java的时间不是很长,以前对抽象类和接口的定义和区别也是模糊不清,最近拿起学校的教程读了起来,也参阅了网上的博客大神理解和总结,于是决定自己按照自己的理解来总结一下. 抽象类(半成品) 一般 ...
- VS发布 错误 未能将文件 复制到
在VS内部编译及试运行的时候并为出现错误一切正常 当将项目发布时提示XXX文件无法复制到对应的obj文件夹下 未能将文件 upfile\team\2013\0328\20130328112637296 ...
- python 中range函数的用法
一. range(start,end,step) 二.代码 [code1] for i in range(1,10,2): print("i=",i) [result1] i= 1 ...