
爬取精美壁纸5w张,爱了爱了
近日接到一个需求——爬取某应用商店所有在线销售壁纸,这个任务起初让我惊呆了。因为上级没有给我解决风控问题,若爬取在售资源被人家厂商追责怎么办?若造成人家服务器出问题怎么办?问的时候上级含糊其辞,唉!其实大家都懂。但为什么我接了这个活儿呢,因为我随便发了几页,发现好多小姐姐壁纸,那种贼漂亮大波浪的你懂的,不愧是壁纸级小姐姐。
想要5万张小姐姐壁纸的单独联系我哦~
抛开资源本身,下面是具体的实现方法。这次不用scrapy,用requests实现的哦~
一. 登录
这种资源只有登录才能获取,所以我们得先过登录这一关。
起初我不知道是数万数量级的资源,人家给我说的自动化操作,我以为ui自动化可以实现,所以我用selenium的衍生库来模拟点击。
import time

from common.utils import GetDriver

from page import SumsungPage

from selenium.common.exceptions import NoSuchElementException

page: SumsungPage

def verify(func):

    def wrapper(*args):

        func(*args)

        try:

            if page.log_out.is_displayed():

                return True

        except NoSuchElementException:

            return False

    return wrapper

class SumsungLogin:

    """

    **应用商店登录,优先cookie登录,cookie登录失败就用账号登录

    """

    def __init__(self):

        global page

        page = SumsungPage(GetDriver().driver())

    @verify

    def __account_login__(self):

        """

        账号密码登录

        """

        page.get(page.url)

        page.entry.click()

        page.phone.send_keys(page.u)

        page.password.send_keys(page.p)

        page.login.click()

        page.not_now.click()

        # 更新cookie

        time.sleep(2)

        with open("./cookie.json", 'w+') as f:

            f.write(str(page.get_cookies()))

    @verify

    def __cookie_login__(self):

        """

        cookie登录

        """

        page.get(page.url)

        with open("./cookie.json", 'r+') as f:

            cookie = eval(f.read())

        page.add_cookies(cookie)

        time.sleep(2)

        page.driver.refresh()

    def trigger(self):

        flag = self.__cookie_login__()

        flag = flag if flag else self.__account_login__()

        print('登录成功状态:', flag)

        return page if flag else "登录失败"
当我知道人家给我说错了后,我起初是很无语的,毕竟人家不懂技术。。。按照模拟点击这种方法,就算一张图片只用1秒,5万张图片得用5万秒,得爬到地老天荒啊!
然后我果断弃用,因为这得走接口的方式爬。
而走接口的方式有两种,一是通过requests.session,二是直接携带cookie。因为人家给我配了专门的账号,直接从浏览器上把cookie复制过来啦~
headers = {

    'Content-Type': "application/x-www-form-urlencoded",

    'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36",

    'Referer': "https://seller.samsungapps.com/content/common/summaryContentList.as",

    'Accept-Language': "zh-CN,zh;q=0.9,en;q=0.8,zh-TW;q=0.7",

    'Cookie': "SCOUTER=x7o8fo083la90t; _hjid=cd3eb857-86e9-40e5-bba4-22b101dd0552; api_auth_sub=N; sellerLocale=zh_CN; _hjTLDTest=1; SLRJSESSIONID=SLm48RCYo2WqmgbfoOt5aBjlN1zbEFw10hrQrS2WFkkXrrDaJ1E5mCL2uKcxL99E.YXBwc19kb21haW4vc2VsbGVyMTE=; iPlanetDirectoryPro=NTbL8ooVcqrDnHlwgDxcABJZuzyR4xsNS9RrqQranfGKUkPTiZR/f8kop4j6ELBPc+TaRMW88Y3hUrTscvFk5t7je/dtPLfsDoVvZZn6oau1CY4NKsdQlNlSzkj3hdp1Lj7hRz2a3Q6BENPmpVewwbT3nqyI0Pb4/ZEyHVoXTaAGDzi7NzXwM54qizpIDXc8hkXAaXhtLcvra+DyVc72Undh9U31LyYlXO53LavOIFOYgPRvA9O5b4ed6xUxxa2etz9lpMwzlIayMvrOg8hdwDE5evVwpayZjXUv1cW4lMCbJhHaVhEucux23kcOuGbBgjraYYteAQ1ndWEvm0ipsg==; gss_auth_token=V/RK27AqVE6LV2BHAoKit6cWK+EWYKc8ERpYh2Wm7ESfGLw+oU/fgZmO2w1Oo1B+A/eYhyJu/XI9EagBTF+7Jg/5vRxPyCJW9hxMvNl4dhIRrWqNCSt6IrRQb0ZWPau8xMero/9FKGi7M3lrkuOMo8aUbTnl127zw1kj0Mgbfxw=; api_auth_token=Scri8yrXRz9kYmjyPxxyDOT8lKbIfKt2TQcwPwfO14U16J0AU1vAUMsqF/LtCfg7CtYw4hQIuO6SK1mCOJKPagKvmCyt7EjBEr1TTfIhjJPWbJkJ6pey9+Sj0CWEm/EuD/rjwUPc5THhiM7vpOkpWSqJLQYDmZ6AEy5cdtsOFIZSoZmbmZnMT8CIyig0GdE8FOPNJHpXrHxTgGSRQtsgyqYiXlFGKzfmjueeMC+x02ubCLNFdhReKZ2sfBzvFc8gxPyathHVXSYN+WCW/CTheiFwTP7D8N93agwEopZeLP79UvgwOyZi1VNwNl5GGe/le8qdiv10IhWjHMbNkt4lcA==; api_server_url=cn-auth2.samsungosp.com.cn; auth_server_url=cn-auth2.samsungosp.com.cn; _hjIncludedInPageviewSample=1; _hjAbsoluteSessionInProgress=1",

}
cookie放在请求头里,我们请求头里还要添加上基本的信息,爬虫时要养好这个习惯。
二.特征提取
要爬取的是图片的id和图片的url,然后根据图片的url来进行下载,所以总共有两次爬取操作。打开谷歌浏览器页面调试台,定位到图片位置后,观察特征。
发现id都在这个td标签下面,并且id的长度为12位,能观察到的id都是以00开头,我需要的信息就在<td>标签里面;而url都是以前面的网址开头,需要的信息在img标签的src属性里面。
于是确定了它们的特征,提取出来的xpath表达式为:
img_id = s.xpath("//td[string-length(text())=12 and starts-with(text(), '00')]/text()")

img_url = s.xpath("//td/img[contains(@src,'https://img.**apps.com/content')]/@src")
翻页的特征不在地址栏,被我注意到在查询字符串里面。于是将payload写活。
payload = "statusTab=all&pageNo=" + str(page_number) + "&isOpenTheme=true&isSticker=false&hidContentType=all&serviceStatus=sale&serviceStatusSub=forSale&contentType=all&ctntId=&contentName="
三.爬取id和url
根据id和url的特征,以及实现翻页的技巧,获取所有的id和url自然不在话下。
一个一个爬取太慢,多线程走起~
import threading

from data import url, payload_pre, payload_bac, headers

import time

from lxml import etree

import requests

thread_max = threading.BoundedSemaphore(10)

def send_req(page):

    with thread_max:

        page = str(page)

        payload = payload_pre + str(page) + payload_bac

        response = requests.request("POST", url, data=payload, headers=headers)

        text = response.text

        s = etree.HTML(text)

        img_id = s.xpath("//td[string-length(text())=12 and starts-with(text(), '00')]/text()")

        img_url = s.xpath("//td/img[contains(@src,'https://img.samsungapps.com/content')]/@src")

        a = len(img_id)

        b = len(img_url)

        s_ = page + " " + str(a) + " " + str(b)

        with open("1.txt", "a") as f:

            for c, d in zip(img_id, img_url):

                f.write(c + " " + d + "\n")

        print("ok " + s_) if a and a == b else print("not ok " + s_ + 60 * "!")

def start_work(s, e):

    thread_list = []

    for i in range(s, e):

        thread = threading.Thread(target=send_req, args=[i])

        thread.start()

        thread_list.append(thread)

    for thread in thread_list:

        thread.join()

if __name__ == '__main__':

    star, end = 1, 1001

    t1 = time.time()

    start_work(star, end)

    print("[INFO]: using time %f secend" % (time.time() - t1))
四.根据url下载
如果前面的看懂了,那么这里自然而然就懂啦~
读取url文件,就像一个一个种子(老司机你懂的),然后批量下载~
import threading

import urllib.request as ur

thread_max = threading.BoundedSemaphore(10)

def get_inf():

    ids = []

    urls = []

    with open("img_1.txt", "r") as f:

        while True:

            con = f.readline()

            if con:

                ids.append(con[:12])

                urls.append(con[13:-1])

            else:

                break

    print(len(ids), len(urls))

    return ids, urls

def down_pic(id_, url_):

    with thread_max:

        try:

            ur.urlretrieve(url_, "./img_1/" + id_ + ".jpg")

        except Exception as e:

            print(e)

            print(id_, url_)

def start_work(id_, url_):

    thread_list = []

    for i, j in zip(id_, url_):

        thread = threading.Thread(target=down_pic, args=[i, j])

        thread.start()

        thread_list.append(thread)

    for thread in thread_list:

        thread.join()

if __name__ == '__main__':

    i_, u_ = get_inf()

    start_work(i_, u_)
五.注意事项
起初没有合理控制频次,人家页面提示这个:
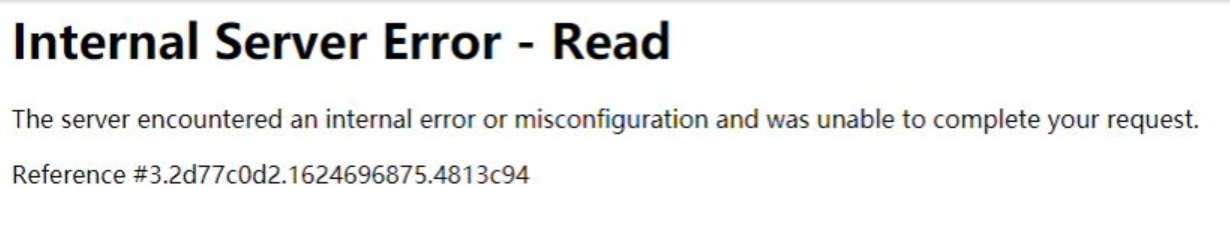
即便控制好了,但超过了人家的阈值,又提示了这个:
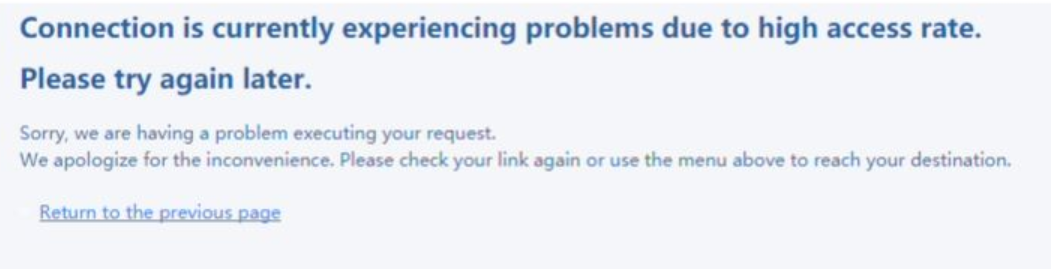
通过 threading.BoundedSemaphore() 控制多线程最大数量,危险时协调部门资源解决风控,合理爬取资源噢~
爬取精美壁纸5w张,爱了爱了的更多相关文章
- scrapy图片-爬取哈利波特壁纸
话不多说,直接开始,直接放上整个程序过程 1.创建工程和生成spiders就不用说了,会用scrapy的都知道. 2.items.py class HarryItem(scrapy.Item): # ...
- python爬取全站壁纸代码
#测试网址:https://www.ivsky.com/bizhi/ #需要安装的库:requests,bs4 #本人是个强迫症患者,为了美观添加数个print(),其并没有实际意义,若是不爽删去即可 ...
- Python 爬取必应壁纸
import re import os import requests from time import sleep headers = { "User-Agent": (&quo ...
- WebView2 通过 PuppeteerSharp 实现爬取 王者 壁纸 (案例版)
此案例是<.Net WebView2 项目,实现 嵌入 WEB 页面 Chromium内核>文的续集. 主要是针对WebView2的一些微软自己封装的不熟悉的API,有一些人已经对 Pup ...
- requests+正则表达式 爬取 妹子图
做了一个爬取妹子图某张索引页面的爬虫,主要用request和正则表达式. 感谢 崔庆才大神的 爬虫教学视频 和 gitbook: B站:https://www.bilibili.com/video/a ...
- python学习--第二天 爬取王者荣耀英雄皮肤
今天目的是爬取所有英雄皮肤 在爬取所有之前,先完成一张皮肤的爬取 打开anacond调出编译器Jupyter Notebook 打开王者荣耀官网 下拉找到位于网页右边的英雄/皮肤 点击[+更多] 进入 ...
- [python爬虫] Selenium定向爬取虎扑篮球海量精美图片
前言: 作为一名从小就看篮球的球迷,会经常逛虎扑篮球及湿乎乎等论坛,在论坛里面会存在很多精美图片,包括NBA球队.CBA明星.花边新闻.球鞋美女等等,如果一张张右键另存为的话真是手都点疼了.作为程序员 ...
- 爬取5K分辨率超清唯美壁纸
目录 爬取5K分辨率超清唯美壁纸 简介 编写思路 使用教程 演示图片 完整源代码 @ 爬取5K分辨率超清唯美壁纸 简介 壁纸的选择其实很大程度上能看出电脑主人的内心世界,有的人喜欢风景,有的人喜欢星空 ...
- 16、爬取知乎大v张佳玮的文章“标题”、“摘要”、“链接”,并存储到本地文件
爬取知乎大v张佳玮的文章“标题”.“摘要”.“链接”,并存储到本地文件 # 爬取知乎大v张佳玮的文章“标题”.“摘要”.“链接”,并存储到本地文件 # URL https://www.zhihu.co ...
- Python爬虫教程-爬取5K分辨率超清唯美壁纸源码
简介 壁纸的选择其实很大程度上能看出电脑主人的内心世界,有的人喜欢风景,有的人喜欢星空,有的人喜欢美女,有的人喜欢动物.然而,终究有一天你已经产生审美疲劳了,但你下定决定要换壁纸的时候,又发现网上的壁 ...
随机推荐
- 关于vlc"编解码器暂不支持: VLC 无法解码格式“MIDI” (MIDI Audio)"解决
解决办法 sudo apt install vlc-plugin-fluidsynth
- 命令查询职责分离 - CQRS
概念 CQRS是一种与领域驱动设计和事件溯源相关的架构模式, 它的全称是Command Query Responsibility Segregation, 又叫命令查询职责分离, Greg Young ...
- 【每日一题】【哈希表,返回结果的下标】2022年1月18日-NC61 两数之和
描述给出一个整型数组 numbers 和一个目标值 target,请在数组中找出两个加起来等于目标值的数的下标,返回的下标按升序排列.(注:返回的数组下标从1开始算起) 算法: import java ...
- 【每日一题】【迭代器,泛型】2022年1月8日-NC93 设计LRU缓存结构
描述设计LRU(最近最少使用)缓存结构,该结构在构造时确定大小,假设大小为 k ,并有如下两个功能1. set(key, value):将记录(key, value)插入该结构2. get(key): ...
- 18V转5V,15V转5V的LDO和DC芯片方案
18V 转 5V, 15V 转 5V 的 LDO:芯片的选择,特别是输入电压,在低电平 5V 以下的,基本上都是接近也可以.但是 5V 以上,如现在的 18V 和 15 的话,就不一样了.我们需要在选 ...
- Velero系列文章(四):使用Velero进行生产迁移实战
概述 目的 通过 velero 工具, 实现以下整体目标: 特定 namespace 在B A两个集群间做迁移; 具体目标为: 在B A集群上创建 velero (包括 restic ) 备份 B集群 ...
- apt install protobuf
protobuf介绍:https://www.cnblogs.com/niuben/p/14212711.html protobuf利用源码编译安装已经看到过很多方法,这里总结下用apt安装的方法. ...
- misc之套娃编码解密
题目: 01100101 01100110 00100000 01100010 01100101 00100000 00111001 01100110 00100000 01100011 011001 ...
- Windows关闭网络防火墙教程
Win10操作系统 1. 打开控制面板,点击"系统和安全" 2. 点击"Windows Defender 防火墙" 3. 点击"启用或关闭Window ...
- js取不到iframe元素
跨域 iframe 请绕道,下文是针对非跨域 iframe 的问题排除 1.iframe 取不到值的问题的原因 1. 父页面未加载完成 2. iframe 未加载完成 3. 语法使用错误 4. 跨域( ...