
libco协程原理简要分析
此文简要分析一下libco协程的关键原理。
在分析前,先简单过一些协程的概念,以免有新手误读了此篇文章。
协程是用户态执行单元,它的创建,执行,上下文切换,挂起,销毁都是在用户态中完成,对linux系统而言,其实协程和进程(注:在linux系统中,进程是拥有独立地址空间的线程)一样,都是CPU的执行单元,只是进程是站在操作系统的层面来看,操作系统帮我们实现了这一抽象概念,而协程是站在用户的应用程序层面来看,协程的实现得靠我们自己。我们常说使用协程可以做到以阻塞式的编码方式实现异步非阻塞的效果,这是因为我们在用户程序层面实现了调度器,当协程要阻塞的时候切换上下文,执行其余就绪的协程。
下面简要说一下实现一个协程库需要哪几个模块。
1 首先当然是操作系统的执行单元,对于一个执行单元来说,最基本的其实也就两点,一是指令,二是内存空间,指令定义了操作,内存用于保存指令中需要的数据,基于对指令和内存的抽象,我们这里先牵强的称之为协程。
2 有了执行单元后,当然就需要调度器来负责调度这些执行单元,如某个协程要阻塞了,就保存其上下文,然后运行下一个就绪状态的协程,当然调度器也是在一个协程单元中运行。
3 最后为了实现阻塞式编码实现非阻塞的效果,需要实现异步I/O,而异步IO也恰是调度协程的触发器。
协程库中有了这三个模块基本就完成了。这里有一个关键的点,那就是当前运行的协程要阻塞了,我们将其上下文保存,切换至下一个就绪状态的协程,这里该如何实现?
要回答这个问题,我们得先想想什么操作会引起当前协程阻塞?协程或者说所有的执行单元其实都是指令和数据的有序排列,指令的执行依赖于数据,因此协程阻塞的话想必是因数据而起,说白了就是I/O操作(当然还有sleep操作,这个先以特例看待)。为了避免当前协程阻塞导致整个进程都阻塞掉,我们可以使用多路I/O模型,例如epoll,将所有的I/O操都作通过epoll模型来进行,一旦有协程的需要进行IO,就保存好它的上下文环境,加入阻塞队列,然后再从就绪队列中取出下一个协程运行,待所有工作协程都陷入阻塞时,再通过epoll进行多路IO操作。
至于如何保存与恢复上下文这一点正是此文接下来要分析的。
我们先简要看一下协程上下文的定义
//coctx.h

struct coctx_t

{

#if defined(__i386__)

	void *regs[ 8 ];

#else

	void *regs[ 14 ];

#endif

	size_t ss_size;

	char *ss_sp;

};
该结构保存着协程的上下文,在这里先不解释各个变量的含义,将其拿出来只是为了解释协程切换的关键函数:coctx_swap,因为调用该函数时将传入两个coctx_t类型指针。
协程上下文切换的关键实现位于coctx_swap.S文件中。初学者可能会疑惑这是什么文件,这里简单解释一下,我们写的源代码能变成最终的可执行文件,是经过多个步骤的,分别是预处理->编译->汇编->链接4个过程,其中编译这一过程是将源代码转成汇编代码,那么为什么这里直接提供一个汇编代码文件,而不是一个.c或.cpp文件呢?因为这个函数跟我们用c/cpp写出的函数经过gnu编译器编译后生成的函数结构不一致,另外c/cpp的语法糖也无法实现对寄存器(主要是rsp和rip寄存器)的控制。
这里只看x86_64架构下的实现
.globl coctx_swap

#if !defined( __APPLE__ ) && !defined( __FreeBSD__ )

.type  coctx_swap, @function

#endif

coctx_swap:

    leaq 8(%rsp),%rax

	leaq 112(%rdi),%rsp

	pushq %rax

	pushq %rbx

	pushq %rcx

	pushq %rdx

	pushq -8(%rax) //ret func addr

	pushq %rsi

	pushq %rdi

	pushq %rbp

	pushq %r8

	pushq %r9

	pushq %r12

	pushq %r13

	pushq %r14

	pushq %r15

	movq %rsi, %rsp

	popq %r15

	popq %r14

	popq %r13

	popq %r12

	popq %r9

	popq %r8

	popq %rbp

	popq %rdi

	popq %rsi

	popq %rax //ret func addr

	popq %rdx

	popq %rcx

	popq %rbx

	popq %rsp

	pushq %rax

	xorl %eax, %eax

	ret
先简单解释一下头部的代码:
.globl coctx_swap   //.global 声明coctx_swap是全局可见的

#if !defined( __APPLE__ ) && !defined( __FreeBSD__ )

.type  coctx_swap, @function    //gnu汇编器定义函数时的规则

#endif

coctx_swap:                     //coctx_swap函数内容开始

    leaq 8(%rsp),%rax

	leaq 112(%rdi),%rsp

	...
上面已经提过了,该函数实际被调用时,传入了两个参数,均为coctx_t类型指针。接下来我们看该函数的上半段:
coctx_swap:

    leaq 8(%rsp),%rax

	leaq 112(%rdi),%rsp

	pushq %rax

	pushq %rbx

	pushq %rcx

	pushq %rdx

	pushq -8(%rax) //ret func addr

	pushq %rsi

	pushq %rdi

	pushq %rbp

	pushq %r8

	pushq %r9

	pushq %r12

	pushq %r13

	pushq %r14

	pushq %r15

	...
lea是取址指令,b,w,l,q是操作属性限定符,分别表示1字节,2字节,4字节,8字节。在x86_64架构下,函数调用时,参数传递将从左到右分别存入rdi,rsi,rdx,rcx,r8,r9,当这6个不够用的时候才会借用栈。
此处简要提一下x86_64架构下gnu编译器编译后的c/cpp函数调用过程:
1 传参,主要是传递给寄存器。当寄存器不够用时,会丛右到左压栈,然后再传参给寄存器
2 将返回地址压栈,该地址一般指向上一函数中的下一条指令
3 修改rip寄存器(指令寄存器)为调用函数的起始地址,新的函数开始了
4 将上个函数的栈帧基址(rbp寄存器用于存放栈帧基址)压入栈中
5 将rbp寄存器中的值修改为rsp寄存中的值,即开启了新的栈帧
其中2,3是一般由call指令做的(当然也可以拆分为push,jump两个指令),4,5为被调函数里面的逻辑。
函数返回时是一个逆向的过程,即恢复到上个函数的栈帧即可。
其中rsp寄存器为栈顶的地址,由于栈空间是向下增长的,每次push,pop操作都会对其减少和增加对应的字节数。因此上半段相当于是把当前的各寄存器值存入了第一个参数传入的协程上下文的regs数组中,结果如下:
//low | regs[0]: r15 |

//    | regs[1]: r14 |

//    | regs[2]: r13 |

//    | regs[3]: r12 |

//    | regs[4]: r9  |

//    | regs[5]: r8  |

//    | regs[6]: rbp |

//    | regs[7]: rdi |

//    | regs[8]: rsi |

//    | regs[9]: ret |  //函数的返回地址

//    | regs[10]: rdx |

//    | regs[11]: rcx |

//    | regs[12]: rbx |

//hig | regs[13]: rsp | //该值为上个栈帧在调用该函数前的值
其实从这段代码中也能推出来了,传入的第一个参数必然就是当前工作协程的上下文变量,那么相应的,传入的第二个参数必然就是接下来要执行的工作协程。接下来看下半段代码:
	movq %rsi, %rsp

	popq %r15

	popq %r14

	popq %r13

	popq %r12

	popq %r9

	popq %r8

	popq %rbp

	popq %rdi

	popq %rsi

	popq %rax //ret func addr

	popq %rdx

	popq %rcx

	popq %rbx

	popq %rsp

	pushq %rax

	xorl %eax, %eax

	ret
第一行即把rsp(存储栈顶的地址,改变它的地址,就相当于改变了栈空间)替换为rsi寄存器中的值,上面提过了rsi保存着第二个参数中传入进来的上下文变量,即接下来要运行的工作协程的上下文。接着是一系列的赋值行为(注意栈空间是向下增长的),将接下来要运行的工作协程的上下文中的regs数组中的各值恢复到各寄存器中。将返回地址压入栈中,清0rax寄存器的低32位后(该寄存器一般用于存储函数返回值,这行代码并不是要拿它作为返回值使用,因为c/cpp代码在声明该函数时,它并没有返回值,个人感觉是出于程序安全考虑),执行ret指令(该指令用于将栈顶的返回地址弹出给rip寄存器,这也是push %rax 将返回地址压入栈中的原因),于是下一个工作协程开始运行了。
有没有感觉漏了些什么?
是的,漏了协程的上下文初始化过程。我们看一下其初始化函数:
//coctx.cpp

enum

{

	kRDI = 7,

	kRSI = 8,

	kRETAddr = 9,

	kRSP = 13,

};

int coctx_make( coctx_t *ctx,coctx_pfn_t pfn,const void *s,const void *s1 )

{

	char *sp = ctx->ss_sp + ctx->ss_size;

	sp = (char*) ((unsigned long)sp & -16LL  );

	memset(ctx->regs, 0, sizeof(ctx->regs));

	ctx->regs[ kRSP ] = sp - 8;

	ctx->regs[ kRETAddr] = (char*)pfn;

	ctx->regs[ kRDI ] = (char*)s;

	ctx->regs[ kRSI ] = (char*)s1;

	return 0;

}
其中,下面的两行代码最为重要
	ctx->regs[ kRSP ] = sp - 8;

	ctx->regs[ kRETAddr] = (char*)pfn;
第一行是将rsp寄存器替换为了该协程私有的栈空间地址,这样就保证了每个协程具备独立的栈空间。
为什么替换了rsp寄存器就保证了该协程将使用自己的栈空间地址呢?

因为栈空间的分配和回收,是通过rsp寄存器来控制的,如我要分配4个字节时,可执行sub $0x4,%rsp,回收4个字节时,可执行add $0x4,%rsp,因此当替换了rsp寄存器的值时,即替换了栈空间
第二行是将返回地址(即下一条执行指令)替换为了用户创建协程时传入的开始函数地址。
当然一个函数的执行少不了传参,因此接下来的两行代码,就把参数赋值给了regs数组中对应与rdi寄存器和rsi寄存器的位置
	ctx->regs[ kRDI ] = (char*)s; //rdi寄存器保存从左到右的第一个参数

	ctx->regs[ kRSI ] = (char*)s1; //rsi寄存器保存从左到右的第二个参数
到此,核心部分均分析完毕。接下来再回顾核心函数coctx_swap的代码,上面我已经提过了,这个函数的结构和普通的c/cpp写出的函数经gnu编译器编译后生成的函数结构不一致,在接下来的代码中,我会在注释里将其精简掉的部分写出来。
.globl coctx_swap

#if !defined( __APPLE__ ) && !defined( __FreeBSD__ )

.type  coctx_swap, @function

#endif

coctx_swap:

    //push %rbp  //将上个栈帧的基址压入栈中

    //movq %rsp,%rbp  //将rbp赋值为当前的栈顶的值,即开启了新的栈帧

    //保存当前工作线程的上下文

    leaq 8(%rsp),%rax

	leaq 112(%rdi),%rsp

	pushq %rax

	pushq %rbx

	pushq %rcx

	pushq %rdx

	pushq -8(%rax) //函数返回地址,即下一条指令的执行地址

	pushq %rsi

	pushq %rdi

	pushq %rbp

	pushq %r8

	pushq %r9

	pushq %r12

	pushq %r13

	pushq %r14

	pushq %r15

	//恢复下一个工作协程的上下文

	movq %rsi, %rsp

	popq %r15

	popq %r14

	popq %r13

	popq %r12

	popq %r9

	popq %r8

	popq %rbp

	popq %rdi

	popq %rsi

	popq %rax //函数返回地址,即下一条指令的执行地址

	popq %rdx

	popq %rcx

	popq %rbx

	popq %rsp

	pushq %rax

	xorl %eax, %eax

	//leaveq  该指令将rbp赋值给rsp,再弹出栈顶的上个栈帧的基址,并将其赋值给rbp寄存器,从而恢复上个栈帧调用该函数前的结构。相当于movq %ebp, %esp和popq %ebp两条指令

	ret //相当于popq %rip
最后再额外提一点,libco协程库的性能如何?其实可以看到其切换成本非常的低,每次切换只有三十多条指令。但真正影响切换性能的其实并不是这关键性的上下文切换代码,而是切换之后可能带来的cache缺失问题!要知道对于现在的cpu来说,一次总线周期已经足够cpu执行几十条指令了。关于cpu cache的知识,可以查看我的另一篇文章,从死循环说起。关于libco如何hook第三方库,实现无缝接入的原理,可以参考我的另一篇文章,libco hook原理简析。
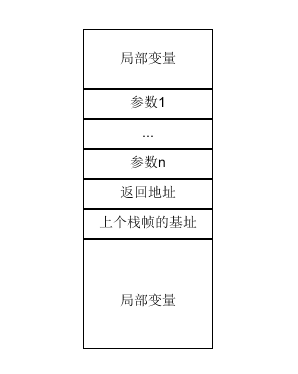
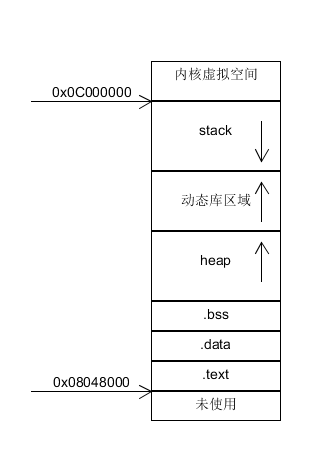
末尾附上c/cpp程序函数调用过程时的栈帧结构以及i386架构下的c/c++程序内存结构,辅助初学者理解。
此图为c/cpp程序的函数调用栈示意图,在x86_64架构下,当寄存器足够存放参数时,是不会对参数进行压栈的,因此参数1到n(对应函数参数列表是从右到左)是可选的,当把上个栈帧的基址压入栈中时,新的栈帧就开始了。
下图为32位系统(linux)下的c/cpp程序的内存结构简易图,32位系统寻址能力为4G,其中0x0C000000-0xFFFFFFFF为内核空间,用户空间只有3G,箭头标明了内存的增长方向,其中堆和动态库都是向上增长的,栈是向下增长的
libco协程原理简要分析的更多相关文章
- 腾讯libco协程原理
https://blog.csdn.net/GreyBtfly/article/details/83688420 堆栈 https://blog.csdn.net/lqt641/article/det ...
- libco协程库上下文切换原理详解
缘起 libco 协程库在单个线程中实现了多个协程的创建和切换.按照我们通常的编程思路,单个线程中的程序执行流程通常是顺序的,调用函数同样也是 “调用——返回”,每次都是从函数的入口处开始执行.而li ...
- Android中的Coroutine协程原理详解
前言 协程是一个并发方案.也是一种思想. 传统意义上的协程是单线程的,面对io密集型任务他的内存消耗更少,进而效率高.但是面对计算密集型的任务不如多线程并行运算效率高. 不同的语言对于协程都有不同的实 ...
- C打印函数printf的一种实现原理简要分析
[0]README 0.1)本文旨在对 printf 的 某一种 实现 原理进行分析,做了解之用: 0.2) vsprintf 和 printf.c 的源码,参见 https://github.com ...
- based on Greenlets (via Eventlet and Gevent) fork 孙子worker 比较 gevent不是异步 协程原理 占位符 placeholder (Future, Promise, Deferred) 循环引擎 greenlet 没有显式调度的微线程,换言之 协程
gevent GitHub - gevent/gevent: Coroutine-based concurrency library for Python https://github.com/gev ...
- loosejar原理简要分析
loosejar这个小工具能够动态分析出应用中有每一个jar包的实际使用情况,详情请參阅<通过loosejar清理应用中冗余的jar包>基本原理是利用instrumentation的特性用 ...
- 深入浅出!从语义角度分析隐藏在Unity协程背后的原理
Unity的协程使用起来比较方便,但是由于其封装和隐藏了太多细节,使其看起来比较神秘.比如协程是否是真正的异步执行?协程与线程到底是什么关系?本文将从语义角度来分析隐藏在协程背后的原理,并使用C++来 ...
- golang协程同步的几种方法
目录 golang协程同步的几种方法 协程概念简要理解 为什么要做同步 协程的几种同步方法 Mutex channel WaitGroup golang协程同步的几种方法 本文简要介绍下go中协程的几 ...
- 【吐血推荐】简要分析unity3d中剪不断理还乱的yield
在学习unity3d的时候很容易看到下面这个例子: void Start () { StartCoroutine(Destroy()); } IEnumerator Destroy(){ yield ...
随机推荐
- springboot使用aspectJ
添加springboot-aop的starter <dependency> <groupId>org.springframework.boot</groupId> ...
- OAuth2.0的四种授权模式(转)
1. OAuth2简易实战(一)-四种模式 1.1. 隐式授权模式(Implicit Grant) 第一步:用户访问页面时,重定向到认证服务器. 第二步:认证服务器给用户一个认证页面,等待用户授权. ...
- 【探索之路】机器人篇(1)-ROS-mwRobot开篇
机器人的定义 首先,什么才是机器人?机器人是不是必须和人一样的外形?我们先看一看维基百科给机器人的定义: 由上可见,机器人并不是和人一样的外形,而是可以模拟人类行为或者思想再或者是模拟其他生物的机械. ...
- CentOS 8 安装mysql8.0.21
1.使用dnf安装mysql(遇到暂停按y)dnf install @mysql 2.安装完成使用下面命令启动MySQL服务systemctl enable --now mysqld 3.查看服务是否 ...
- 柔性分布式事务关于异步解决方案MQ版
上述思想本质是 二阶段提交变体 1,2是prepare阶段 4是commit阶段 存在问题 MQ提供半消息支持 生产者提供消息回查功能 发送方多次半消息到MQSERVER 消费方会多次消费消息 生产 ...
- ShareSdk自己写的Demo
安卓原生Demo 根据mob发布的ShareSdk编写的demo,只添加了自己使用到的一些平台. 签名和第三方平台的账号都是用的shareSdk官方Demo的. 因为只是为了展示shareSdk用法, ...
- 【ASP.NET Core】Blazor 服务器端的 Base Path
提到 Blazor,没准就会有人问:选用 Server 端还是 WebAssembly(客户端)?其实这个不用纠结,老周个人的原则是:Server 端优先.理由很单纯:服务器端虽然消耗服务器上的资源, ...
- 1. 内存分区模型以及new、delete操作
C++程序在执行时,将内存大方向分为 4 个区域,不同区域存放的数据,赋予不同的生命周期,给我们更大的灵活编程 代码区:存放函数二进制代码,由操作系统进行管理 全局区:存放全局变量和静态数据以及常量, ...
- 两个很赞的用法(count函数里的表达式+计算时间间隔)
1.count函数里写表达式 #无效写法,这样写不会判断表达式(ischecked=0),会全部列出来 SELECT cardid FROM search_detail GROUP BY cardid ...
- 【C++】《C++ Primer 》第九章
第九章 顺序容器 一.顺序容器概述 顺序容器(sequential container):为程序员提供了控制元素存储和访问顺序的能力.这种顺序不依赖于元素的值,而是与元素加入容器时的位置相对应. 不同 ...