
[读书笔记] Python数据分析 (五) pandas入门
pandas: 基于Numpy构建的数据分析库
pandas数据结构:Series, DataFrame
Series: 带有数据标签的类一维数组对象(也可看成字典)
values, index
缺失数据检测:pd.isnull(), pd.notnull(), Series对象的实例方法
Series对象本身及其索引都有一个name属性,和pandas其他关键功能关系很密切
DataFrame: 表格型数据结构,列和行都有索引
获取DataFrame列:字典标记方式,或者属性方式(frame2['state']/frame2.state)
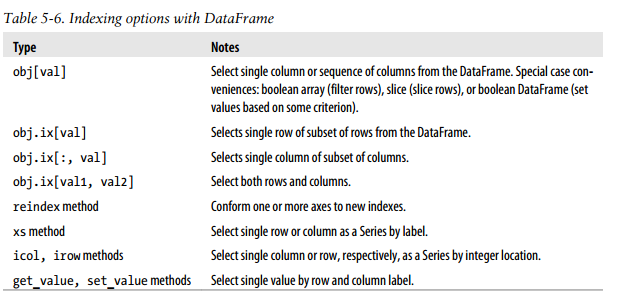
获取DataFrame行:ix()方法
通过索引方式返回的列只是相应的数据视图,而不是副本,Series的Copy方法可以显示地复制列
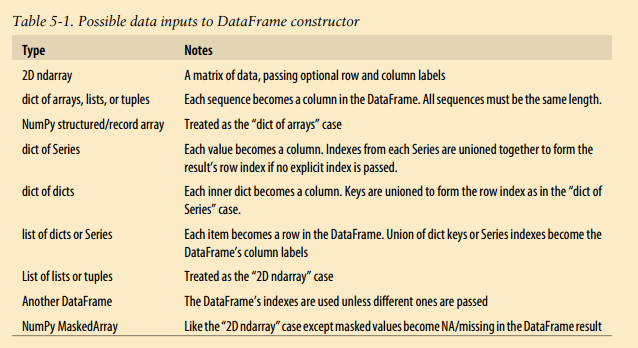
DataFrame的index和column也有name属性,可以自己设置
索引对象:pandas索引对象负责管理轴标签和其他元数据,构建Series或者DataFrame时,所用到的任何数组或者其他序列的标签会被转换成一个Index. Index对象是不可以修改(immutable)的.
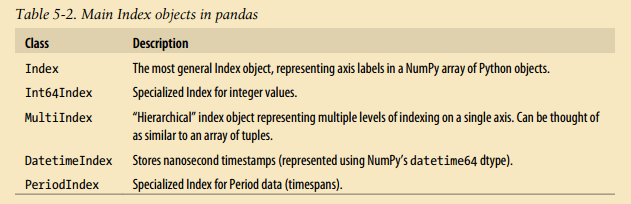
Index属性
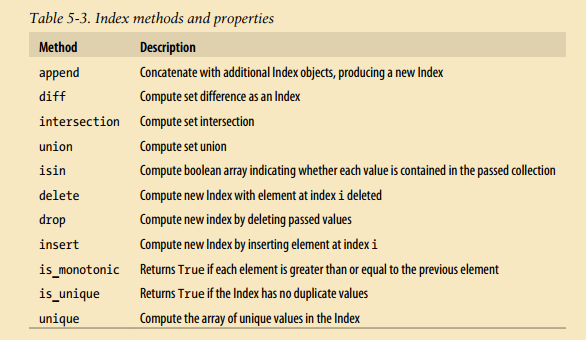
基本功能
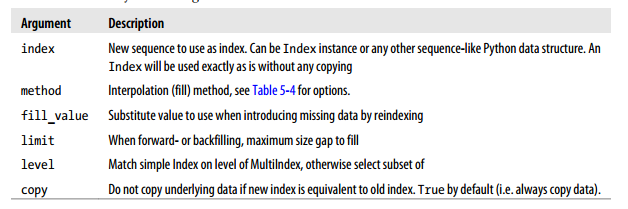
重新索引:创建一个适合新索引的对象reindex()
指定丢弃对象:drop()
索引选取和过滤:ix()
算术运算和数据对齐
pandas可以对不同索引对象进行算术运算,对不重叠值自动填充NA
在算术方法中填充值:fill_value
DataFrame和Series之间的运算:broadcast()
默认情况下DataFrame和Series之间的算术运算会将Series的索引匹配到DataFrame列,然后沿着行向下传播;如果想匹配行且在列上广播,必须使用算术运算方法
函数应用和映射
numpy的ufuncs(元素级数组方法),也可以用于操作pandas对象
DataFrame的apply()方法,可以将函数应用到行或者列形成的一维数组
排序和排名
排序:
sort_index() 对行或者列的索引排序(按照字典顺序)
sort_index(by = ) 按照一个或者多个列中值进行排序
Series按值进行排序, order方法
排名:
rank()
带有重复值的轴索引
索引的is_unique()属性可以告诉你它的值是否是唯一的
汇总和计算描述性统计
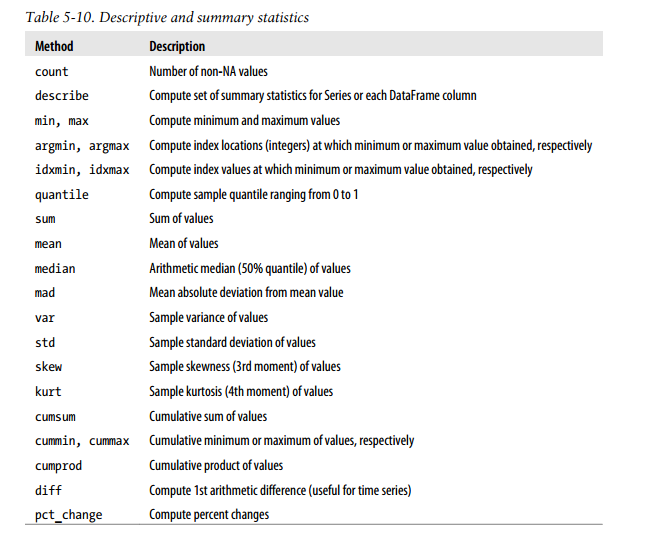
sum()
mean()
describe()
描述和汇总统计函数
相关系数和协方差
对参数对进行计算得到,Series和DataFrame方法
唯一值,值计数,以及成员资格
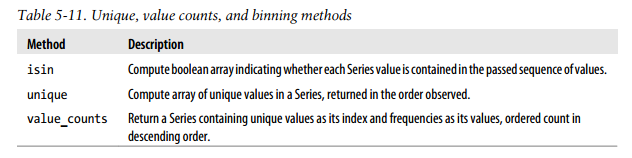
唯一值:unique()方法
值计数:value_counts()方法计算一个Series中各个值出现的频率
成员资格:isin, 用于判断矢量化集合的成员资格,可以选取Series或DataFrame列中数据的子集
处理缺失数据
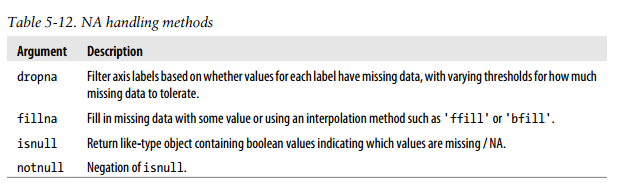
过滤缺失数据:dropna
对于DataFrame对象,dropna默认丢弃任何含有缺失值的行; dropna(how = 'all') 丢弃全为NA那些行.
如果是针对列,传入axis = 1便可
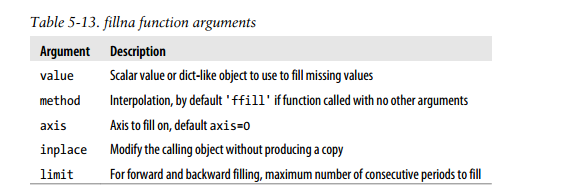
填充缺失数据:fillna
传入常数值:所有na被替换为常数值
传入字典:不同的列填充不同的值
默认返回新的对象,但是也可以就地修改 inplace = TRUE
层次化索引:数据重塑和基于分组的操作(透视表)
stack和unstack
对DataFrame来说,每条轴都可以有分层索引.
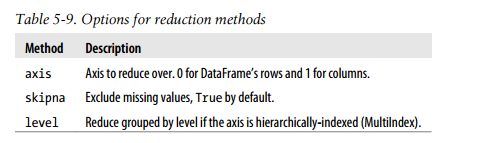
根据级别进行汇总:DataFrame和Series的描述和汇总统计都用一个level选项.
使用列作为行索引,将行索引变为DataFrame的列:set_index() 相反reset_index()
[读书笔记] Python数据分析 (五) pandas入门的更多相关文章
- Python数据分析之pandas入门
一.pandas库简介 pandas是一个专门用于数据分析的开源Python库,目前很多使用Python分析数据的专业人员都将pandas作为基础工具来使用.pandas是以Numpy作为基础来设计开 ...
- [读书笔记] Python数据分析 (二) 引言
1. 数据分析的任务:数据读写,数据准备(清洗,修整,规范化,重塑,切片切块,变形),转换,建模计算,呈现(模型/数据) 2. 数据集: bit.ly的1.usa.gov数据:URL缩短服务bit ...
- [读书笔记] Python数据分析 (一) 准备工作
1. python中数据结构:矩阵,数组,数据框,通过关键列相互联系的多个表(SQL主键,外键),时间序列 2. python 解释型语言,程序员时间和CPU时间衡量,高频交易系统 3. 全局解释器锁 ...
- [读书笔记] Python数据分析 (三) IPython
1. 什么是IPython IPyhton 本身没有提供任何的计算或者数据分析功能,在交互式计算和软件开发者两个方面最大化地提高生产力,execute-explore instead of edit- ...
- [读书笔记] Python数据分析 (四) 数组和矢量计算
Numpy:高性能计算和数学分析的基础包 ndarray, 一个具有矢量算术运算和复杂广播能力的快速且节省空间的多维数组 用于对数组数据进行快速运算的标准数学函数 用于读写磁盘数据的工具和用于操作内存 ...
- [读书笔记] Python 数据分析 (十一)经济和金融数据应用
resample: 重采样函数,可以按照时间来提高或者降低采样频率,fill_method可以使用不同的填充方式. pandas.data_range 的freq参数枚举: Alias Descrip ...
- [读书笔记] Python 数据分析 (八)画图和数据可视化
ipython3 --pyplot pyplot: matplotlib 画图的交互使用环境
- [读书笔记] Python 数据分析 (十二)高级NumPy
da array: 一个快速而灵活的同构多维大数据集容器,可以利用这种数组对整块的数据进行一些数学运算 数据指针,系统内存的一部分 数据类型 data type/dtype 指示数据大小的元组 str ...
- Python 数据处理库 pandas 入门教程
Python 数据处理库 pandas 入门教程2018/04/17 · 工具与框架 · Pandas, Python 原文出处: 强波的技术博客 pandas是一个Python语言的软件包,在我们使 ...
随机推荐
- [luogu2585 ZJOI2006] 三色二叉树 (树形dp)
传送门 Description Input 输入文件名:TRO.IN 输入文件仅有一行,不超过500000个字符,表示一个二叉树序列. Output 输出文件名:TRO.OUT 输出文件也只有一行,包 ...
- windows 查看端口号被占用
1.netstat -ano 2.tasklist | findstr xxx 3.进程管理杀掉
- flask_sqlalchemy和sqlalchemy联系区别及其使用方式
### 使用SQLAlchemy去连接数据库: 1.使用SQLALchemy去连接数据库,需要使用一些配置信息,然后将他们组合成满足条件的字符串:HOSTNAME = '127.0.0.1'PORT ...
- Hive sql
1.DDL操作 1.1 建表 CREATE [EXTERNAL] TABLE [IF NOT EXISTS] table_name [(col_name data_type [COMMENT col_ ...
- Problem 14
Problem 14 # Problem_14.py """ The following iterative sequence is defined for the se ...
- volatile可见性和指令重排
volatile关键字的2个作用 1.线程的可见性 2.防止指令重排 什么是线程的可见性? 线程的可见性 就是一个线程对一个变量进行更改操作 其他线程获取会获得最新的值. 线程在执行的行 操作主线程的 ...
- 《Javascript权威指南》学习笔记之十五:BOM之源---window对象
BOM是Browser Object Model的缩写,即浏览器对象模型,提供了独立于网页内容和浏览器窗体之间进行交互的APi.API由若干对象组成,因为浏览器是Javascript的宿主,因此,这些 ...
- 【iOS开发系列】UIDevice设备信息
[1] 推断是否是横向屏: BOOL b=UIDeviceOrientationIsLandscape([UIDevice currentDevice].orientation); 获取设备uniqu ...
- Java集合(二):List列表
在上一节中,介绍了Java集合的总体情况.从这节開始,将介绍详细的类.这里不单单介绍类的使用方法.还会试图从源代码的角度分析类的实现.这一节将介绍List接口及实现类.即列表中的链表LinkedLis ...
- DB-MySQL:MySQL 序列使用
ylbtech-DB-MySQL:MySQL 序列使用 1.返回顶部 1. MySQL 序列使用 MySQL 序列是一组整数:1, 2, 3, ...,由于一张数据表只能有一个字段自增主键, 如果你想 ...