
sklearn中pipeline的用法和FeatureUnion
一、pipeline的用法
pipeline可以用于把多个estimators级联成一个estimator,这么 做的原因是考虑了数据处理过程中一系列前后相继的固定流程,比如feature selection->normalization->classification
pipeline提供了两种服务:
- Convenience:只需要调用一次fit和predict就可以在数据集上训练一组estimators
- Joint parameter selection可以把grid search 用在pipeline中所有的estimators参数的参数组合上面
注意:Pipleline中最后一个之外的所有estimators都必须是变换器(transformers),最后一个estimator可以是任意类型(transformer,classifier,regresser)
如果最后一个estimator是个分类器,则整个pipeline就可以作为分类器使用,如果最后一个estimator是个聚类器,则整个pipeline就可以作为聚类器使用。

from sklearn.preprocessing import StandardScaler

from sklearn.decomposition import PCA

from sklearn.linear_model import LogisticRegression

from sklearn.pipeline import Pipeline

estimator=[('pca', PCA()),

           ('clf', LogisticRegression())

           ]

pipe=Pipeline(estimator)

print(pipe)

#Pipeline(steps=[('pca', PCA(copy=True, iterated_power='auto', n_components=None, random_state=None,svd_solver='auto', tol=0.0, whiten=False)), ('clf', LogisticRegression(C=1.0, class_weight=None, dual=False,fit_intercept=True,intercept_scaling=1, max_iter=100, multi_class='ovr', n_jobs=1,penalty='l2', random_state=None, solver='liblinear', tol=0.0001,verbose=0, warm_start=False))])

print(pipe.steps[0])

#('pca', PCA(copy=True, iterated_power='auto', n_components=None, random_state=None,  svd_solver='auto', tol=0.0, whiten=False))

print(pipe.named_steps['pca'])

#PCA(copy=True, iterated_power='auto', n_components=None, random_state=None,  svd_solver='auto', tol=0.0, whiten=False)
在pipeline中estimator的参数通过使用<estimator>__<parameter>语法来获取
#修改参数并打印输出

print(pipe.set_params(clf__C=10))

#Pipeline(steps=[('pca', PCA(copy=True, iterated_power='auto', n_components=None, random_state=None,svd_solver='auto', tol=0.0, whiten=False)), ('clf', LogisticRegression(C=10, class_weight=None, dual=False,fit_intercept=True,intercept_scaling=1, max_iter=100, multi_class='ovr', n_jobs=1,penalty='l2', random_state=None, solver='liblinear', tol=0.0001,verbose=0, warm_start=False))])
既然有参数的存在,就可以使用网格搜索方法来调节参数
from sklearn.model_selection import GridSearchCV

params=dict(pca__n_components=[2,5,10],clf__C=[0,1,10,100])

grid_research=GridSearchCV(pipe,param_grid=params)
单个阶段(step)可以用参数替换,而且非最后阶段还可以将其设置为None来忽略:
from sklearn.linear_model import LogisticRegression

params=dict(pca=[None,PCA(5),PCA(10)],clf=[SVC(),LogisticRegression()],

            clf_C=[0.1,10,100])

grid_research=GridSearchCV(pipe,param_grid=params)
函数make_pipeline是一个构造pipeline的简短工具,他接受可变数量的estimators并返回一个pipeline,每个estimator的名称自动填充。
from sklearn.pipeline import make_pipeline

from sklearn.naive_bayes import MultinomialNB

from sklearn.preprocessing import Binarizer

print(make_pipeline(Binarizer(),MultinomialNB()))

#Pipeline(steps=[('binarizer', Binarizer(copy=True, threshold=0.0)), ('multinomialnb', MultinomialNB(alpha=1.0, class_prior=None, fit_prior=True))])
FeatureUnion:composite(组合)feature spaces
FeatureUnion把若干个transformer objects组合成一个新的transformer,这个新的transformer组合了他们的输出,一个FeatureUnion对象接受一个transformer对象列表
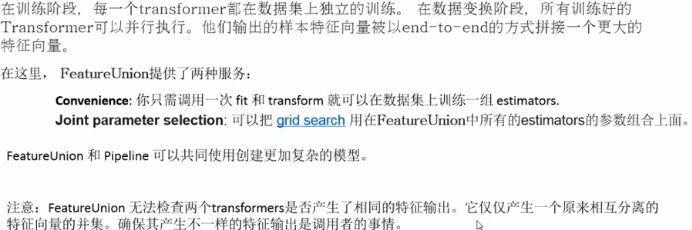
二、FeatureUnion 的用法
from sklearn.pipeline import FeatureUnion

from sklearn.decomposition import PCA

from sklearn.decomposition import KernelPCA

estimators=[('linear_pca',PCA()),('kernel_pca',KernelPCA())]

combined=FeatureUnion(estimators)

print(combined)

#FeatureUnion(n_jobs=1, transformer_list=[('linear_pca', PCA(copy=True, iterated_power='auto', n_components=None, random_state=None,  svd_solver='auto', tol=0.0, whiten=False)), ('kernel_pca', KernelPCA(alpha=1.0, coef0=1, copy_X=True, degree=3, eigen_solver='auto',     fit_inverse_transform=False, gamma=None, kernel='linear',     kernel_params=None, max_iter=None, n_components=None, n_jobs=1,  random_state=None, remove_zero_eig=False, tol=0))],transformer_weights=None)
与pipeline类似,feature union也有一种比较简单的构造方法:make_union,不需要显示的给每个estimator指定名称。
Featu热Union设置参数
#修改参数

print(combined.set_params(kernel_pca=None))

#FeatureUnion(n_jobs=1,transformer_list=[('linear_pca', PCA(copy=True, iterated_power='auto', n_components=None, random_state=None,svd_solver='auto', tol=0.0, whiten=False)), ('kernel_pca', None)],transformer_weights=None)
另外一篇讲pipleline不错的文章:http://blog.csdn.net/lanchunhui/article/details/50521648
sklearn中pipeline的用法和FeatureUnion的更多相关文章
- 利用sklearn的Pipeline简化建模过程
很多框架都会提供一种Pipeline的机制,通过封装一系列操作的流程,调用时按计划执行即可.比如netty中有ChannelPipeline,TensorFlow的计算图也是如此. 下面简要介绍skl ...
- sklearn中的Pipeline
在将sklearn中的模型持久化时,使用sklearn.pipeline.Pipeline(steps, memory=None)将各个步骤串联起来可以很方便地保存模型. 例如,首先对数据进行了PCA ...
- sklearn中的pipeline实际应用
前面提到,应用sklearn中的pipeline机制的高效性:本文重点讨论pipeline与网格搜索在机器学习实践中的结合运用: 结合管道和网格搜索以调整预处理步骤以及模型参数 一般地,sklearn ...
- 【笔记】多项式回归的思想以及在sklearn中使用多项式回归和pipeline
多项式回归以及在sklearn中使用多项式回归和pipeline 多项式回归 线性回归法有一个很大的局限性,就是假设数据背后是存在线性关系的,但是实际上,具有线性关系的数据集是相对来说比较少的,更多时 ...
- sklearn中的交叉验证(Cross-Validation)
这个repo 用来记录一些python技巧.书籍.学习链接等,欢迎stargithub地址sklearn是利用python进行机器学习中一个非常全面和好用的第三方库,用过的都说好.今天主要记录一下sk ...
- sklearn中的投票法
投票法(voting)是集成学习里面针对分类问题的一种结合策略.基本思想是选择所有机器学习算法当中输出最多的那个类. 分类的机器学习算法输出有两种类型:一种是直接输出类标签,另外一种是输出类概率,使用 ...
- (数据科学学习手札25)sklearn中的特征选择相关功能
一.简介 在现实的机器学习任务中,自变量往往数量众多,且类型可能由连续型(continuou)和离散型(discrete)混杂组成,因此出于节约计算成本.精简模型.增强模型的泛化性能等角度考虑,我们常 ...
- sklearn中的数据预处理和特征工程
小伙伴们大家好~o( ̄▽ ̄)ブ,沉寂了这么久我又出来啦,这次先不翻译优质的文章了,这次我们回到Python中的机器学习,看一下Sklearn中的数据预处理和特征工程,老规矩还是先强调一下我的开发环境是 ...
- sklearn中的多项式回归算法
sklearn中的多项式回归算法 1.多项式回归法多项式回归的思路和线性回归的思路以及优化算法是一致的,它是在线性回归的基础上在原来的数据集维度特征上增加一些另外的多项式特征,使得原始数据集的维度增加 ...
随机推荐
- 【Java架构:基础技术】一篇文章搞掂:Eclipse
Eclipse中使用SVN 1.打开资源库视图 https://www.cnblogs.com/liangguangqiong/p/7965770.html 一.编辑器方面 格式化取消自动换行:打开E ...
- web开发调用百度地图API + AK申请
web开发调用百度地图API + AK申请 要使用百度地图的API我们首先需要在我们的html页面引入js----`` 如何获取百度地图ak: 1.登陆百度地图开发者平台 2.注册百度开发者账号并登陆 ...
- 机器学习技法笔记:Homework #7 Decision Tree&Random Forest相关习题
原文地址:https://www.jianshu.com/p/7ff6fd6fc99f 问题描述 程序实现 13-15 # coding:utf-8 # decision_tree.py import ...
- 广度优先搜索(Breadth First Search)
Date:2019-07-03 14:29:02 走完一层的所有房间,再走下一层,用队列实现 算法实现 /*--------------------------模版------------------ ...
- 20140806 交换两个数 extern “C”用法
1.交换两个数 方法1.a+b有可能越界 a=a+b; b=a-b; a=a-b; 方法二.不会越界 a=a^b b=a^b; a=a^b; 2.extern "C"用法 ( ...
- Java 中 Properties 类的操作
一.Java Properties类 Java中有个比较重要的类Properties(Java.util.Properties),主要用于读取Java的配置文件,各种语言都有自己所支持的配置文件,配置 ...
- scala 实现算法
快速排序 def sort(xs: Array[Int]): Array[Int] = if (xs.length <= 1) xs else { val pivot = xs(xs.lengt ...
- P3224 [HNOI2012]永无乡(平衡树合并)
题目描述 永无乡包含 nn 座岛,编号从 11 到 nn ,每座岛都有自己的独一无二的重要度,按照重要度可以将这 nn 座岛排名,名次用 11 到 nn 来表示.某些岛之间由巨大的桥连接,通过桥可以从 ...
- swagger使用详解
1:认识Swagger Swagger 是一个规范和完整的框架,用于生成.描述.调用和可视化 RESTful 风格的 Web 服务.总体目标是使客户端和文件系统作为服务器以同样的速度来更新.文件的方法 ...
- vue 路由传参中刷新页面参数丢失 及传参的几种方式?
在页面跳转中,我通过路由传参,结果发现页面参数丢失了.路径返回了根目录.... 1. 先说下路由传参的几种方式吧? 比如:<div v-for="item in items" ...