
Spark在Yarn上运行Wordcount程序
前提条件
1.CDH安装spark服务
2.下载IntelliJ IDEA编写WorkCount程序
3.上传到spark集群执行
一.下载IntellJ IDEA编写Java程序
1.下载IDEA
官网地址:http://www.jetbrains.com/idea/ 下载IntlliJ IDEA后,进行安装。
2.新建Java项目
1.点击File
2.点击New Project
3.点击Java
注意:Project SDK要选择本机安装的JDK的位置,由于我的JDK是1.7,所以下面的Java EE version我选择的是Java EE 7
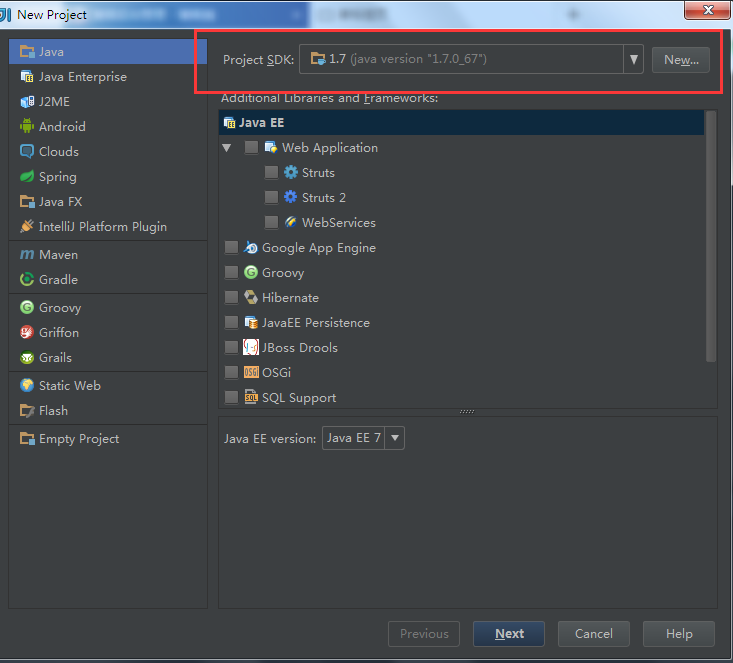
4.点击Next后,出现如下界面,勾选Create project from template,然后点击Next

5.点击Next,填写相应的项目名称,package等相关信息
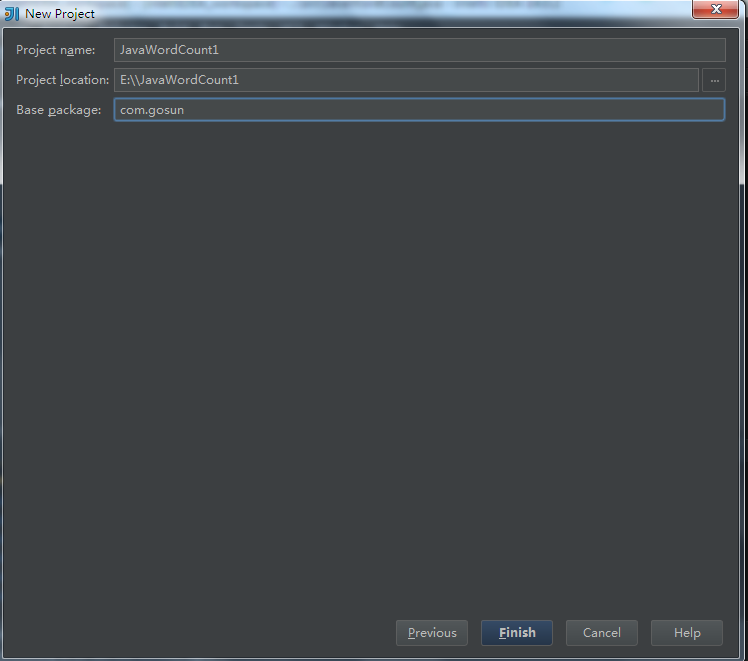
6.点击Finish,,出现如下界面,右键选择Refactor->Rename修改类名为自己想要的类名即可。

7.添加spark-assembly-1.3.0-cdh5.4.2-hadoop2.6.0-cdh5.4.2.jar到项目中
7.1创建名称为lib的目录

7.2将spark-assembly-1.3.0-cdh5.4.2-hadoop2.6.0-cdh5.4.2.jar (在spark集群的位置为:/usr/lib/spark/assembly/lib目录下)copy到lib目录下
然后右键点击jar包选择add Library,完成该动作后,在项目中就可以引用此jar包中的类了。
8.用Java实现WordCount功能
import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaPairRDD;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.FlatMapFunction;

import org.apache.spark.api.java.function.Function2;

import org.apache.spark.api.java.function.PairFunction;

import scala.Tuple2;

import java.util.Arrays;

import java.util.List;

import java.util.regex.Pattern;

public final class JavaWordCount {

    private static final Pattern SPACE = Pattern.compile(" ");

    public static void main(String[] args) {

       if(args.length<1){

           System.err.print("Usage:JavaWordCount<file>");

           System.exit(1);

       }

        SparkConf sparkConf = new SparkConf().setAppName("JavaWordCount");

        JavaSparkContext ctx = new JavaSparkContext(sparkConf);

        JavaRDD<String> lines = ctx.textFile(args[0],1);

        System.out.println(System.getenv("SPARK_HOME"));

        JavaRDD<String> words = lines.flatMap(new FlatMapFunction<String, String>() {

            @Override

            public Iterable<String> call(String s) throws Exception {

               return Arrays.asList(SPACE.split(s));

            }

        });

        JavaPairRDD<String,Integer> ones = words.mapToPair(new PairFunction<String, String, Integer>() {

            @Override

            public Tuple2<String, Integer> call(String s) throws Exception {

                return new Tuple2<String, Integer>(s,1);

            }

        });

        JavaPairRDD<String,Integer> counts = ones.reduceByKey(new Function2<Integer, Integer, Integer>() {

            @Override

            public Integer call(Integer i1, Integer i2) throws Exception {

                return i1+i2;

            }

        });

        List<Tuple2<String, Integer>> output = counts.collect();

        for (Tuple2<?, ?> tuple : output) {

               System.out.println(tuple._1() + ": " + tuple._2());

        }

        ctx.stop();

    }

}
9.打成jar包
9.1点击File
9.2选择Project Structure
9.3选择Artifacts
可修改右边Name生成jar包的名称
9.4点击OK,完成生成jar包,可在对应的目录下找到刚才生成的jar包
10.将生成的jar包上传到spark某个目录下
11.spark-submit --master yarn-client --name JavaWordCount --class JavaWordCount --executor-memory 1G --total-executor-cores 2 /etc/spark/JavaWordCount.jar hdfs://master:8020/suajing/install.log
其中,红色标注部分根据实际的项目进行修改,
我的项目名称为JavaWordCount,则--name 为JavaWordCount,
我的Class没有pacakage,如果你的class是在某个pacakage底下,则需要将class修改成包+类名全路径,例如:com.gosun.JavaWordCount。
我的jar包放在/etc/spark/目录下,写成/etc/spark/JavaWordCount.jar
hdfs上的文件路径为上面所示。
12.执行结果:未报错就表示执行成功了,可以看到如下统计的结果

Spark在Yarn上运行Wordcount程序的更多相关文章
- Spark源码编译并在YARN上运行WordCount实例
在学习一门新语言时,想必我们都是"Hello World"程序开始,类似地,分布式计算框架的一个典型实例就是WordCount程序,接触过Hadoop的人肯定都知道用MapRedu ...
- Hadoop 系列文章(三) 配置部署启动YARN及在YARN上运行MapReduce程序
这篇文章里我们将用配置 YARN,在 YARN 上运行 MapReduce. 1.修改 yarn-env.sh 环境变量里的 JAVA_HOME 路径 [bamboo@hadoop-senior ha ...
- Hadoop YARN上运行MapReduce程序
(1)配置集群 (a)配置hadoop-2.7.2/etc/hadoop/yarn-env.sh 配置一下JAVA_HOME export JAVA_HOME=/home/hadoop/bigdata ...
- 在Spark上运行WordCount程序
1.编写程序代码如下: Wordcount.scala package Wordcount import org.apache.spark.SparkConf import org.apache.sp ...
- Yarn上运行spark-1.6.0
目录 目录 1 1. 约定 1 2. 安装Scala 1 2.1. 下载 2 2.2. 安装 2 2.3. 设置环境变量 2 3. 安装Spark 2 3.1. 下载 2 3.2. 安装 2 3.3. ...
- 将java开发的wordcount程序提交到spark集群上运行
今天来分享下将java开发的wordcount程序提交到spark集群上运行的步骤. 第一个步骤之前,先上传文本文件,spark.txt,然用命令hadoop fs -put spark.txt /s ...
- Apache Spark源码走读之10 -- 在YARN上运行SparkPi
y欢迎转载,转载请注明出处,徽沪一郎. 概要 “spark已经比较头痛了,还要将其运行在yarn上,yarn是什么,我一点概念都没有哎,再怎么办啊.不要跟我讲什么原理了,能不能直接告诉我怎么将spar ...
- [Spark Core] 在 Spark 集群上运行程序
0. 说明 将 IDEA 下的项目导出为 Jar 包,部署到 Spark 集群上运行. 1. 打包程序 1.0 前提 搭建好 Spark 集群,完成代码的编写. 1.1 修改代码 [添加内容,判断参数 ...
- Spark standalone简介与运行wordcount(master、slave1和slave2)
前期博客 Spark standalone模式的安装(spark-1.6.1-bin-hadoop2.6.tgz)(master.slave1和slave2) Spark运行模式概述 1. Stan ...
随机推荐
- 解决(空密码的root)提示修改phpmyadmin用户密码
打开 phpmyadmin数据表,点击权限 如果没有,请参考:http://jingyan.baidu.com/article/636f38bb293a9bd6b846100d.html 创建 在 ...
- Shell 编程基础之 Select 练习
一.语法 select 变量 in con1 con2 con3 # 自动列出 con1,con2,con3 的选择菜单 do #执行内容 break # select本身就是一个循环,break是当 ...
- matlab中各种高斯相关函数
matlab中各种高斯相关函数 matlab, 高斯函数, 高斯分布 最常见的是产生服从一维标准正态分布的随机数 n=100; x=randn(1,n) 实现服从任意一维高斯分布的随机数 u=10 ...
- 【原】iOS学习之卸载Openfire
在即时通信编程中,你的Openfire服务可能因为各种不同的原因,出现不能使用.无法连接等问题. 解决这类问题最直接和省时间的方式就是卸载后重装,本篇主要为大家介绍如何卸载Openfire. 首先,确 ...
- BZOJ4117 : [Wf2015]Weather Report
一种天气情况的概率只与4种天气的出现次数有关,故将相同概率的情况计数后放入堆中模拟哈夫曼树即可. 每次取出概率最小的,将它个数除以2,对于零头需要特判. #include<cstdio> ...
- 【BZOJ1426】收集邮票 期望
[BZOJ1426]收集邮票 Description 有n种不同的邮票,皮皮想收集所有种类的邮票.唯一的收集方法是到同学凡凡那里购买,每次只能买一张,并且买到的邮票究竟是n种邮票中的哪一种是等概率的, ...
- 使用Jaxb2进行xml与bean的转义时Date的format设置
参考http://jackyrong.iteye.com/blog/1826699 JAXB转换JAVA OBJECT到XML的时候,对java.util.Date的转换有些要注意的地方 输出的格式为 ...
- React.js 常用技术要点
最近在公司的一个移动端WEB产品中使用了React这个框架(并不是React-Native),记录一下在开发过程中遇到的各种问题以及对应的解决方法,希望能对读者有所帮助. React原则 React不 ...
- topcoder SRM 623 DIV2 CatchTheBeatEasy
比较简单的一题,纠结比较久的是把my_cmp和my_minus放在类中,利用sort函数会出现 no matching function for call to ""sort(st ...
- 巧用translate设置元素垂直水平居中
之前在做手机项目时,用到很多自定义弹窗,然后要求都垂直水平要居中,最开始的时候想用calc来计算,可是css3 的calc兼容性不是很好,于是后来就借助了js来计算, 今天偶然看到别人的一个方法,瞬间 ...