
Python 2.7_利用xpath语法爬取豆瓣图书top250信息_20170129
大年初二,忙完家里一些事,顺带有人交流爬取豆瓣图书top250
1、构造urls列表 urls=['https://book.douban.com/top250?start={}'.format(str(i) for i in range(0, 226, 25))]
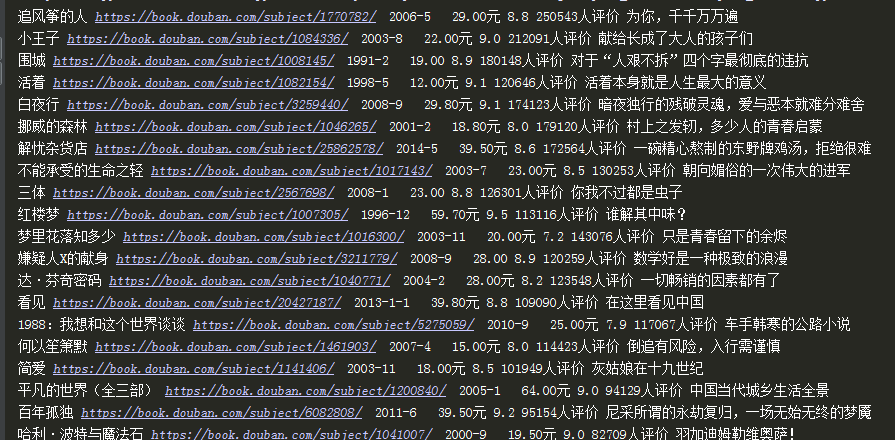
2、模块 requests获取网页源代码 lxml 解析网页 xpath提取
3、提取信息
4、可以封装成函数 此处没有封装调用
python代码:
#coding:utf-8

import sys

reload(sys)

sys.setdefaultencoding('utf-8')

from lxml import etree

import requests

urls=['https://book.douban.com/top250?start={}'.format(str(i) for i in range(0, 226, 25))]

for url in urls:

    html=requests.get(url).content

    selector=etree.HTML(html)

    infos=selector.xpath('//tr[@class="item"]')

    for info in infos:

        book_name = info.xpath('td/div/a/@title')[0]

        book_url = info.xpath('td/div/a/@href')[0]

        published_infos = str(info.xpath('td/p/text()')[0])

        splitlistinfos = published_infos.split('/')

        #print splitlistinfos

        published_date=str(splitlistinfos[-2])

        #print published_date

        price = str(splitlistinfos[-1])

        #print price

        rate = info.xpath('td/div/span[2]/text()')[0]

        # comment_nums = info.xpath('td/div/span[3]/text()')[0]

        # print comment_nums

        comment_nums = info.xpath('td/div/span[3]/text()')[0].strip('(').strip().strip(')').strip().strip('人评价').strip() +'人评价'

        introduceinfo = info.xpath('td/p/span/text()')

        print book_name,book_url,published_date,price,rate,comment_nums,introduceinfo[0] if len(introduceinfo) > 0 else ''
Python 2.7_利用xpath语法爬取豆瓣图书top250信息_20170129的更多相关文章
- python系列之(3)爬取豆瓣图书数据
上次介绍了beautifulsoup的使用,那就来进行运用下吧.本篇将主要介绍通过爬取豆瓣图书的信息,存储到sqlite数据库进行分析. 1.sqlite SQLite是一个进程内的库,实现了自给自足 ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
- Python爬虫-爬取豆瓣图书Top250
豆瓣网站很人性化,对于新手爬虫比较友好,没有如果调低爬取频率,不用担心会被封 IP.但也不要太频繁爬取. 涉及知识点:requests.html.xpath.csv 一.准备工作 需要安装reques ...
- 爬取豆瓣电影Top250信息
# -*- coding:utf-8 -*- __author__ = "MuT6 Sch01aR" import requests from pyquery import PyQ ...
- python爬虫1——获取网站源代码(豆瓣图书top250信息)
# -*- coding: utf-8 -*- import requests import re import sys reload(sys) sys.setdefaultencoding('utf ...
- Python爬虫小白入门(七)爬取豆瓣音乐top250
抓取目标: 豆瓣音乐top250的歌名.作者(专辑).评分和歌曲链接 使用工具: requests + lxml + xpath. 我认为这种工具组合是最适合初学者的,requests比pytho ...
- python 爬虫&爬取豆瓣电影top250
爬取豆瓣电影top250from urllib.request import * #导入所有的request,urllib相当于一个文件夹,用到它里面的方法requestfrom lxml impor ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
随机推荐
- OC源文件扩展名
常见的文件扩展名 扩展名 含义 扩展名 含义 .c C语言源文件 .mm Objective-C++源文件 .cc..cpp C++源文件 .pl Perl源文件 .h 头文件 .o Object(编 ...
- Vuex mapGetters,mapActions
一.基本用法 1. 初始化并创建一个项目 ? 1 2 3 vue init webpack-simple vuex-demo cd vuex-demo npm install 2. 安装 vuex ? ...
- github资源下载速度慢的解决办法
xx-net:https://github.com/XX-net/XX-Net
- Linux Shell基础 Shell的输入重定向和输出重定向
概述 在 Linux 中输入设备指的是键盘,输出设备指的是显示器.在 Linux 中,所有的内容都是文件,计算机硬件也是文件,标准输入设备(键盘)和标准输出设备(显示器)也是文件.这些设备的设备文件名 ...
- cocos2d关于glew32.lib错误(转)
应项目需要使用cocos2d-x开发,又要学习新东东了.·cocos2d-x 是一个支持多平台的 2D 手机游戏引擎,用C++重写cocos2d-iphone引擎的一个开源项目,想了解更多的童鞋美去百 ...
- mybatis collection 一对多关联查询,单边分页的问题总结!
若想直接通过sql实现多级关联查询表结构得有2 个必不可少的字段:id ,parentId,levelId id:主键id, parentId:父id levelId:表示第几级(表本身关联查询的时候 ...
- MongoDB的Find详解(一)
1.指定返回的键 db.[documentName].find ({条件},{键指定}) 数据准备persons.json var persons = [{name:"jim",a ...
- linux+udp+server+client
一.客户端 #include<sys/types.h> #include<sys/socket.h> #include<netinet/in.h> #include ...
- INSPIRED启示录 读书笔记 - 第40章 最佳实践经验
十大要点 1.产品管理的职责:许多产品经理将大把的时间浪费在与产品管理无关的工作上 2.用户体验:对于大多数软件产品来说,用户体验就是产品的生命 3.机会评估:用方便快捷的机会评估方法取代过时的市场需 ...
- Pandas的 loc iloc ix 区别
先看代码: In [46]: import pandas as pd In [47]: data = [[1,2,3],[4,5,6]] In [48]: index = [0,1] In [49]: ...