
Python爬取imdb电影数据并存储到mysql数据库
数据获取方式:微信搜索关注【靠谱杨阅读人生】回复【电影】。
整理不易,资源付费,谢谢支持。
Python爬虫代码:
  1 import re

  2 import time

  3 import traceback

  4

  5 from bs4 import BeautifulSoup

  6 from lxml import etree

  7 import pymysql

  8 import requests

  9 #连接数据库  获取游标

 10 def get_conn():

 11     """

 12     :return: 连接,游标

 13     """

 14     # 创建连接

 15     conn = pymysql.connect(host="82.157.112.34",

 16                     user="root",

 17                     password="root",

 18                     db="MovieRankings",

 19                     charset="utf8")

 20     # 创建游标

 21     cursor = conn.cursor()  # 执行完毕返回的结果集默认以元组显示

 22     if ((conn != None) & (cursor != None)):

 23         print("数据库连接成功!游标创建成功!")

 24     else:

 25         print("数据库连接失败!")

 26     return conn, cursor

 27 #关闭数据库连接和游标

 28 def close_conn(conn, cursor):

 29     if cursor:

 30         cursor.close()

 31     if conn:

 32         conn.close()

 33     return 1

 34 def get_imdb():

 35

 36     # url='https://www.imdb.cn/feature-film/1-0-0-0/?page=1'

 37     headers={

 38         'user-agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36'

 39     }

 40     dataRes=[]      #最终结果集

 41     temp_list=[]        #暂时结果集

 42

 43     # print(all_li)

 44

 45     for i in range(200,202):

 46             url_='https://www.imdb.cn/feature-film/1-0-0-0/?page='+str(i)

 47             response = requests.get(url=url_, headers=headers)

 48             # print(response)

 49             response.encoding = 'utf-8'

 50             page_text = response.text

 51             # print(page_text)

 52             etree_ = etree.HTML(page_text)

 53             all_li = etree_.xpath('//div[@class="hot_box"]/ul/li')      #获取所有li

 54             #判断all_li是否为空

 55             if(len(all_li)==0):

 56                 print("爬取结束,all_list为空!")

 57                 if(len(dataRes)!=0):

 58                     return dataRes;

 59                 else:

 60                     return ;

 61             print(url_)

 62             for li in all_li:

 63                 name=li.xpath('./a[1]/img/@alt')

 64                 if(len(name)==0):

 65                     name.append("电影名错误")

 66                 # print(name)

 67                 #存姓名

 68                 temp_list.append(name[0])

 69

 70                 score=li.xpath('./span[@class="img_score"]/@title')

 71                 if(len(score)==0):

 72                     score.append("imdb暂无评分")

 73                 # print(score)

 74                 #存分数

 75                 temp_list.append(score[0])

 76                 # print(temp_list)

 77                 #存到dataRes 把temp_list置为空

 78                 dataRes.append(temp_list)

 79                 temp_list=[]

 80             print(dataRes)

 81     return dataRes

 82 def insert_imdb():

 83     """

 84         插入imdb数据

 85         :return:

 86         """

 87     cursor = None

 88     conn = None

 89     try:

 90         list_=[]

 91         list = get_imdb()

 92         if(type(list)!=type(list_)):

 93             return ;

 94         print(f"{time.asctime()}开始插入imdb数据")

 95         conn, cursor = get_conn()

 96         sql = "insert into movieimdb (id,name,score) values(%s,%s,%s)"

 97         for item in list:

 98             try:

 99                 print(item)

100                 cursor.execute(sql, [0, item[0], item[1]])

101             except pymysql.err.IntegrityError:

102                 print("重复!跳过!")

103             conn.commit()  # 提交事务 update delete insert操作

104             print(f"{time.asctime()}插入imdb数据完毕")

105     finally:

106         close_conn(conn, cursor)

107     return;

108 # def get_dblen():

109 #     conn,cursor=

110 #     num_=

111

112 if __name__ == '__main__':

113     # get_imdb()

114     insert_imdb()

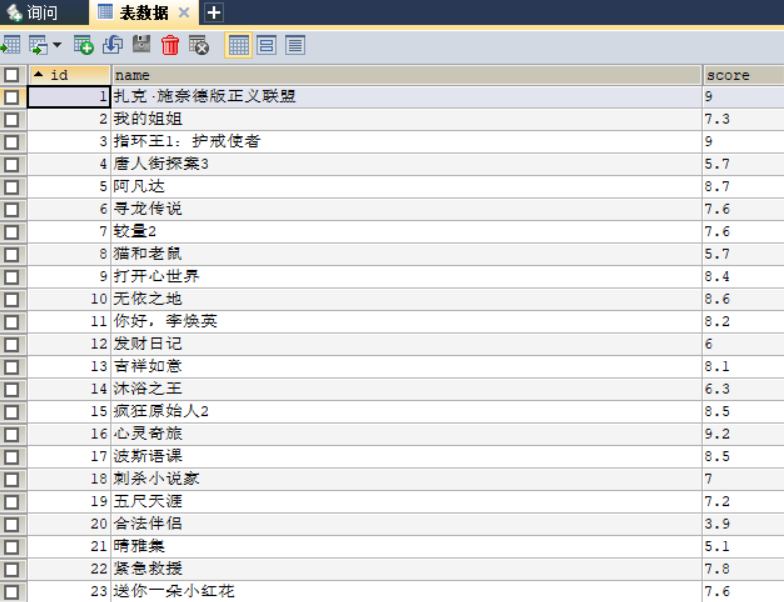
数据库
Python爬取imdb电影数据并存储到mysql数据库的更多相关文章
- Python爬取招聘信息,并且存储到MySQL数据库中
前面一篇文章主要讲述,如何通过Python爬取招聘信息,且爬取的日期为前一天的,同时将爬取的内容保存到数据库中:这篇文章主要讲述如何将python文件压缩成exe可执行文件,供后面的操作. 这系列文章 ...
- 爬取豆瓣电影top250并存储到mysql数据库
import requests from lxml import etree import re import pymysql import time conn= pymysql.connect(ho ...
- node 爬虫 --- 将爬取到的数据,保存到 mysql 数据库中
步骤一:安装必要模块 (1)cheerio模块 ,一个类似jQuery的选择器模块,分析HTML利器. (2)request模块,让http请求变的更加简单 (3)mysql模块,node连接mysq ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- Python爬取豆瓣电影top
Python爬取豆瓣电影top250 下面以四种方法去解析数据,前面三种以插件库来解析,第四种以正则表达式去解析. xpath pyquery beaufifulsoup re 爬取信息:名称 评分 ...
- 利用Python爬取朋友圈数据,爬到你开始怀疑人生
人生最难的事是自我认知,用Python爬取朋友圈数据,让我们重新审视自己,审视我们周围的圈子. 文:朱元禄(@数据分析-jacky) 哲学的两大问题:1.我是谁?2.我们从哪里来? 本文 jacky试 ...
- python 爬取豆瓣电影评论,并进行词云展示
python 爬取豆瓣电影评论,并进行词云展示 本文旨在提供爬取豆瓣电影<我不是药神>评论和词云展示的代码样例 1.分析URL 2.爬取前10页评论 3.进行词云展示 1.分析URL 我不 ...
- python 爬取猫眼电影top100数据
最近有爬虫相关的需求,所以上B站找了个视频(链接在文末)看了一下,做了一个小程序出来,大体上没有修改,只是在最后的存储上,由txt换成了excel. 简要需求:爬虫爬取 猫眼电影TOP100榜单 数据 ...
- python爬取豆瓣电影信息数据
题外话+ 大家好啊,最近自己在做一个属于自己的博客网站(准备辞职回家养老了,明年再战)在家里 琐事也很多, 加上自己 一回到家就懒了(主要是家里冷啊! 广东十几度,老家几度,躲在被窝瑟瑟发抖,) 由于 ...
- python爬虫-爬取豆瓣电影数据
#!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:27# 文件 :spider_05.py# IDE :PyChar ...
随机推荐
- redis7源码分析:redis 启动流程
1. redis 由 server.c 的main函数启动 int main(int argc, char **argv) { ... // 上面的部分为读取配置和启动命令参数解析,看到这一行下面为启 ...
- Flutter学习(PV)——概览
接触flutter有一段时间了,趁着刚过完年有点时间,记录一些有用的东西,一方面给自己备忘,另一方面也希望能帮到有需要的人~ 一.什么是flutter Flutter is Google's UI t ...
- 记录问题:goland无法识别sdk的问题
goland版本:2020 go版本:1.20.3最新版 在goland中配置GOROOT时找不到sdk 解决版本: > cd /usr/local/go # 我本地go的安装目录 > c ...
- 擅长使用iter
def populate_ranks(votes, ranks): names = list(votes.keys()) names.sort(key=votes.get, reverse=True) ...
- Rust 登上了开源头条「GitHub 热点速览」
抱歉!上周因为出月刊工作量比较大,所以「GitHub 热点速递」暂停了一期,必须要给守着更新的读者道个歉,以后每周二的「热点速递」会按时更新,下不为例. 说回本周的热门开源项目,Rust 语言可谓是出 ...
- Android\C++\C#\Java
关于:(38条消息) 千万不能错过的Android NDK下载安装及配置_石子君的博客-CSDN博客_android ndk下载 (38条消息) Android扩展知识 - so文件生成及其使用_L- ...
- Java 构造器(构造方法)练习
1 package com.bytezero.triangle; 2 3 public class TriAngle 4 { 5 //私有属性 6 private double base; //边长 ...
- nginx proxy_set_header详解
proxy_set_header 是 Nginx 配置中的一个重要指令,特别是在使用 Nginx 作为反向代理时.该指令允许你修改由 Nginx 传递给代理后端的请求头.这对于确保后端应用程序能够接收 ...
- FastWiki v0.1.0发布!新增超多功能
FastWiki 发布 v0.1.0 https://github.com/239573049/fast-wiki/releases/tag/v0.1.0 更新日志 兼容OpenAI接口格式 删除Bl ...
- 基于恒玄WT250芯片的蓝牙辅听耳机方案调试总结
前记 在蓝牙辅听领域卷了几年之后.各种型号的蓝牙辅听器都做过.这次,客户需要一款性价比超高的蓝牙辅听器.经过成本以及功能考量的筛选.最终定下来使用wt250来做一款低成本的蓝牙辅听器. 硬件部分 wt ...