
大数据应用期末总评(hadoop综合大作业)
作业要求源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363
一、将爬虫大作业产生的csv文件上传到HDFS
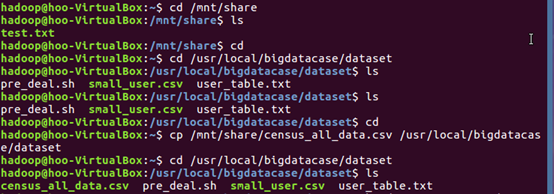
(1)在/usr/local路径下创建bigdatacase目录,bigdatacase下创建dataset目录,再在 windows 通过共享文件夹将爬取的census_all_data.csv文件传进 Ubuntu ,使用cp命令讲census_all_data.csv文件复制到/usr/local/bigdatacase/dataset目录下。
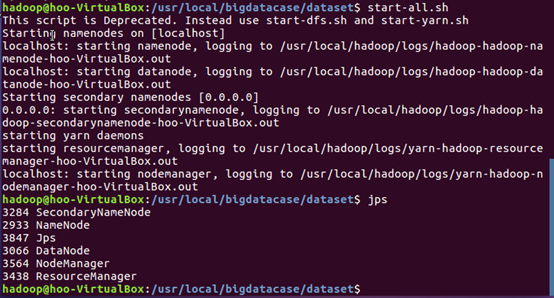
(2)启动服务并用jps命令查看服务启动情况。
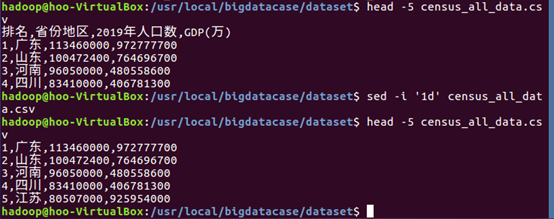
(3)查看文件前五条信息,使用sed命令去掉census_all_data.csv文件的第一行数据,再次查看文件前五条信息。
(4)创建hive目录,将census_all_data.csv文件上传到HDFS。

二、对CSV文件进行预处理生成无标题文本文件
(1)编辑pre_deal_census.sh预处理文件。

(2)pre_deal_census.sh预处理文件内容。
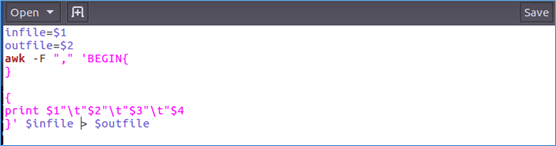
(3)对census_all_data.csv文件进行预处理并生成结果文件census_all_data.txt。

(4)查看处理结果,查看census_all_data.txt文件前十条信息。


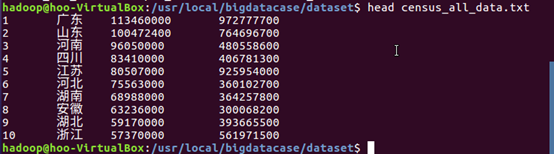
三、把hdfs中的文本文件最终导入到数据仓库Hive中
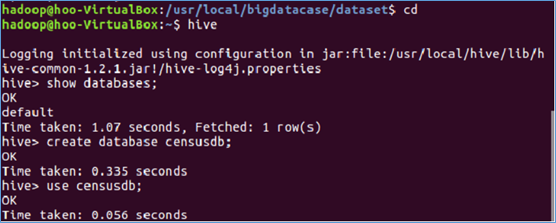
(1)进入数据仓库 hive ,创建并使用censusdb数据库。
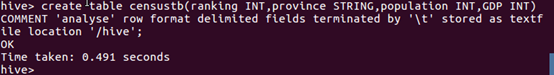
(2)创建表censustb,并为其指定census_all_data.txt文件上传路径为 /hive,将HDFS中的census_all_data.csv文件导入数据仓库hive中。
四、在Hive中查看并分析数据
(1)sql语句查询表censustb所有省份名。
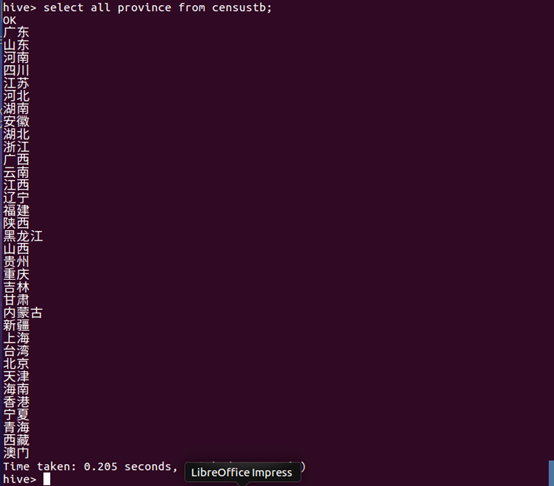
数据分析:censustb表已经按省份的人口数量从大到小排好了序,从查询结果可以看到,我国人口数量最多的省份地区是广东,人口数量最少的省份地区是澳门。
(2)sql语句查询表censustb的前10条信息。
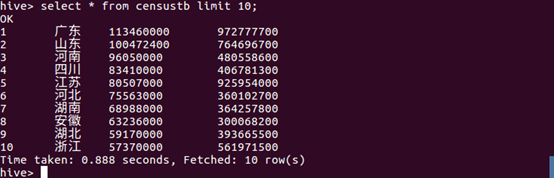
数据分析:从查询结果可知,省份的GDP值与省份的人口数量具有一定的正相关性。
(3)查询censustb表中的信息数量。
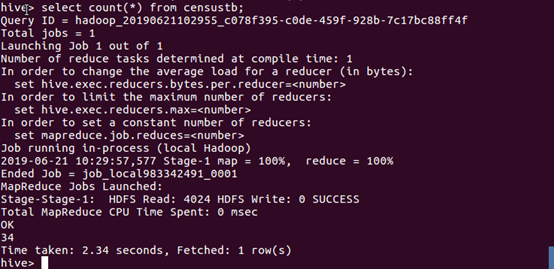
数据分析:从结果可以看出,我国共有34个省级行政区域。
(4)将censustb表排降序,并显示前十条信息中的province和GDP数据。
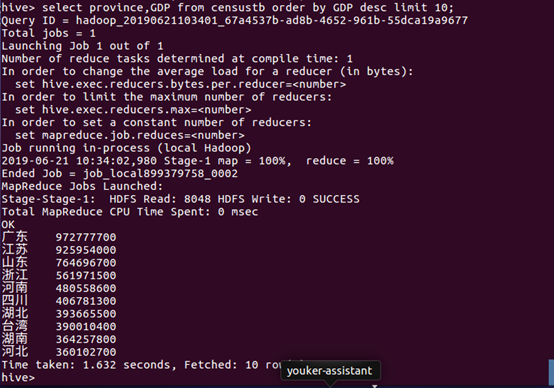
数据分析:从查询的结果可以看出,GDP值最大的省份是广东,其次是江苏,第三是山东。GDP值最大的十个省大都在沿海地区,说明GDP值与沿海的地理位置存在极大的关系。
(5)将人口数大于60000000的省份显示出来。
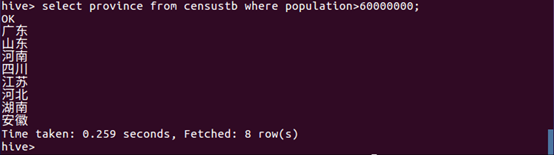
数据分析:从查询结果可以看出,广东、山东、河南、四川、江苏、河北、湖南和安徽这八个省的的人口数量已经超过六千万,结合上面的前十GDP省份可以知道:GDP越大,人数就越多。
(6)将censustb表中省份名与匹配字段相匹配的显示出来。
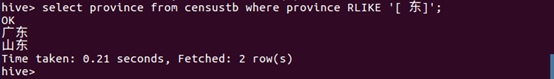
(7)将censustb表按人口数量排升序并将前五条数据的省份名与人口数量显示出来。
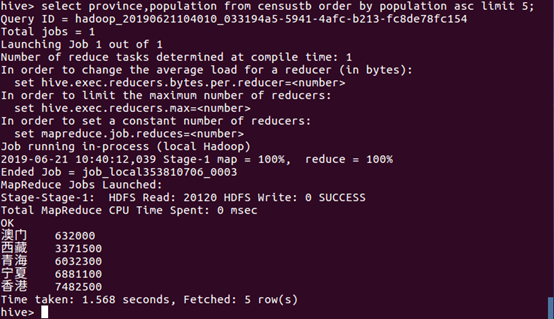
数据分析:从查询结果结果可以看出,人口数量最少的五个省份分别是香港、宁夏、青海、西藏以及澳门。
(8)使用SQL语句计算人口总数。
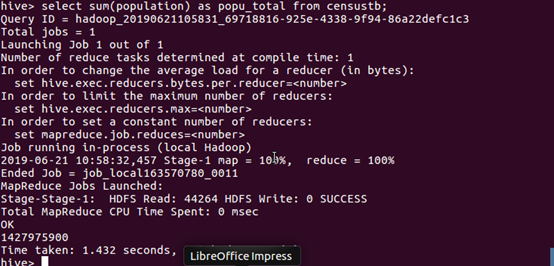
数据分析:从查询结果可以看出,2019年,我国的人口已达近 14.28 亿人,人口基数极大。
(9)显示最大的GDP值。
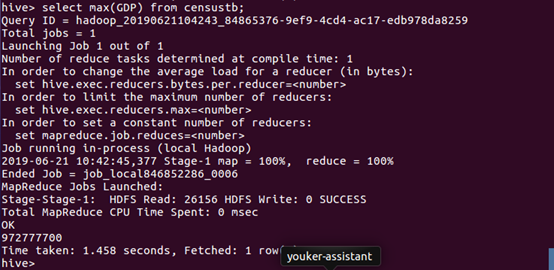
数据分析:在各省份中,最大的GDP值为 972777700 元。
(10)显示最少的人口数量。
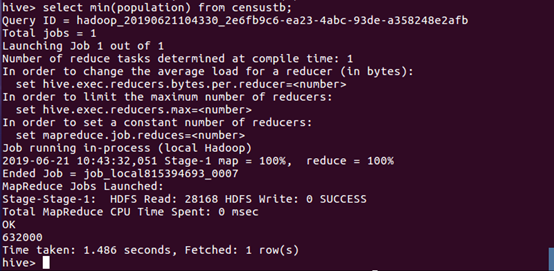
数据分析:从查询结果可知最少人口数量为632000人。
(11)使用SQL语句计算GDP总值。
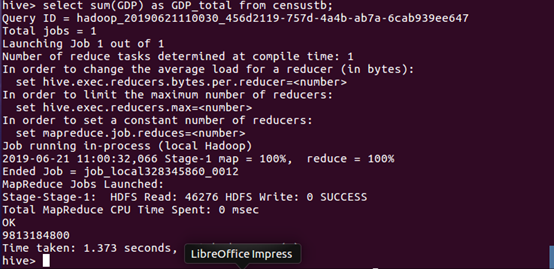
数据分析:我国GDP总值约为 98.13 亿元。
五、总结
通过对我国个省份地区的人口数量以及GDP总值数据分析,我们可以知道广东省不但是一个人口大省,还是一个国内生产总值较高的省,说明这个省的人们的生活水平比较高。我们还可以发现,我国的人口大多数都在东边沿海地区,沿海地区的经济也比内陆的地区更为发达,说明人口数量与经济呈现正相关的关系。我国的GDP生产总值(GDP)约为 98.13 亿元,虽然这个数看起来很大,但我国的人口也极多,约为14.28亿人,平均下来的GDP值也就没多少了,所以我国仍需大力发展经济。
大数据应用期末总评(hadoop综合大作业)的更多相关文章
- 大数据应用期末总评——Hadoop综合大作业
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 Hadoop综合大作业 要求: 1.将爬虫大作业产生的csv文件 ...
- 大数据应用期末总评Hadoop综合大作业
作业要求来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 1.将爬虫大作业产生的csv文件上传到HDFS 此次作业选取的 ...
- 【大数据应用期末总评】Hadoop综合大作业
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 一.Hadoop综合大作业 要求: 1.将爬虫大作业产生的csv ...
- Hadoop综合大作业
Hadoop综合大作业 要求: 用Hive对爬虫大作业产生的文本文件(或者英文词频统计下载的英文长篇小说)词频统计. 用Hive对爬虫大作业产生的csv文件进行数据分析 1. 用Hive对爬虫大作业产 ...
- 《Hadoop综合大作业》
作业要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 我主要的爬取内容是关于热门微博文章“996”与日剧<我要 ...
- 菜鸟学IT之Hadoop综合大作业
Hadoop综合大作业 作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 1.将爬虫大作业产生的csv文件上传到HDF ...
- Hadoop综合大作业1
本次作业来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 一.课程评分标准: 分数组成: 考勤 10 平时作业 30 爬 ...
- 大数据平台搭建(hadoop+spark)
大数据平台搭建(hadoop+spark) 一.基本信息 1. 服务器基本信息 主机名 ip地址 安装服务 spark-master 172.16.200.81 jdk.hadoop.spark.sc ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
随机推荐
- 【转载】 C#中使用decimal.Parse方法将字符串转换为十进制decimal类型
在C#编程过程中,很多时候涉及到数据类型的转换,例如将字符串类型的变量转换为十进制decimal类型就是一个常见的类型转换操作,decimal.Parse方法是C#中专门用来将字符串转换为decima ...
- 关于 Safari 浏览器不支持 location [ window.location.href window.open()] 跳转问题的解决方案
最近在做项目时,碰到 safari 浏览器不支持location跳转问题,针对此问题,可以通过 js 模拟点击时间来解决,代码如下: <!DOCTYPE HTML> <html la ...
- 快数据时代下,Moka携手DataPipeline提升招聘效能
新时代下,招聘早已不再是过去被动式的流程管控行为,智能化的招聘技术被越来越多地运用到企业招聘中. 为能更好地帮助企业优化招聘渠道,提高招聘效率,提升雇主品牌,Moka从成立之初便秉承“简单”的逻辑,通 ...
- ResourceDictionary文件排序方法
默认生成的ResourceDictionary文件是根据主键的hashcode排序生成的,如果想按主键排序生成是不可能的. 可以使用Xml的处理方法来生成ResourceDictionary文件. 1 ...
- resfframework中修改序列化类的返回值
在序列化类中重写to_representation(self,instance)方法,这个是返回json对象的方法,返回的是一个待序列化的对象,可以直接对这个类进行定制,有关关联查询也可以在这里进行定 ...
- 【RAC】 RAC For W2K8R2 安装--卸载(八)
[RAC] RAC For W2K8R2 安装--卸载(八) 一.1 BLOG文档结构图 一.2 前言部分 一.2.1 导读 各位技术爱好者,看完本文后,你可以掌握如下的技能,也可以学到一些其它 ...
- requests中构造post请求注意点
构造post请求时需要注意点: 通过requests.post()进行POST请求时,传入报文的参数有两个,一个是data,一个是json. 如果是urlencoded 格式 data=字典如果是js ...
- jQuery知识梳理20190818
目录 jQuery知识梳理20190818 1. 时间绑定和解绑 2. 区别mouseover与mouseenter 3. 时间委托(委派/代理) 4 . 多库共存 5.window.onload与$ ...
- 两种方式测试 GNS3 环境
GNS3已经部署好了,怎么测试环境呢?两种方式,一是使用自带的VPC连接交换机互联互通,二是配合VMware连接GNS3中的交换机互联互通. 自带 VPC 测试 使用两台VPC与一台二层交换机相连,测 ...
- SQL进阶系列之7用SQL进行集合运算
写在前面 集合论是SQL语言的根基,因为这种特性,SQL也被称为面向集合语言 导入篇:集合运算的几个注意事项 注意事项1:SQL能操作具有重复行的集合(multiset.bag),可以通过可选项ALL ...