
python爬虫之获取页面script里面的内容
这是网页上的script 我要获取的是00914这个数字 直接使用正则表达式即可
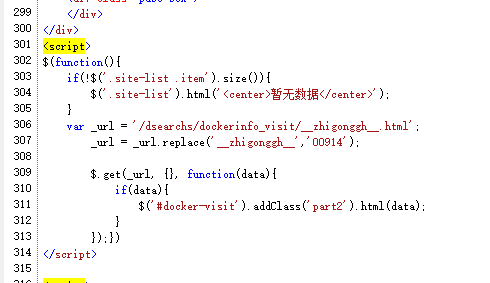
运行结果:

源码:
import re

from bs4 import BeautifulSoup

from urllib.request import urlopen

url = "你要解析的网页URL"

html = urlopen(url).read()

soup = BeautifulSoup(html,"html.parser")

titles = soup.select("body  script") # CSS 选择器

i = 1

for title in titles:

    if i == 3:

     #print(title.get_text())# 标签体、标签属性

     str=title.get_text()

     break

    if i == 2:

        i = 3

    if i == 1:

        i = 2

print(str)

str1 = "\"\"\""+"<script>"+str+"</script>"+"\"\"\""

soup = BeautifulSoup(str1, "html.parser")

pattern = re.compile(r"var _url = '(.*?)';$", re.MULTILINE | re.DOTALL)

script = soup.find("script", text=pattern)

#print (pattern.search(script.text).string)

s = pattern.search(script.text).string

print (s.split('\'')[11])
python爬虫之获取页面script里面的内容的更多相关文章
- Python+Selenium自动化-获取页面信息
Python+Selenium自动化-获取页面信息 1.获取页面title title:获取当前页面的标题显示的字段 from selenium import webdriver import t ...
- python爬虫实战 获取豆瓣排名前250的电影信息--基于正则表达式
一.项目目标 爬取豆瓣TOP250电影的评分.评价人数.短评等信息,并在其保存在txt文件中,html解析方式基于正则表达式 二.确定页面内容 爬虫地址:https://movie.douban.co ...
- python爬虫3——获取审查元素(板野友美吧图片下载)
测试环境:python2.7 + beautifulsoup4.4.1 + selenium2.48.0 测试网址:http://tieba.baidu.com/p/2827883128 目的是下载该 ...
- [Python爬虫] Selenium获取百度百科旅游景点的InfoBox消息盒
前面我讲述过如何通过BeautifulSoup获取维基百科的消息盒,同样可以通过Spider获取网站内容,最近学习了Selenium+Phantomjs后,准备利用它们获取百度百科的旅游景点消息盒(I ...
- Python爬虫爬取贴吧的帖子内容
最近在看一个大神的博客,从他那里学会了很多关于python爬虫的知识,其实python如果想用在实际应用中,你需要了解许多,比如正则表达式.引入库.过滤字段等等,下面不多说,我下面的程序是爬取Ubun ...
- Python 爬虫 ajax爬取马云爸爸微博内容
ajax爬取情况 有时候我们在用 Requests 抓取页面的时候,得到的结果可能和在浏览器中看到的是不一样的,在浏览器中可以看到正常显示的页面数据,但是使用 Requests 得到的结果并没有,这其 ...
- python爬虫初级--获取指定页面上的菜单名称以及链接,然后导出
''' Created on 2017年4月5日 @author: Admin ''' import requests from bs4 import BeautifulSoup as bsp # 网 ...
- Python爬虫:获取JS动态内容
经过一段时间的python学习,能写出一些爬虫了.但是,遇到js动态加载的网页就犯了难.于是乎谷歌.百度,发现个好介绍http://www.jianshu.com/p/4fe8bb1ea984 主要就 ...
- python爬虫--自动获取seebug的poc
简单的写了一个爬取www.seebug.org上poc的小玩意儿~ 首先我们进行一定的抓包分析 我们遇到的第一个问题就是seebug需要登录才能进行下载,这个很好处理,只需要抓取返回值200的页面,将 ...
随机推荐
- Linux 系统下安装JDK1.8的教程详解
一,安装前的清理工作 ? 1 2 3 rpm -qa | grep jdk rpm -qa | grep gcj yum -y remove java-xxx-xxx 二 , 在线下载JDK 命令: ...
- java.util.concurrent各组件分析 一 sun.misc.Unsafe
java.util.concurrent各组件分析 一 sun.misc.Unsafe 说到concurrent包也叫并发包,该包下主要是线程操作,方便的进行并发编程,提到并发那么锁自然是不可缺少的, ...
- 如何在Ubuntu的idea上运行Hadoop程序
如何在Ubuntu的idea上运行Hadoop程序 一.前言 在idea上运行Hadoop程序,需要使用Hadoop的相关库,Ubuntu为Hadoop的运行提供了良好的支持. 二.操作方法 首先我们 ...
- ubuntu / zsh shell / oh-my-zsh / 常用插件
记录一下 zsh 的下载与配置,省得每次重装系统都要上网到处查. 安装 zsh shell sudo apt install zsh 切换 shell chsh -s /bin/zsh 安装 oh-m ...
- Linux 网络通信 API详解【转载】
TCP/IP分层模型 OSI协议参考模型,它是基于国际标准化组织(ISO)的建议发展起来的, 它分为7个层次:应用层.表示层.会话层.传输层.网络层.数据链路层及物理层. 这个7层的协议模型虽然规定得 ...
- vsftpd限制下载流量
有时候我们在公司为了考虑业务,流量以及用户数问题会做一些限制操作,今天我们来看一下vsftpd是怎么做限流的 在vsftpd配置文件中添加如下内容 为了方便测试我们临时生成一个文件 接下来我们开始测试 ...
- Xamarin移动开发备忘
vs2017下: 1.debug用于本地生成和调试,release用于发布.区别主要在于: 安卓项目的生成选项属性中,开发者模式release是不勾的,而且高级里的cpu不同(debug是x86,re ...
- jenkins19年最新最管用的汉化
今天准备学学jenkins ,官方下载了一个最新版本,发现是英文版,网上找个许多汉化方式,几乎都是一种,下载插件 :Locale plugin ....很尴尬,下载完了还是没有汉化 ,是不是jenki ...
- 原生JavaScript HTML DOM Style 对象参考
Style 对象属性 可以在Style对象上使用以下属性: “CSS”列指示定义属性的CSS版本(CSS1,CSS2或CSS3). 属性 描述 CSS alignContent 当项目不使用所有可用空 ...
- 【React】Redux入门 & store体验
组件间传值联动是令人头疼的问题,尤其是一个组件影响多个其他组件状态变化的时候,常常需要一级一级与父组件传值,与父组件的兄弟组件传值等等, 如何化繁为简地处理‘牵一发动全身’的清理就是将所有组件的sta ...