
初识python 之 爬虫:使用正则表达式爬取“古诗文”网页数据
通过requests、re(正则表达式) 爬取“古诗文”网页数据。
详细代码如下:
#!/user/bin env python

# author:Simple-Sir

# time:2019/7/31 22:01

# 爬取古诗文网页数据

import re

import requests

def getHtml(page):

    '''

    获取网页数据

    :param page:  页数

    :return:  网页html数据(文本格式)

    '''

    headers = {

        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36'

    }

    url = 'https://www.gushiwen.org/default_{}.aspx'.format(page)  # 获取几页数据

    respons = requests.get(url,headers=headers)

    html = respons.text

    return html

def getText(html):

    titles = re.findall(r'<div class="cont">.*?<b>(.*?)</b>',html,re.DOTALL)  # 获取标题 re.DOTALL 匹配所有字符,包含\n(.无法匹配\n)

    caodai = re.findall(r'<p class="source">.*?<a.*?>(.*?)</a>',html,re.DOTALL)  # 获取朝代

    author = re.findall(r'<p class="source">.*?<a.*?>.*?<a.*?>(.*?)</a>',html,re.DOTALL)  # 获取朝代

    contents = re.findall(r'<div class="contson".*?>(.*?)</div>',html,re.DOTALL)  # 获取内容,包含标签符号

    con_texts =[] # 内容,不含标签符号

    for i in contents:

        rsub = re.sub('<.*?>','',i)

        con_texts.append(rsub.strip()) # strip 去空格

    si = []

    for v in zip(titles,caodai,author,con_texts):

        bt, cd, zz, nr = v

        s = {

            '标题':bt,

            '朝代': cd,

            '作者': zz,

            '内容': nr

        }

        si.append(s)

    return si

def main():

    p = int(input('您想要获取多少页的数据?\n'))

    for page in range(1,p+1):

        print('第{}页数据:'.format(page))

        html = getHtml(page)

        text = getText(html)

        for i in text:

            print(i)

if __name__ == '__main__':

    main()
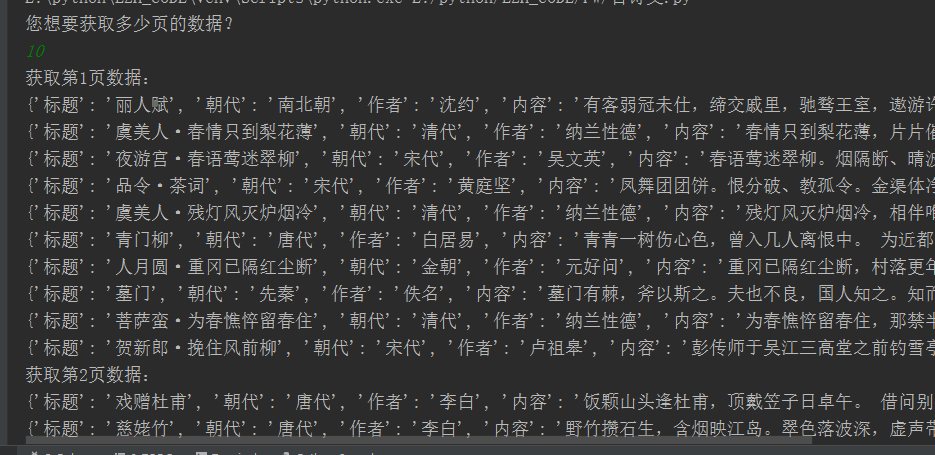
爬取“古诗文”网页数据
执行结果:

初识python 之 爬虫:使用正则表达式爬取“古诗文”网页数据的更多相关文章
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- Python 网络爬虫 002 (入门) 爬取一个网站之前,要了解的知识
网站站点的背景调研 1. 检查 robots.txt 网站都会定义robots.txt 文件,这个文件就是给 网络爬虫 来了解爬取该网站时存在哪些限制.当然了,这个限制仅仅只是一个建议,你可以遵守,也 ...
- python从爬虫基础到爬取网络小说实例
一.爬虫基础 1.1 requests类 1.1.1 request的7个方法 requests.request() 实例化一个对象,拥有以下方法 requests.get(url, *args) r ...
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
- python网络爬虫之四简单爬取豆瓣图书项目
一.爬虫项目一: 豆瓣图书网站图书的爬取: import requests import re content = requests.get("https://book.douban.com ...
- 【Python网络爬虫三】 爬取网页新闻
学弟又一个自然语言处理的项目,需要在网上爬一些文章,然后进行分词,刚好牛客这周的是从一个html中找到正文,就实践了一下.写了一个爬门户网站新闻的程序 需求: 从门户网站爬取新闻,将新闻标题,作者,时 ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- 精通python网络爬虫之自动爬取网页的爬虫 代码记录
items的编写 # -*- coding: utf-8 -*- # Define here the models for your scraped items # # See documentati ...
- Python 网络爬虫实战:爬取 B站《全职高手》20万条评论数据
本周我们的目标是:B站(哔哩哔哩弹幕网 https://www.bilibili.com )视频评论数据. 我们都知道,B站有很多号称“镇站之宝”的视频,拥有着数量极其恐怖的评论和弹幕.所以这次我们的 ...
随机推荐
- 2.8 GO 参数传递
简单将GO中参数传递分为三类 数字.字符.字符串等类型 结构体 方法 GO的方法本身就是地址的入口,打印一个方法输出的是这个方法的地址 func test_func(){ //0x488a30 fmt ...
- 【Java 基础】Java Enum
概览 在本文中,我们将看到什么是 Java 枚举,它们解决了哪些问题以及如何在实践中使用 Java 枚举实现一些设计模式. enum关键字在 java5 中引入,表示一种特殊类型的类,其总是继承jav ...
- 全网最详细的AbstractQueuedSynchronizer(AQS)源码剖析(一)AQS基础
AbstractQueuedSynchronizer(以下简称AQS)的内容确实有点多,博主考虑再三,还是决定把它拆成三期.原因有三,一是放入同一篇博客势必影响阅读体验,而是为了表达对这个伟大基础并发 ...
- Mac配置apache,mysql
===========Apache=============================== 1. 启动关闭Apache MAC系统已经预装了apache,启动.关闭.查看版本等命令如下: 启动a ...
- STM32F103ZET6 核心板制作指引
学点啥系列之 --STM32F103ZET6 核心板制作指引 原创资料,转载请联系 作者的话:会画stm32F103ZET6的话,rct6啥的简直不要太简单 一.电路总览 图1:电路整体 二.单片机部 ...
- [BUUCTF]PWN——pwnable_orw
pwnable_orw 附件 步骤: 例行检查,32位程序,开启了canary 本地运行一下程序,看看大概的情况,提示我们输入shellcode 32位ida载入,检索字符串,没看见什么可以直接利用的 ...
- 【二进制】【WP】MOCTF逆向题解
moctf 逆向第一题:SOEASY 这个是个 64 位的软件,OD 打不开,只能用 IDA64 打开,直接搜字符串(shift+F12)就可以看到 moctf 逆向第二题:跳跳跳 这个题当初给了初学 ...
- CF70B Text Messaging 题解
Content 有一个短信软件最多只能够上传长度为 \(n\) 的消息.现在你有一段话,但不一定能够一次发出.这段话由若干句话组成,以 ..? 或者 ! 为结尾.你不能够将一句话拆开来发,但是如果容量 ...
- 解决Centos7误删Python问题
1.前言 昨天安装Python3.6的时候.不小心把原来的Python全删了.不知道咋办了.后面参考一篇博客.重新安装了一下.相关的包全回来了.所以还是得注意root模式下.慎用rm -rf命令.(笑 ...
- centos使用docker安装ActiveMQ
拉取镜像 docker pull webcenter/activemq 启动镜像 docker run --name=activemq -itd -p 8161:8161 -p 61616:61616 ...