
Python正则表达式与re模块介绍
Python中通过re模块实现了正则表达式的功能。re模块提供了一些根据正则表达式进行查找、替换、分隔字符串的函数。本文主要介绍正则表达式先关内容以及re模块中常用的函数和函数常用场景。
正则表达式基本语法
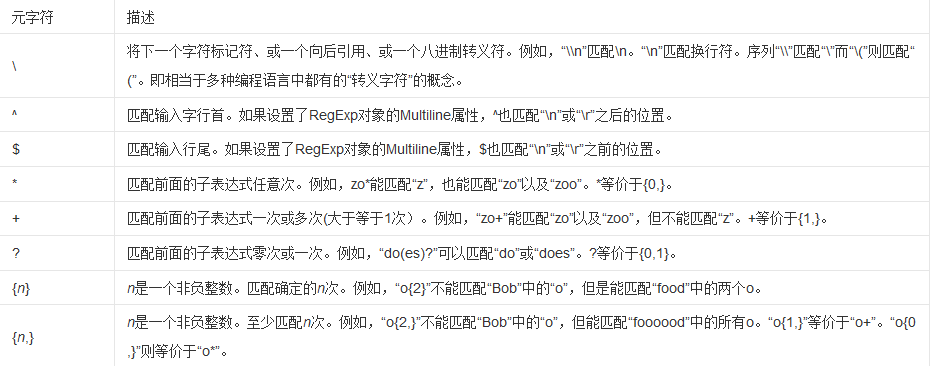
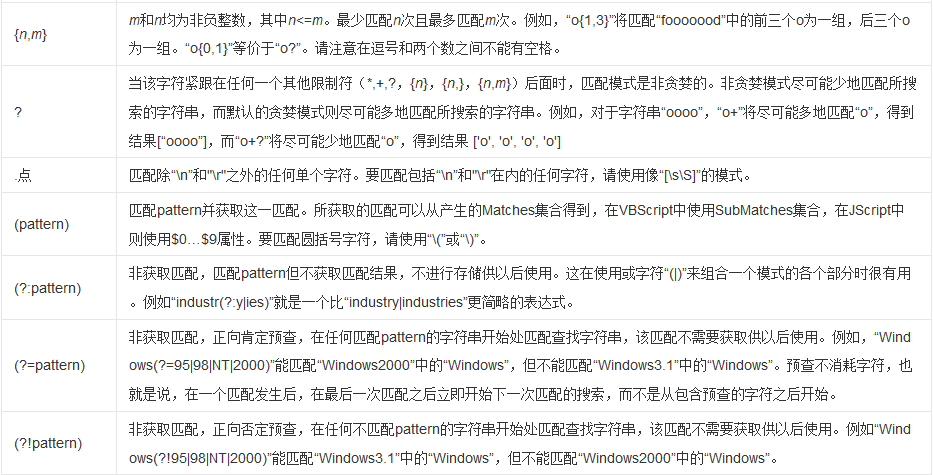
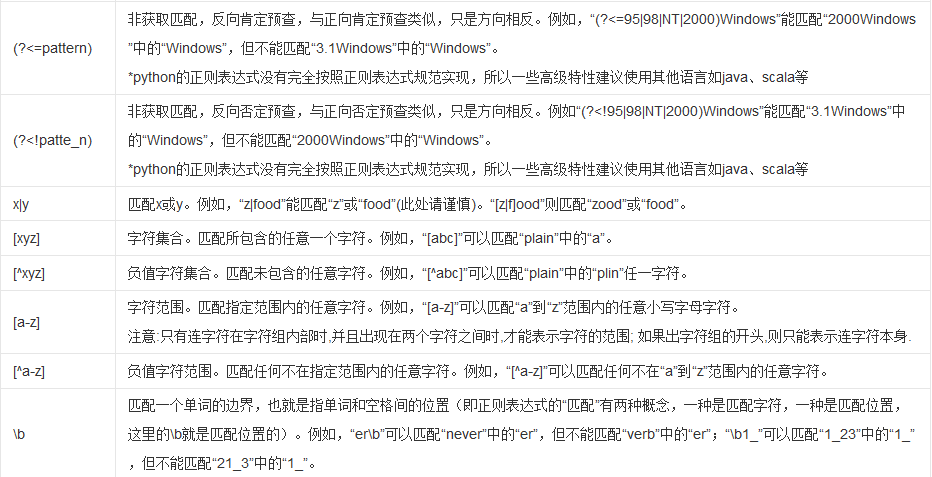
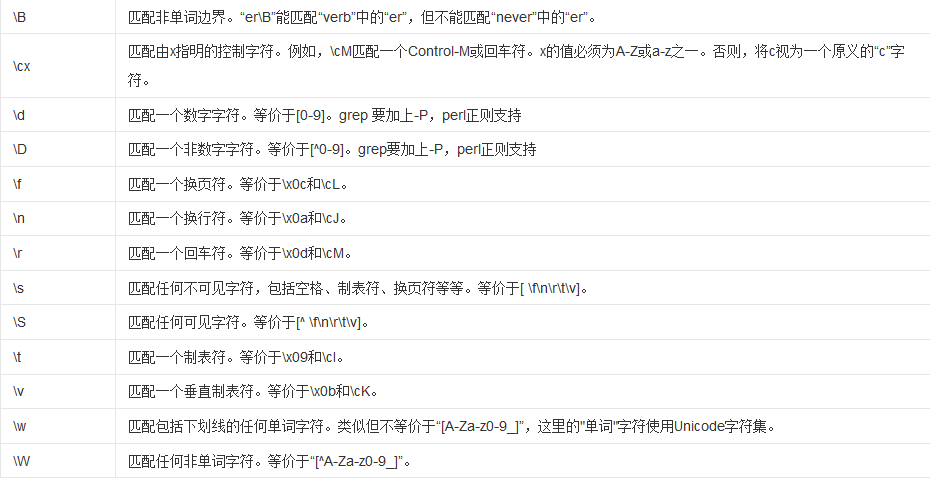
正则表达式就是使用预先定义好的特定字符以及这些特定字符的组成字符串的匹配表达式,然后利用表达式去匹配或提取字符串。因此,我们首先需要熟悉正则表达式中的特定字符以及它们的含义、用法。下面总体介绍一下正则表达式的基本元字符使用(源自百度百科 正则表达式)
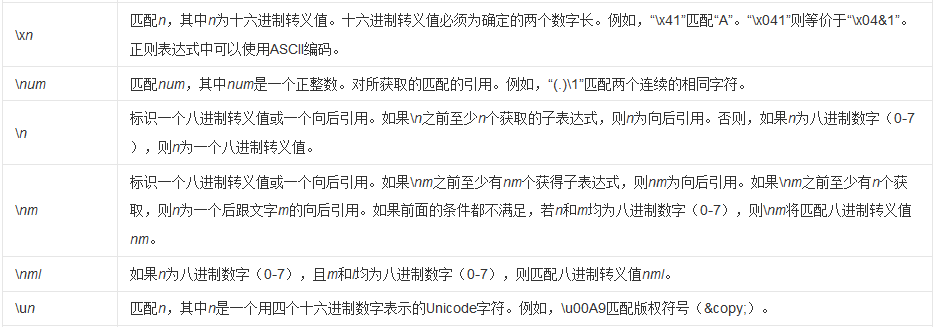
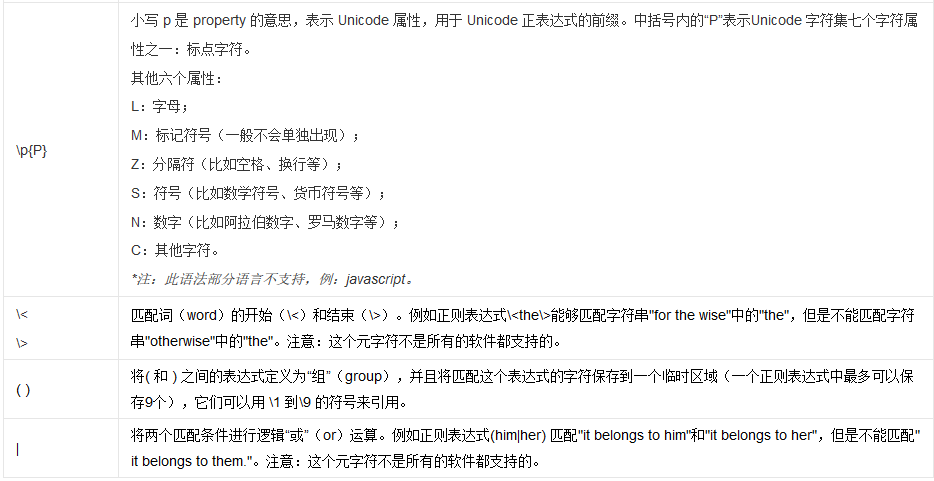
元字符使用基本实例
(1). 点号,表示匹配除换行"\n"外的任意1个字符。假设表达式:a.c,则匹配abc/a1c,不匹配ac。但是在python的re模块函数可以通过设置re.S标志让它也匹配换行符。
>>> import re

>>> re.findall(r'a.c','abc')

['abc']

>>> re.findall(r'a.c','ac')

[]

>>> re.findall(r'a.c','a\nc',re.S)

['a\nc']
(2)\ 转义字符,使后一个字符改变原来的含义。假设表达式为a\.c,则仅匹配a.c,不匹配abc、a1c等a与c之间非点号"."的字符串。在转义符"\"之后点号".失去了原来代表任意字符的含义。
>>> re.findall(r'a\.c','a.c')

['a.c']

>>> re.findall(r'a\.c','abc')

[]
(3)[...] 字符集,对应的位置可以是字符集中任意字符,字符集中的字符可以逐个列出,也可以给出范围,或者如果第1个字符是^表示取反。下面针对这几种情形逐一描述。
场景1:[...]字符集中的字符逐个列出。如[bcd]。假设正则表达式为a[bcd]e,则匹配abe、ade,但不匹配afe。实例如下:
>>> re.findall(r'a[bcd]e','abe')

['abe']

>>> re.findall(r'a[bcd]e','ade')

['ade']

>>> re.findall(r'a[bcd]e','afe')

[]
场景2:[...]字符集中的字符以范围给出。假设表达式为a[a-d]e,相当于a[abcd]e。则匹配abe、ade。
>>> re.findall(r'a[a-d]e','abe')

['abe']

>>> re.findall(r'a[a-d]e','ade')

['ade']
场景3:如果[...]字符集第一个字符是^,则表示取反。假设表达式为a[^abc]e,则匹配afe,不匹配abe、ace。
>>> re.findall(r'a[^abc]e','abe') # ^在中括号内表示取反的意思。所以a[^abc]e可以匹配afe、a1e,但不匹配abe、ace

[]

>>> re.findall(r'a[^abc]e','afe')

['afe']
那如果^字符不是在第一个字符呢,那它就仅仅表示一个普通的字符。假设表达式为a[a^bc]e,则匹配abe、a^e、ace,不匹配afe。
>>> re.findall(r'a[a^bc]e','abe')

['abe']

>>> re.findall(r'a[a^bc]e','a^e')

['a^e']

>>> re.findall(r'a[a^bc]e','afe')

[]
场景4:特殊字符在字符集[...]中都失去其原有的特殊含义。假设表达式为a[a.bc]e,则匹配abe、ace、a.e,不匹配afe
>>> re.findall(r'a[a.bc]e','a.e') #特殊符号"."在中括号内失去了原有的含义。

['a.e']

>>> re.findall(r'a[a.bc]e','afe')

[]
预定义字符集
(1)\d 表示1个数字,相当于[0-9]。假设表达式为a\dc,则匹配a1c,不匹配abc
>>> re.findall(r'a\dc','a1c')

['a1c']

>>> re.findall(r'a\dc','abc')

[]
(2)\D 表示1个非数字,相当于[^0-9]。假设表达式a\Dc,则匹配abc,不匹配a1c
>>> re.findall(r'a\dc','a1c')

['a1c']

>>> re.findall(r'a\dc','abc')

[]
(3)\s 表示1个空白字符,相当于[<空格>\t\r\n\f\v]。假设表达式为a\sc,则匹配a c,不匹配abc
>>> re.findall(r'a\sc','a c')

['a c']

>>> re.findall(r'a\sc','abc')

[]
(4)\S 表示1个非空白字符,相当于[^\s]。假设表达式为a\Sc,则匹配abc,不匹配a c
>>> re.findall(r'a\Sc','abc')

['abc']

>>> re.findall(r'a\Sc','a c')

[]
(5)\w 表示1个单词字符,相当于[a-zA-z0-9_]。假设表达式为a\wc,则匹配abc,不匹配a c
>>> re.findall(r'a\wc','abc')

['abc']

>>> re.findall(r'a\wc','a1c')

['a1c']

>>> re.findall(r'a\wc','a c')

[]
(6)\W 表示1个非单词字符,相当于[^\w]。假设表达式为a\Wc,则匹配a c,不匹配abc
>>> re.findall(r'a\Wc','a c')

['a c']

>>> re.findall(r'a\Wc','a!c')

['a!c']

>>> re.findall(r'a\Wc','a.c')

['a.c']

>>> re.findall(r'a\Wc','abc')

[]

>>> re.findall(r'a\Wc','a1c')

[]
数量词
(1)* 表示匹配前一个字符0~n次。假设表达式为abc*,则匹配ab、abc、abcc
>>> re.findall(r'abc*','ab')

['ab']

>>> re.findall(r'abc*','abc')

['abc']

>>> re.findall(r'abc*','abcc')

['abcc']
(2)+ 表示匹配前一个字符1~n次。假设表达式为abc+,则匹配abc、abccc,不匹配ab
>>> re.findall(r'abc+','abc')

['abc']

>>> re.findall(r'abc+','abcc')

['abcc']

>>> re.findall(r'abc+','ab')

[]
(3)? 表示匹配前一个字符0或1次。假设表达式为abc?,则匹配ab、abc
>>> re.findall(r'abc?','ab')

['ab']

>>> re.findall(r'abc?','abc')

['abc']
(4){m} 表示匹配前一个字符m次。假设表达式为abc{2},则匹配abcc,不匹配abc
>>> re.findall(r'abc{2}','abcc')

['abcc']

>>> re.findall(r'abc{2}','abc')

[]
(5){m,n} 表示匹配前一个字符m到n次。假设表达式为abc{2,3},则匹配abcc、abccc,不匹配abc
>>> re.findall(r'abc{2,3}','abcc')

['abcc']

>>> re.findall(r'abc{2,3}','abccc')

['abccc']

>>> re.findall(r'abc{2,3}','abc')

[]
数量词字符的描述到这里就结束,如果你仔细观察你会发现正则表达式abc*匹配abcc获取的结果是abcc而不是ab,表达式abc?匹配abc的结果是abc而不是ab,表达式abc{2,3}匹配abccc的结果不是abcc而是abccc。原因是正则表达式默认匹配方式是贪婪匹配,也就是最长匹配。所以会出现上述的匹配结果。那如果是想最短匹配呢?只需要在数量限定符后面加一个问号"?"就可以了。我们将上述的例子修改重新匹配下。实例如下:
>>> re.findall(r'abc*','abcc') #最长匹配

['abcc']

>>> re.findall(r'abc*?','abcc') #最短匹配

['ab']

>>> re.findall(r'abc?','abc')

['abc']

>>> re.findall(r'abc??','abc')

['ab']

>>> re.findall(r'abc{2,3}','abccc')

['abccc']

>>> re.findall(r'abc{2,3}?','abccc')

['abcc']
边界匹配
(1)^ 表示从字符串起始位置开始匹配。假设表达式为^abc,则匹配abcd,不匹配babc
>>> re.findall(r'^abc','abcd')

['abc']

>>> re.findall(r'^abc','babc')

[]
(2)$ 表示从字符串结尾开始匹配。假设表达式为abc$,则匹配ccabc,不匹配abcd
>>> re.findall(r'abc$','ccabc')

['abc']

>>> re.findall(r'abc$','ccabcd')

[]
(3)\A表示从 字符串起始位置开始匹配。 假设表达式为\Aabc,则匹配abcd,不匹配babc
>>> re.findall(r'\Aabc','abcd')

['abc']

>>> re.findall(r'\Aabc','babc')

[]
(4)\Z表示从字符串结束部分开始匹配。如果是存在换行,只匹配到换行前的结束字符串 假设表达式为abc\Z,则匹配abc,不匹配abcd
>>> re.findall(r'abc\Z','abc')

['abc']

>>> re.findall(r'abc\Z','abcd')

[]
(5)\b 表示匹配一个单词边界。假设表达式为'er\b' 则匹配"never" 中的 'er',但不能匹配 "verb" 中的 'er'。
>>> re.findall(r'er\b','never')

['er']

>>> re.findall(r'er\b','verb')

[]
(6)\B 表示匹配非单词边界。假设表达式为'er\B'则可以匹配 "verb" 中的 'er',但不能匹配 "never" 中的 'er'。
>>> re.findall(r'er\B','verb')

['er']

>>> re.findall(r'er\B','never')

[]
逻辑分组
(1)| 表示匹配|左右表达式的任意一个。假设表达式为abc|def,则匹配abc、def
>>> re.findall(r'abc|def','abc')

['abc']

>>> re.findall(r'abc|def','def')

['def']
(2)(...) 作为分组,每遇到一个(,分组编号加1,使用分组的好处是匹配的子串会保存到一个子组,便于以后使用。假设表达式为(\d{4})-(\d{2})-(\d{2}),则用于匹配2017-06-03,然后用分组编号1、2、3分别获取年、月、日三个值。。说明:如果这里match()函数和match对象的group()函数理解有困难,可以先跳过,后面再返回查看。
>>> mat = re.search(r'(\d{4})-(\d{2})-(\d{2})','2017-06-03')

>>> mat.group()

'2017-06-03'

>>> mat.group(1)

''

>>> mat.group(2)

''

>>> mat.group(3)

''
(3)(?P<name>...) 分组除原有编号外,再加一个别名 。假设表达式为(?P<Year>\d{4})-(?P<Month>\d{2})-(?P<Day>\d{2}),则匹配用于匹配2017-06-03,然后用命名分组名称Year、Month、Day获取年、月、日3个值。
>>> mat = re.search(r'(?P<Year>\d{4})-(?P<Month>\d{2})-(?P<Day>\d{2})','2017-06-03')

>>> mat.group()

'2017-06-03'

>>> mat.group('Year')

''

>>> mat.group('Month')

''

>>> mat.group('Day')

''
当然,在分组有命名的情况下也依然可以使用默认分组编号获取年、月、日的值。结果如下:
>>> mat.group(1)

''

>>> mat.group(2)

''

>>> mat.group(3)

''
(4)\<number> 引用编号为number的分组匹配到的字符串。假设表达式为 (abc)ee\1,则匹配abceeabc,不匹配abceeabd。
>>> re.match(r'(abc)ee\1','abceeabc') #match匹配则会有一个match对象返回。

<_sre.SRE_Match object at 0x00000000055F9BE8>

>>> re.match(r'(abc)ee\1','abceeabd') #match不匹配,则返回None。

>>>
(5)(?P=name) 使用别名为name的分组匹配到的字符串。通常与(?P<name>...)结合使用。用法同\<number>。假设表达式为(?P<Year>\d{4})(?P=Year)。则匹配20172017,不匹配20172018。
>>> mat = re.search(r'(?P<Year>\d{4})(?P=Year)','') #匹配,输出

>>> mat.group()

''

>>> mat.group(1)

''

>>> re.search(r'(?P<Year>\d{4})(?P=Year)','') #不匹配,返回None

>>>
字符串前r的含义
字符串前r表示不转义,使用真实字符。举例如下:
>>> str = "Hello\tWorld"

>>> print str

Hello   World

>>> str = r"Hello\tWorld"

>>> print str

Hello\tWorld
re模块常用函数
1、match(pattern,string,flags=0)
根据pattern从string的头部开始匹配字符串,只返回第1次匹配成功的对象,否则,返回None。flags表示规则选项。
>>> import re

>>> Str='Python:Java:C'

>>> re.match(r'Python',Str) #匹配成功

<_sre.SRE_Match object at 0x0000000005C5FCC8>

>>> Str='Java:Python:C'

>>> re.match(r'Python',Str) #匹配失败

>>>
2、search(pattern,string,flags=0)
根据pattern在string中匹配字符串,只返回第1次匹配成功的对象,否则,返回None。
>>> import re

>>> Str='Python:Java:C'

>>> re.search(r'Python',Str) #匹配成功

<_sre.SRE_Match object at 0x00000000060D7D98>

>>> Str='Java:Python:C'

>>> re.search(r'Python',Str) #同样匹配成功

<_sre.SRE_Match object at 0x0000000005C5FCC8>
3、split(pattern,string,maxsplit=0)
根据pattern分隔string,maxsplit表示最大分隔数。
>>> import re

>>> Str='Python:Java:C'

>>> re.split(r':',Str) #指定分隔符:

['Python', 'Java', 'C']

>>> Str='Python:Java:C'

>>> re.split(r':',Str,1) #指定最大分割次数

['Python', 'Java:C']

>>> Str = "Python:Java:Shell|C++|Ruby"

>>> re.split(r'[:|]',Str) #指定多种分隔符

['Python', 'Java', 'Shell', 'C++', 'Ruby']
4、compile(pattern,flags=0)
编译正则表达式pattern,返回一个pattern对象。
>>> import re

>>> regex = r'Python'

>>> Str='Python:Java:C'

>>> p = re.compile(regex)

>>> p.match(Str)

<_sre.SRE_Match object at 0x00000000060D7D98>
说明:pattern对象方法除了match(),还包括search()、findall()、finditer()。
5、sub(pattern,repl,string,count=0)
根据指定的正则表达式,替换字符串中的子串。pattern是一个正则表达式,repl是用于替换的字符串,string是源字符串,如果count为0,则返回string中匹配的所有结果。如果count>0,则返回前count个匹配结果。
>>> import re

>>> Str='Python:Java:C'

>>> re.sub(r'P.*n','Ruby',Str)

'Ruby:Java:C'

>>> print Str #不改变原字符串

Python:Java:C
6、subn(pattern,repl,string,count=0)
作用和sub()相同,返回一个二元元组。第一个元素是替换结果,第2个元素是替换的次数。
>>> import re

>>> Str='Python:Java:C'

>>> re.subn(r'P.*:','Ruby:',Str) #返回替换次数

('Ruby:C', 1)

>>> re.subn(r'P.*?:','Ruby:',Str) #注意匹配中多了个?号,替换内容不同了

('Ruby:Java:C', 1)

>>>
说明:匹配条件中'P.*?:'有无问号?号是有区别的。不加?号是贪婪匹配。
7、findall(pattern,string,flags=0)
根据pattern在string中匹配字符串。如果匹配成功,返回包含匹配结果的列表,否则,返回空列表。但pattern中有分组时,返回包含多个元组的列表,每个元组对应一个分组。
>>> import re

>>> regex = r'\w+' #\w表示匹配包括下划线的任何单词字符

>>> Str='Python:Java:C'

>>> p = re.compile(regex)

>>> p.findall(Str)

['Python', 'Java', 'C']
描述完re模块的主要函数后,这里再强调 函数中的flags参数 和 re.compile() 函数。
1、re.flags参数
通过查看re模块函数的原型可以发现,函数参数几乎都有flags参数,该参数用于设置匹配的附加选项。例如,是否忽略大小写、是否支持多行匹配等。常用的re模块规则选项如下所示:
I或IGNORECASE 忽略大小写

L或LOCALE 字符集本地化,用于多语言环境

M或MULTILINE 多行匹配

S或DOTALL 使.匹配包括\n在内的所有字符

X或VERBOSE 忽略正则表达式中的空白、换行,方便添加注释

U或UNICODE \w、\W、\b、\B、\d、\D、\s和\S都将使用Unicode
通过一个忽略大小写的实例看下用法:
>>> import re

>>> Str='Python:Java:C'

>>> re.match(r'python',Str) #匹配失败

>>> re.match(r'python',Str,re.I) #加re.I,匹配成功

<_sre.SRE_Match object at 0x00000000060D7D98>
2、re.compile() 函数
正则表达式的解析非常耗时,如果多次使用findall()的方式匹配字符串搜索效率可能比较低。如果多次使用同一规则匹配字符串,可以使用compile()进行预编译,compile函数返回1个pattern对象。该对象拥有一系列方法用于查找、替换或扩展字符串,从而提供字符串的匹配速度。patter对象的属性和方法如下
pattern #获取当前使用的正则表达式

match(string,flags=0) #同re.match()

search(string,flags=0) #同re.searc()

findall(string,flags=0) #查找所有符合pattern对象匹配条件的结果,返回1个包含匹配结果的列表。

finditer(string,flags=0) #返回一个包含匹配结果的地址
另外,函数compile()通常与match()、search()、group()一起使用对含有分组的正则表达式进行解析。正则表达式的分组从左往右开始计数,第1个出现的圆括号标记为第1组,依次类推。此外还有0号组,0号组用于存储匹配整个正则表达式的结果。match()和search()将返回一个match对象,match对象提供了一系列的方法和属性来管理匹配的结果。match对象的方法和属性如下:
group(index=0) #某个分组的匹配结果。默认匹配整个正则表达式

groups() #所有分组的匹配结果,每个分组的结果组成1个列表返回
举例,匹配身份证号码并获取身份证中的年、月、日信息。
>>> regex = r'[1-9][0-9]{5}(\d{4})(\d{2})(\d{2})[0-9]{3}[0-9X]'

>>> Str = '11010019950807532X'

>>> p = re.compile(regex)

>>> m = p.match(Str)

>>> m.groups()

('', '', '')

>>> m.group(1)

''

>>> m.group(2)

''

>>> m.group(3)

''
典型实例
1、多关键字任一匹配查找
>>> import re

>>> regex = r'Python|Java|C'

>>> Str1 = 'Hello Java,Python Developer'

>>> p = re.compile(regex)

>>> p.findall(Str1)

['Java', 'Python']
说明:regex中的Python、Java、C表达式都可以单独作为一个匹配关键词在字符串中进行查找。也就是它们之间是 或 的关系。
2、提取字符串中的手机号码,手机号前缀为136,长度11位。
>>> import re

>>> Str = '13612345678,1361234567,123a2345678,136 12345678,13712345678,13687654321'

>>> regex = r'136\d{8}'

>>> p = re.compile(regex)

>>> num_lst = p.findall(Str)

>>> print num_lst

['', '']
3、利用分组命名,提取字符串中的内容
>>> import re

>>> Str = 'Learn 1998-07-12,Practice 1999-09-09,Complete 2000-01-01'

>>> regex = r'(?P<year>[1-9]\d{3})-(?P<month>\d{2})-(?P<day>\d{2})'

>>> p = re.compile(regex)

>>> m = p.search(Str)

>>> print m.group('year')

>>> print m.group('month')

>>> print m.group('day')
参考资料
Python正则表达式与re模块介绍的更多相关文章
- python正则表达式之re模块方法介绍
python正则表达式之re模块其他方法 1:search(pattern,string,flags=0) 在一个字符串中查找匹配 2:findall(pattern,string,flags=0) ...
- python基础31[常用模块介绍]
python基础31[常用模块介绍] python除了关键字(keywords)和内置的类型和函数(builtins),更多的功能是通过libraries(即modules)来提供的. 常用的li ...
- python正则表达式与re模块-02
正则表达式 正则表达式与python的关系 # 正则表达式不是Python独有的,它是一门独立的技术,所有的编程语言都可以使用正则 # 但要在python中使用正则表达式,就必须依赖于python内置 ...
- python 正则表达式re使用模块(match()、search()和compile())
摘录 python核心编程 python的re模块允许多线程共享一个已编译的正则表达式对象,也支持命名子组.下表是常见的正则表达式属性: 函数/方法 描述 仅仅是re模块函数 compile(patt ...
- Python文件和目录模块介绍:glob、shutil、ConfigParser
glob模块 查找符合特定规则的文件路径名,路径名可以使用绝对路径也可以使用相对路径.查找文件会使用到三个通配符,星号*,问号?和中括号[],其中"*"表示匹配0~n个字符, &q ...
- python 正则表达式 (重点) re模块
京东的注册页面,打开页面我们就看到这些要求输入个人信息的提示.假如我们随意的在手机号码这一栏输入一个11111111111,它会提示我们格式有误.这个功能是怎么实现的呢?假如现在你用python写一段 ...
- Python正则表达式与hashlib模块
菜鸟学python第十六天 1.re模块(正则表达式) 什么是正则表达式 正则表达式是一个由特殊字符组成的序列,他能帮助对字符串的某种对应模式进行查找. 在python中,re 模块使其拥有全部的正则 ...
- Python正则表达式与re模块
在线正则表达式测试 http://tool.oschina.net/regex/ 常见匹配模式 模式 描述 \w 匹配字母数字及下划线 \W 匹配非字母数字下划线 \s 匹配任意空白字符,等价于 [\ ...
- python 正则表达式与re模块
一.正则表达式 用途 用事先定义好的一些特定字符.及这些特定字符的组合,组成一个“规则字符串”,这个“规则字符串”用来表达对字符串的一种过滤逻辑. #### 简单地说 就是用于字符串匹配的 字符组 在 ...
随机推荐
- postgresql数据库常用操作命令及SQL语言
(1)登录 peng@peng-virtual-machine:~$ sudo -u postgres psql 以用户postgres身份登录,postgres为用户名,可有多个用户,登录时会要求输 ...
- VMware安装CentOS7踩坑
1.VMware安装Centos7加载界面不显示,但有快照 单击“开始”,运行中输入cmd. 然后输入命令 netsh winsock reset. 重启计算机. 2.nat模式网络问题 ...
- sqoop导入导出
sqoop产生背景 什么是sqoop sqoop的优势 sqoop1与sqoop2的比较 为什么选择sqoop1 sqoop在hadoop生态体系中的位置 sqoop基本架构 sqoop import ...
- Guava实现 过滤文本,排序,转换内容,分组计数转换map 等等
重要点 :看注释 从access.log中统计数据 对healthcheck.html的请求不计入统计 输出请求总量,以及GET和POST分别的总量 输出请求最频繁的10个接口及其次数,按次数降序 输 ...
- 压缩校验合并js之grunt搭建
1.在说grunt先认识几个grunt配置中的几个单词,concat(合并文件),uglify(压缩文件),jshint(检测代码规范),watch(实时监听修改的文件) 2.grunt是基于node ...
- 【Tomcat】Tomcat安装及Eclipse配置教程
==================================================================================================== ...
- mysql-5.5.50-winx64
1.help 2.Service 3.Configure 4.User 5.design last 1.获取帮助文档 cd C:\Program Files\mysql\mysql-5.5.50-wi ...
- Shell 格式化输出数字、字符串(printf)
1.语法 printf打印格式字符串,解释'%'指令和'\'转义. 1.1.转义 printf使用时需要指定输出格式,输出后不换行. printf FORMAT [ARGUMENT] printf O ...
- Java Swing类 例子代码:将子类继承JFrame 并且接口按键监听ActionLisetener (将内容直接添加到JFrame不创建Contaniner)
package rom; import java.awt.BorderLayout; import java.awt.Color; import java.awt.Container; import ...
- JAVA 中文 unicode 相互转换 文件读取
package com.test; import org.junit.Test; public class JunitTest { @Test public void test(){ String p ...