
传统应用迁移到kubernetes(Hadoop YARN)
spark-on-yarn-with-kubernetes
该例子仅用来说明具体的步骤划分和复杂性,在生产环境应用还有待验证,请谨慎使用。
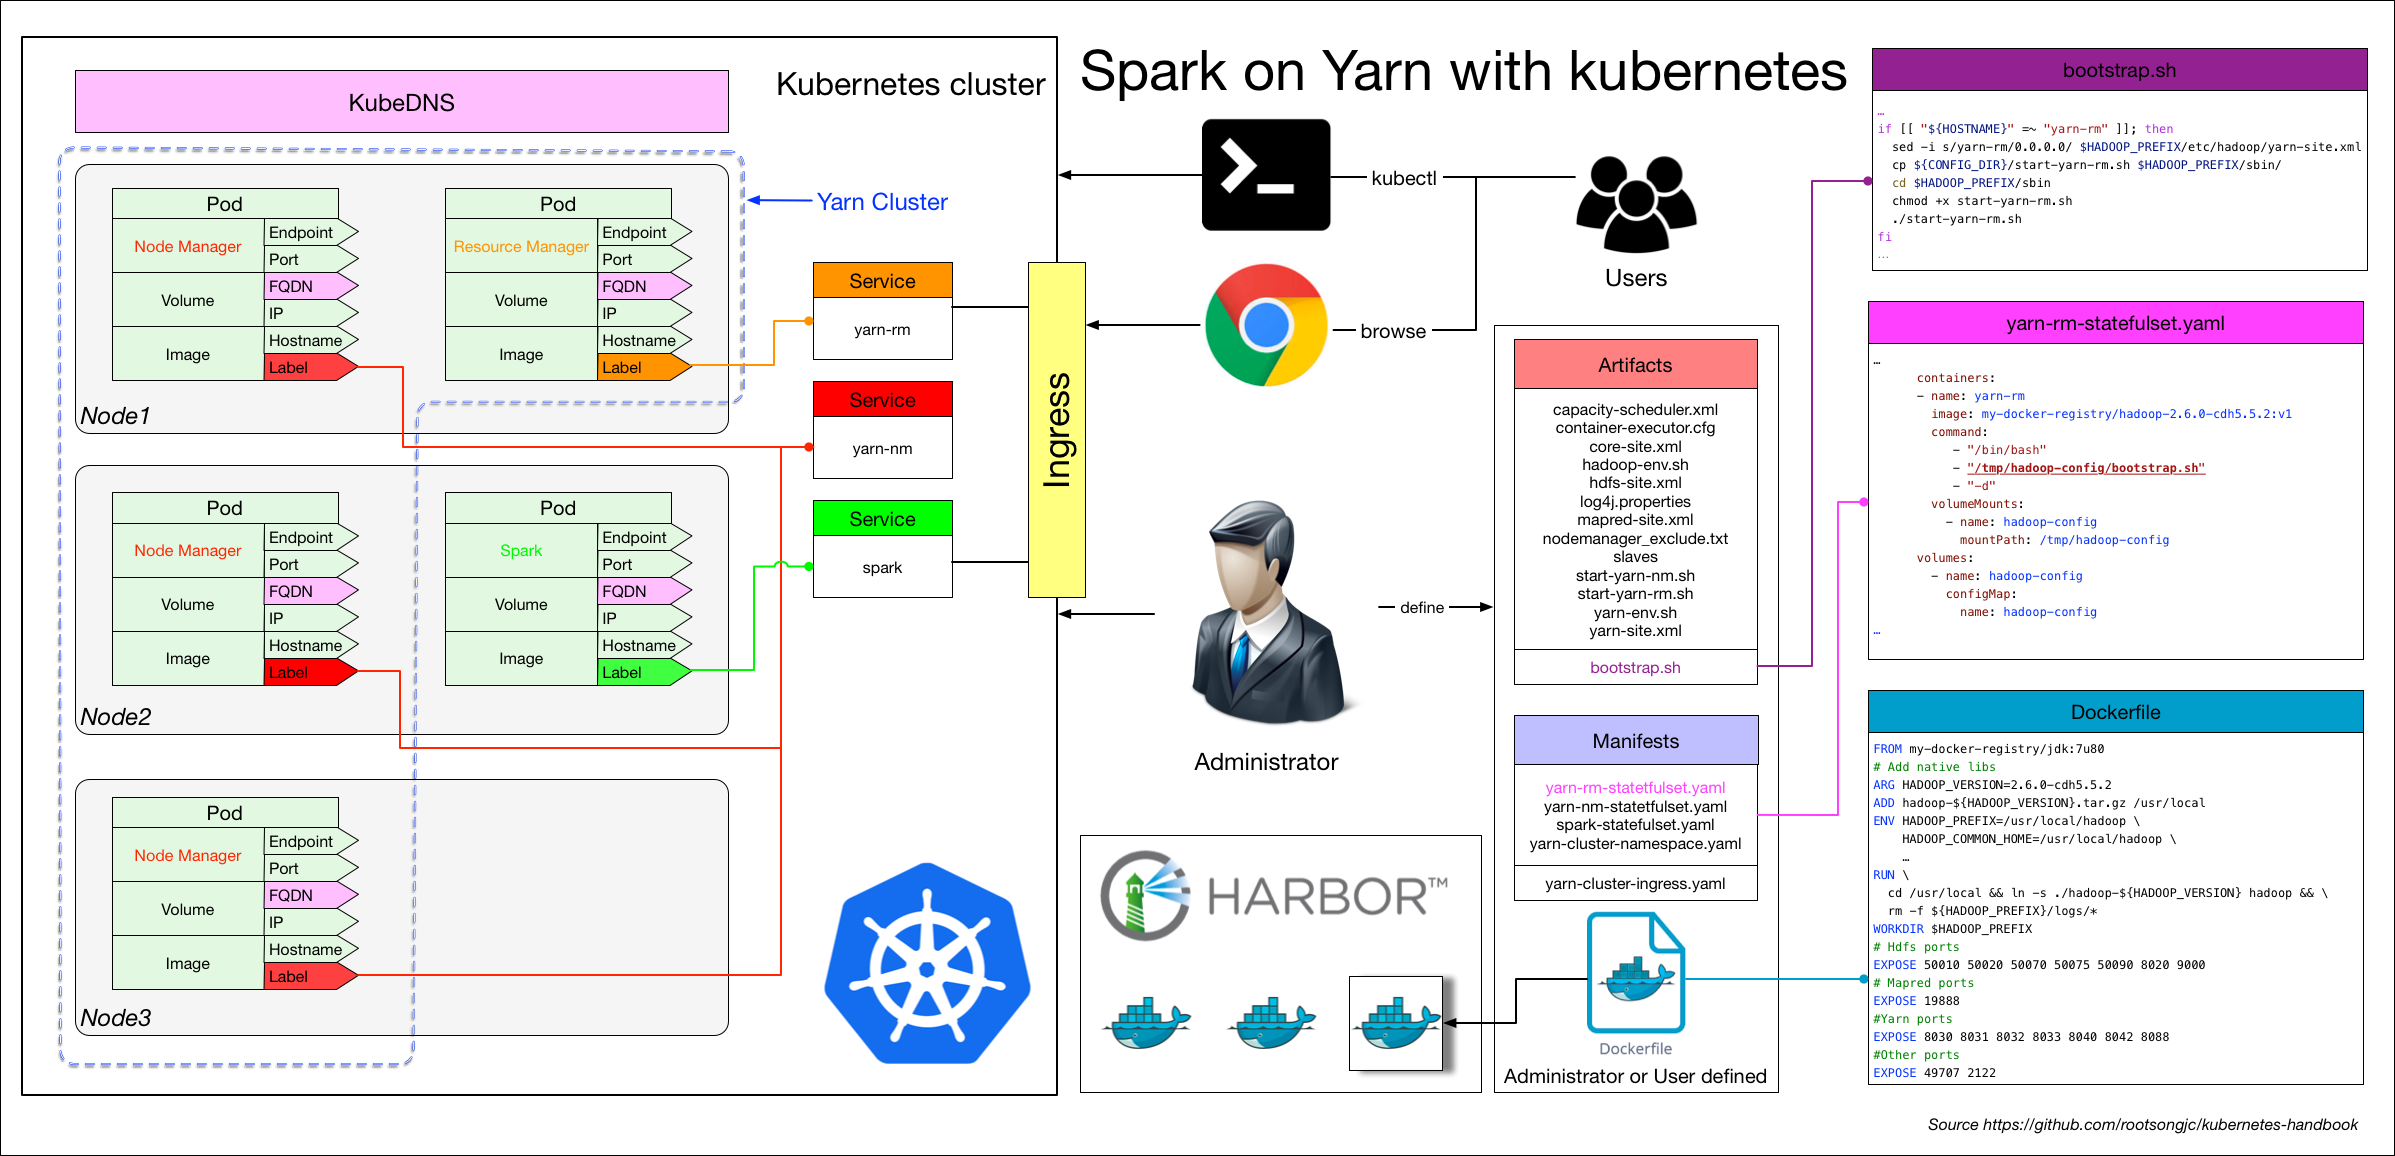
过程中可能用到的概念和术语初步整理如下:

整个迁移过程分为如下几个步骤:

1. 将原有应用拆解为服务
我们不是一上来就开始做镜像,写配置,而是应该先梳理下要迁移的应用中有哪些可以作为服务运行,哪些是变的,哪些是不变的部分。
服务划分的原则是最小可变原则,这个同样适用于镜像制作,将服务中不变的部分编译到同一个镜像中。
对于像 Spark on YARN 这样复杂的应用,可以将其划分为三大类服务:
- ResourceManager
- NodeManager
- Spark client
2. 制作镜像
根据拆解出来的服务,我们需要制作两个镜像:
- Hadoop
- Spark (From hadoop docker image)
因为我们运行的是 Spark on YARN,因此 Spark 依赖与 Hadoop 镜像,我们在 Spark 的基础上包装了一个 web service 作为服务启动。
镜像制作过程中不需要在 Dockerfile 中指定 Entrypoint 和 CMD,这些都是在 kubernetes 的 YAML 文件中指定的。
Hadoop YARN 的 Dockerfile 参考如下配置。
FROM my-docker-repo/jdk:7u80

# Add native libs

ARG HADOOP_VERSION=2.6.0-cdh5.5.2

## Prefer to download from server not use local storage

ADD hadoop-${HADOOP_VERSION}.tar.gz /usr/local

ADD ./lib/* /usr/local/hadoop-${HADOOP_VERSION}/lib/native/

ADD ./jars/* /usr/local/hadoop-${HADOOP_VERSION}/share/hadoop/yarn/

ENV HADOOP_PREFIX=/usr/local/hadoop \

    HADOOP_COMMON_HOME=/usr/local/hadoop \

    HADOOP_HDFS_HOME=/usr/local/hadoop \

    HADOOP_MAPRED_HOME=/usr/local/hadoop \

    HADOOP_YARN_HOME=/usr/local/hadoop \

    HADOOP_CONF_DIR=/usr/local/hadoop/etc/hadoop \

    YARN_CONF_DIR=/usr/local/hadoop/etc/hadoop \

    PATH=${PATH}:/usr/local/hadoop/bin

RUN \

  cd /usr/local && ln -s ./hadoop-${HADOOP_VERSION} hadoop && \

  rm -f ${HADOOP_PREFIX}/logs/*

WORKDIR $HADOOP_PREFIX

# Hdfs ports

EXPOSE 50010 50020 50070 50075 50090 8020 9000

# Mapred ports

EXPOSE 19888

#Yarn ports

EXPOSE 8030 8031 8032 8033 8040 8042 8088

#Other ports

EXPOSE 49707 2122
3. 准备应用的配置文件
因为我们只制作了一个 Hadoop 的镜像,而需要启动两个服务,这就要求在服务启动的时候必须加载不同的配置文件,现在我们只需要准备两个服务中需要同时用的的配置的部分。
YARN 依赖的配置在 artifacts 目录下,包含以下文件:
bootstrap.sh

capacity-scheduler.xml

container-executor.cfg

core-site.xml

hadoop-env.sh

hdfs-site.xml

log4j.properties

mapred-site.xml

nodemanager_exclude.txt

slaves

start-yarn-nm.sh

start-yarn-rm.sh

yarn-env.sh

yarn-site.xml
其中作为 bootstrap 启动脚本的 bootstrap.sh 也包含在该目录下,该脚本如何编写请见下文。
4. Kubernetes YAML 文件
根据业务的特性选择最适合的 kubernetes 的资源对象来运行,因为在 YARN 中 NodeManager 需要使用主机名向 ResourceManger 注册,因此需要沿用 YARN 原有的服务发现方式,使用 headless service 和 StatefulSet 资源。更多资料请参考 StatefulSet。
所有的 Kubernetes YAML 配置文件存储在 manifest 目录下,包括如下配置:
- yarn-cluster 的 namespace 配置
- Spark、ResourceManager、NodeManager 的 headless service 和 StatefulSet 配置
- 需要暴露到 kubernetes 集群外部的 ingress 配置(ResourceManager 的 Web)
kube-yarn-ingress.yaml

spark-statefulset.yaml

yarn-cluster-namespace.yaml

yarn-nm-statefulset.yaml

yarn-rm-statefulset.yaml
5. Bootstrap 脚本
Bootstrap 脚本的作用是在启动时根据 Pod 的环境变量、主机名或其他可以区分不同 Pod 和将启动角色的变量来修改配置文件和启动服务应用。
该脚本同时将原来 YARN 的日志使用 stdout 输出,便于使用 kubectl logs 查看日志或其他日志收集工具进行日志收集。
启动脚本 bootstrap.sh 跟 Hadoop 的配置文件同时保存在 artifacts 目录下。
该脚本根据 Pod 的主机名,决定如何修改 Hadoop 的配置文件和启动何种服务。bootstrap.sh 文件的部分代码如下:
if [[ "${HOSTNAME}" =~ "yarn-nm" ]]; then

  sed -i '/<\/configuration>/d' $HADOOP_PREFIX/etc/hadoop/yarn-site.xml

  cat >> $HADOOP_PREFIX/etc/hadoop/yarn-site.xml <<- EOM

  <property>

    <name>yarn.nodemanager.resource.memory-mb</name>

    <value>${MY_MEM_LIMIT:-2048}</value>

  </property>

  <property>

    <name>yarn.nodemanager.resource.cpu-vcores</name>

    <value>${MY_CPU_LIMIT:-2}</value>

  </property>

EOM

  echo '</configuration>' >> $HADOOP_PREFIX/etc/hadoop/yarn-site.xml

  cp ${CONFIG_DIR}/start-yarn-nm.sh $HADOOP_PREFIX/sbin/

  cd $HADOOP_PREFIX/sbin

  chmod +x start-yarn-nm.sh

  ./start-yarn-nm.sh

fi

if [[ $1 == "-d" ]]; then

  until find ${HADOOP_PREFIX}/logs -mmin -1 | egrep -q '.*'; echo "`date`: Waiting for logs..." ; do sleep 2 ; done

  tail -F ${HADOOP_PREFIX}/logs/* &

  while true; do sleep 1000; done

fi
从这部分中代码中可以看到,如果 Pod 的主机名中包含 yarn-nm 字段则向 yarn-site.xml配置文件中增加如下内容:
  <property>

    <name>yarn.nodemanager.resource.memory-mb</name>

    <value>${MY_MEM_LIMIT:-2048}</value>

  </property>

  <property>

    <name>yarn.nodemanager.resource.cpu-vcores</name>

    <value>${MY_CPU_LIMIT:-2}</value>

  </property>
其中 MY_MEM_LIMIT 和 MY_CPU_LIMIT 是 kubernetes YAML 中定义的环境变量,该环境变量又是引用的 Resource limit。
所有的配置准备完成后,执行 start-yarn-nm.sh 脚本启动 NodeManager。
如果 kubernetes YAML 中的 container CMD args 中包含 -d 则在后台运行 NodeManger 并 tail 输出 NodeManager 的日志到标准输出。
6. ConfigMaps
将 Hadoop 的配置文件和 bootstrap 脚本作为 ConfigMap 资源保存,用作 Pod 启动时挂载的 volume。
kubectl create configmap hadoop-config \

	  --from-file=artifacts/hadoop/bootstrap.sh \

	  --from-file=artifacts/hadoop/start-yarn-rm.sh \

	  --from-file=artifacts/hadoop/start-yarn-nm.sh \

	  --from-file=artifacts/hadoop/slaves \

	  --from-file=artifacts/hadoop/core-site.xml \

	  --from-file=artifacts/hadoop/hdfs-site.xml \

	  --from-file=artifacts/hadoop/mapred-site.xml \

	  --from-file=artifacts/hadoop/yarn-site.xml \

	  --from-file=artifacts/hadoop/capacity-scheduler.xml \

	  --from-file=artifacts/hadoop/container-executor.cfg \

	  --from-file=artifacts/hadoop/hadoop-env.sh \

	  --from-file=artifacts/hadoop/log4j.properties \

	  --from-file=artifacts/hadoop/nodemanager_exclude.txt \

	  --from-file=artifacts/hadoop/yarn-env.sh

kubectl  create configmap spark-config \

	  --from-file=artifacts/spark/spark-bootstrap.sh \

	  --from-file=artifacts/spark/spark-env.sh \

	  --from-file=artifacts/spark/spark-defaults.conf
所有的配置完成后,可以可以使用 kubectl 命令来启动和管理集群了,我们编写了 Makefile,您可以直接使用该 Makefile 封装的命令实现部分的自动化。
参考:
https://www.kubernetes.org.cn/2568.html
传统应用迁移到kubernetes(Hadoop YARN)的更多相关文章
- hadoop yarn
简介: 本文介绍了 Hadoop 自 0.23.0 版本后新的 map-reduce 框架(Yarn) 原理,优势,运作机制和配置方法等:着重介绍新的 yarn 框架相对于原框架的差异及改进:并通过 ...
- Hadoop Yarn框架原理解析
在说Hadoop Yarn的原理之前,我们先来看看Yarn是怎样出现的.在古老的Hadoop1.0中,MapReduce的JobTracker负责了太多的工作,包括资源调度,管理众多的TaskTrac ...
- Hadoop Yarn框架详细解析
在说Hadoop Yarn之前,我们先来看看Yarn是怎样出现的.在古老的Hadoop1.0中,MapReduce的JobTracker负责了太多的工作,包括资源调度,管理众多的TaskTracker ...
- 微服务开发有道之把项目迁移到Kubernetes上的5个小技巧
我们将在本文中提供5个诀窍帮你将项目迁移到Kubernetes上,这些诀窍来源于过去12个月中OpenFaas社区的经验.下文的内容与Kubernetes 1.8兼容,并且已经应用于OpenFaaS ...
- [BigData - Hadoop - YARN] YARN:下一代 Hadoop 计算平台
Apache Hadoop 是最流行的大数据处理工具之一.它多年来被许多公司成功部署在生产中.尽管 Hadoop 被视为可靠的.可扩展的.富有成本效益的解决方案,但大型开发人员社区仍在不断改进它.最终 ...
- Apache Hadoop YARN: 背景及概述
从2012年8月开始Apache Hadoop YARN(YARN = Yet Another Resource Negotiator)成了Apache Hadoop的一项子工程.自此Apache H ...
- 深入浅出 Hadoop YARN
一. Hadoop Yarn 是什么 在古老的 Hadoop1.0 中,MapReduce 的 JobTracker 负责了太多的工作,包括资源调度,管理众多的 TaskTracker 等工作.这自然 ...
- Hadoop - YARN 概述
一 概述 Apache Hadoop YARN (Yet Another Resource Negotiator,还有一种资源协调者)是一种新的 Hadoop 资源管理器,它是一个通用资源 ...
- YARN分析系列之二 -- Hadoop YARN各个自模块说明
先做如下声明,本代码版本是基于 3.1.2 版本. 其实,我们自己在写代码的时候,会有意识地将比较大的功能项独立成包,独立成module, 独立成项目,项目之间的关系既容易阅读理解,又便于管理. 如下 ...
随机推荐
- 配置Tomcat配置路径
<Host name="localhost" appBase="webapps" unpackWARs="true" autoDepl ...
- apiCloud 选择图片,选择视频,压缩图片
选择视频或图片,只需要一个 UIMediaScanner 模板就可以实现,点击链接查看api https://docs.apicloud.com/Client-API/UI-Layout/UIMedi ...
- Windows下如何使用Heroku
1. 安装 进入https://devcenter.heroku.com/articles/heroku-cli#windows,选择对应版本安装 安装后使用heroku -v可检查版本号 2. 登陆 ...
- 数据库连接的WEB登录界面的实现
要实现此功能,需要电脑安装JAVA EE.SQL Server 2008和Tomcat等软件,并进行配置环境成功. 对这门课的希望和自己的目标: 希望:可以完全掌握老师所讲的内容. 目标:能够完整的做 ...
- git merge和git rebase的区别
git merge是用来合并两个分支的.# 将b分支合并到当前分支git merge b git cherry-pick可以选择某一个分支中的一个或几个commit(s)来进行操作.例如,假设我 们有 ...
- leetcode-algorithms-29 Divide Two Integers
leetcode-algorithms-29 Divide Two Integers Given two integers dividend and divisor, divide two integ ...
- java设计模式之生产者/消费者模式
什么是生产者/消费者模式? 某个模块负责产生数据,这些数据由另一个模块来负责处理(此处的模块是广义的,可以是类.函数.线程.进程等).产生数据的模块,就形象地称为生产者:而处理数据的模块,就称为消费者 ...
- 安卓AlertDialog 的使用
引入空间 import android.support.v7.app.AlertDialog; import android.support.v7.app.AppCompatActivity; fin ...
- HDU-2767-tarjan/Kosaraju求scc
http://acm.hdu.edu.cn/showproblem.php?pid=2767 问最少添加几条边使得图为强连通. tarjan跑一下,然后对强连通分量缩点,找下此时出度为零和入度为零的点 ...
- python中的IO模块
1.简介 读写文件是常见的IO操作,python内置了读写文本的函数. 读写文件的模式描述如下: 模式 描述 r 以只读方式打开文件.文件的指针将会放在文件的开头.这是默认模式. rb 以二进制格式打 ...