
近端梯度算法(Proximal Gradient Descent)
L1正则化是一种常用的获取稀疏解的手段,同时L1范数也是L0范数的松弛范数。求解L1正则化问题最常用的手段就是通过加速近端梯度算法来实现的。
考虑一个这样的问题:
minx f(x)+λg(x)
x∈Rn,f(x)∈R,这里f(x)是一个二阶可微的凸函数,g(x)是一个凸函数(或许不可导),如上面L1的正则化||x||。
此时,只需要f(x)满足利普希茨(Lipschitz)连续条件,即对于定义域内所有向量x,y,存在常数M使得||f'(y)-f'(x)||<=M·||y-x||,那么这个模型就可以通过近端梯度算法来进行求解了。
ps:下面涉及很多数学知识,不想了解数学的朋友请跳到结论处,个人理解,所以也不能保证推理很严谨,如有问题,请一定帮忙我告诉我。
利普希茨连续条件的几何意义可以认为是函数在定义域内任何点的梯度都不超过M(梯度有上限),也就是说不会存在梯度为正负无穷大的情况。
因而,我们有下图所示的推算:
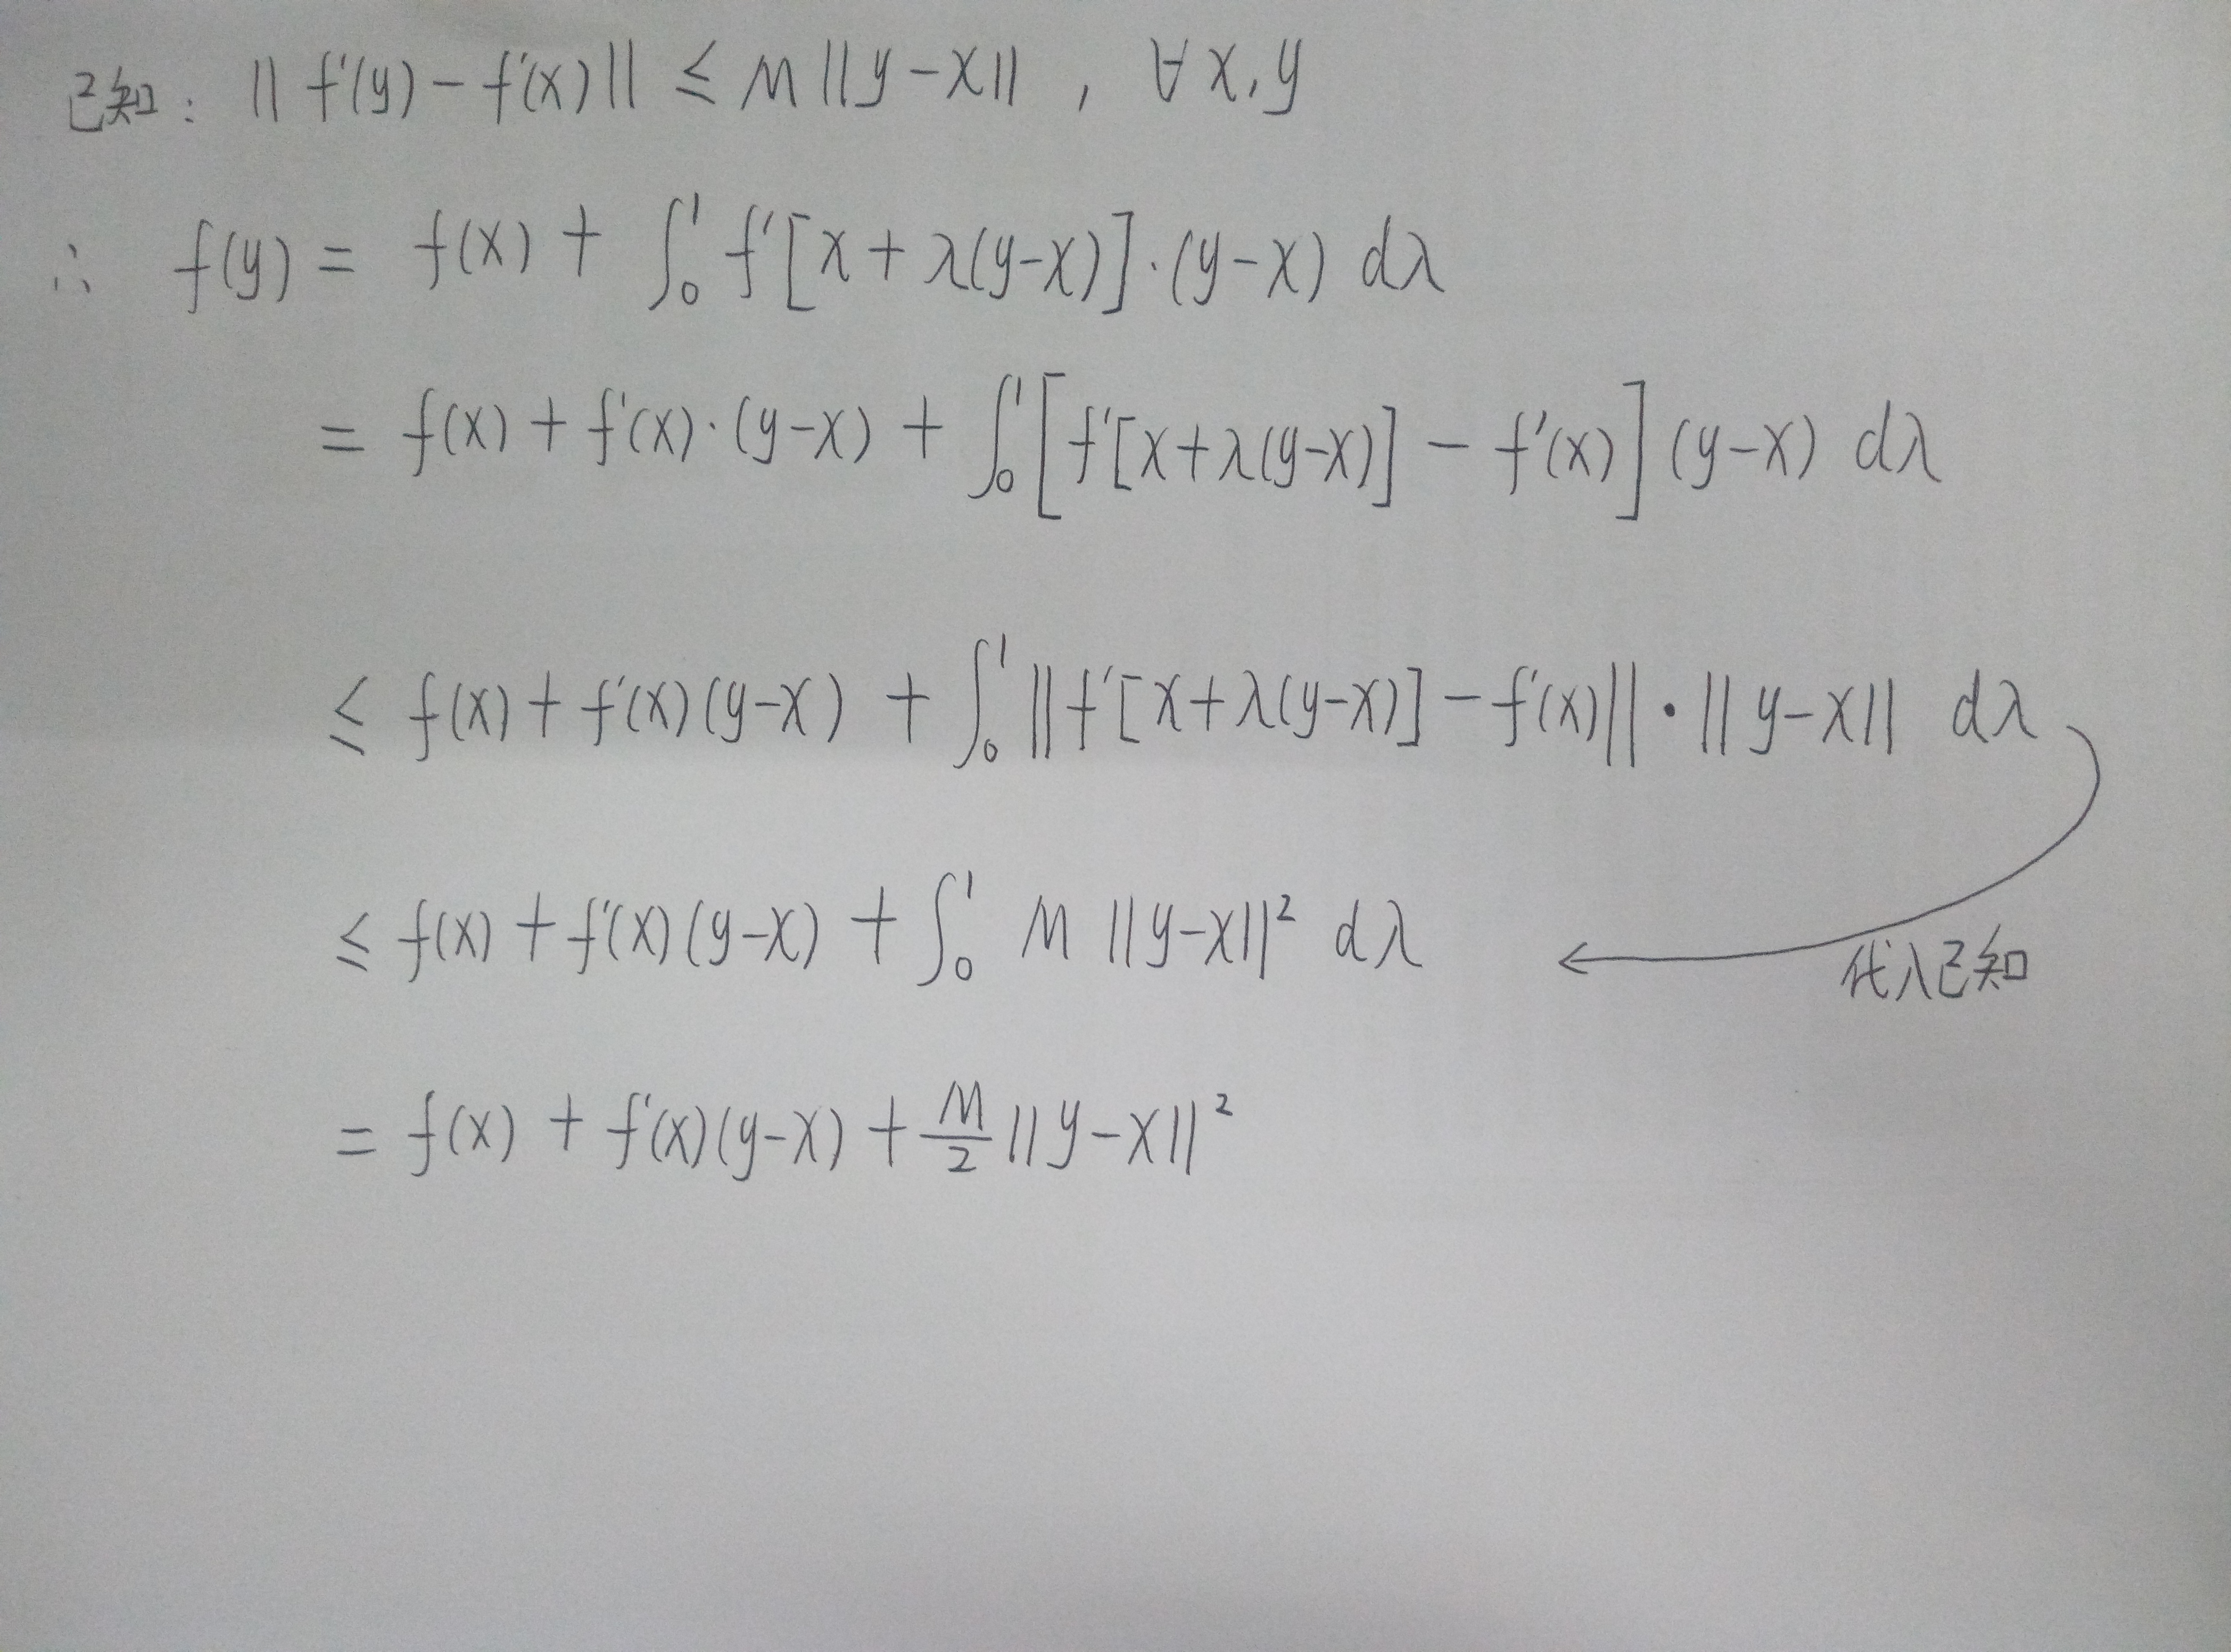
我们可以用f(y) = f(x)+f'(x)(y-x)+M/2*||y-x||2来近似的表示f(y),也可以认为是高维下的泰勒分解,取到二次项。
我们换一种写法,f(xk+1) = f(xk)+f'(xk)(xk+1-xk)+M/2*||xk+1-xk||2,也就是说可以直接迭代求minx f(x),就是牛顿法辣。
再换一种写法,f(xk+1)=(M/2)(xk+1-(xk+(1/M)f'(xk)))2+CONST,其中CONST是一个与xk+1无关的常数,也就是说,此时我们可以直接写出这个条件下xk+1的最优取值就是xk+1=xk+(1/M)f'(xk)。令z=xk+(1/M)f'(xk)。
回到原问题,minx f(x)+λg(x),此时问题变为了求解minx (M/2)||x-z||2+λg(x)。
实际上在求解这个问题的过程中,x的每一个维度上的值是互不影响的,可以看成n个独立的一维优化问题进行求解,最后组合成一个向量就行。
如果g(x)=||x||1,就是L1正则化,那么最后的结论可以通过收缩算子来表示。
即xk+1=shrink(z,λ/M)。具体来说,就是Z向量的每一个维度向原点方向移动λ/M的距离(收缩,很形象),对于xk+1的第i个维度xi=sgn(zi)*max(|zi|-λ/M,0),其中sgn()为符号函数,正数为1,负数为-1。
一直迭代直到xk收敛吧。
参考文献:
[1]Nesterov Y. Introductory lectures on convex optimization: A basic course[M]. Springer Science & Business Media, 2013.
[2]https://people.eecs.berkeley.edu/~elghaoui/Teaching/EE227A/lecture18.pdf
近端梯度算法(Proximal Gradient Descent)的更多相关文章
- Proximal Gradient Descent for L1 Regularization(近端梯度下降求解L1正则化问题)
假设我们要求解以下的最小化问题: $min_xf(x)$ 如果$f(x)$可导,那么一个简单的方法是使用Gradient Descent (GD)方法,也即使用以下的式子进行迭代求解: $x_{k+1 ...
- 梯度下降(Gradient Descent)小结
在求解机器学习算法的模型参数,即无约束优化问题时,梯度下降(Gradient Descent)是最常采用的方法之一,另一种常用的方法是最小二乘法.这里就对梯度下降法做一个完整的总结. 1. 梯度 在微 ...
- Proximal Gradient Descent for L1 Regularization
[本文链接:http://www.cnblogs.com/breezedeus/p/3426757.html,转载请注明出处] 假设我们要求解以下的最小化问题: ...
- 梯度下降(Gradient Descent)
在求解机器学习算法的模型参数,即无约束优化问题时,梯度下降(Gradient Descent)是最常采用的方法之一,另一种常用的方法是最小二乘法.这里就对梯度下降法做一个完整的总结. 1. 梯度 在微 ...
- 梯度下降(Gradient Descent)相关概念
梯度,直观理解: 梯度: 运算的对像是纯量,运算出来的结果会是向量在一个标量场中, 梯度的计算结果会是"在每个位置都算出一个向量,而这个向量的方向会是在任何一点上从其周围(极接近的周围,学过 ...
- One-hot 编码/TF-IDF 值来提取特征,LAD/梯度下降法(Gradient Descent),Sigmoid
1. 多值无序类数据的特征提取: 多值无序类问题(One-hot 编码)把“耐克”编码为[0,1,0],其中“1”代表了“耐克”的中 间位置,而且是唯一标识.同理我们可以把“中国”标识为[1,0],把 ...
- [机器学习] ML重要概念:梯度(Gradient)与梯度下降法(Gradient Descent)
引言 机器学习栏目记录我在学习Machine Learning过程的一些心得笔记,涵盖线性回归.逻辑回归.Softmax回归.神经网络和SVM等等,主要学习资料来自网上的免费课程和一些经典书籍,免费课 ...
- ML:梯度下降(Gradient Descent)
现在我们有了假设函数和评价假设准确性的方法,现在我们需要确定假设函数中的参数了,这就是梯度下降(gradient descent)的用武之地. 梯度下降算法 不断重复以下步骤,直到收敛(repeat ...
- 机器学习基础——梯度下降法(Gradient Descent)
机器学习基础--梯度下降法(Gradient Descent) 看了coursea的机器学习课,知道了梯度下降法.一开始只是对其做了下简单的了解.随着内容的深入,发现梯度下降法在很多算法中都用的到,除 ...
随机推荐
- Jenkins临时空间不足处理办法
环境: Jenkins版本 jenkins-2.89.4Jenkins 主从都在一台主机os版本 redhat7.2 使用yum的方式安装jenkins 发现在7.2上安装,剩余临时空间很小,通过登陆 ...
- Fragment+FragmentActivity出现The specified child already has a parent. You must call removeView() on the child's parent first.
这个异常是出现在Fragment中的onCreateView方法中初始化布局时发生的. View view = inflater.inflate(R.layout.fragment3_layout, ...
- [03-01] JSP自定义标签
1.自定义标签的概念 目前我们在JSP中使用的标签都是HTML的标签,浏览器会自动解析运行,例如<form action=""></form>,这里的for ...
- 用c#开发微信 系列汇总 - z
http://www.cnblogs.com/txw1958/ http://www.cnblogs.com/fengwenit/p/4505062.html
- c# 获取文件本身的哈希值
1. 哈希值是什么 我个人认为,哈希值是一个统称,也就是经过加密算法后得出的长度较短.位数固定的输出序列即散列值,这个哈希值是一个凭证,一个数字签名之类的,唯一对应你加密之前的东西,这都是我自个儿觉得 ...
- [Spark][Python]Spark 访问 mysql , 生成 dataframe 的例子:
[Spark][Python]Spark 访问 mysql , 生成 dataframe 的例子: mydf001=sqlContext.read.format("jdbc").o ...
- GBDT和随机森林的区别
GBDT和随机森林的相同点: 1.都是由多棵树组成 2.最终的结果都是由多棵树一起决定 GBDT和随机森林的不同点: 1.组成随机森林的树可以是分类树,也可以是回归树:而GBDT只由回归树组成 2.组 ...
- [HNOI2018]游戏[拓扑排序]
题意 题目链接 分析 先将没有锁的房间缩点,首先有一个 \(O(n^2)\) 的想法:从每个点出发,每次检查能否向两边扩张. 容易发现门和门之间如果有锁,必然只有一方能够开锁(只有一把钥匙),并且能够 ...
- Js把Json序列化为Java接受的对象。
服务器端 Java定义 data class role(var name: String = "", var remark: String = "") data ...
- bootstrap面试题
1.你能描述一下渐进增强和优雅降级之间的不同吗? 优雅降级:Web站点在所有新式浏览器中都能正常工作,如果用户使用的是老式浏览器,则代码会检查以确认它们是否能正常工作.由于IE独特的盒模型布局问题,针 ...