
SQL 强化练习 (十)
这一周都被客户搞得很惨.... 项目主流程不推进, 尽搞一些无关紧要的事情, 什么界面 ui 美化, 增加什么按钮进度条, 模糊查询...各种乱七八糟的需求, 挡都挡不住呀... 真的是把我当全栈使了, 数据库, 建表; 填报页面, 数据清洗, ui 美化, 权限配置 sql ... 真的太难了.... 发现核心呢, 还是 sql 的比重特别大, 像我们现在数据分析用的 BI 工具, 就是 以 SQL为基础的. 反而, 用 Pyhton 的地方却是很少, 跟我之前的项目差别很大, 这里用Pyhton 就只是一些做数据清洗的事情, 如过滤数据中的特殊字符 (正则) , 类型转换, 顺序调整的... 核心竞争还是 sql 呀. 果然 sql 非常强大. 继续练习呀...
表关系

我平时遇到的一些复杂些的业务场景, 基本也跟着几张表, 背后的相同逻辑所演变的. 都差不多的其实.
需求 01
查询各科成绩最高分, 最低分和平均分; 显示需求如下:
课程id, 课程 name, 最高分, 最低分, 平均分, 及格率, 中等率, 优良率, 优秀率
及格 >= 60; 中等:70-80; 优良: 80-90; 优秀: >=90
分析
目测会用到 group by case when ...
首先来查询, 课程的最高, 最低, 平均分的 (聚合函数, 肯定是结合 group by)
select

  a.c_id,

  b.c_name,

  max(a.score),

  min(a.score),

  avg(a.score)

from score  as a

-- 课程 name 是需要关联课程表才能拿到

inner join course as b

  on a.c_id = b.c_id

group by a.c_id, b.c_name
+------+--------+--------------+--------------+--------------+

| c_id | c_name | max(a.score) | min(a.score) | avg(a.score) |

+------+--------+--------------+--------------+--------------+

| 0001 | 语文   |           80 |           80 |      80.0000 |

| 0002 | 数学   |           90 |           60 |      76.6667 |

| 0003 | 英语   |           99 |           80 |      86.3333 |

+------+--------+--------------+--------------+--------------+

3 rows in set (0.01 sec)
这一部分其实还好, 就是基本的 group by 再聚合而已.
接着来算这些什么中等率, 优良率, 优秀率.. 就有些头疼了. 率, 是要用 目标人数 / 总人数 这样的方式. 立马会想到用 count 但, 这里多条件判断嘛, 必然会用 case when 来处理呀. 其实呢, 用 sum 可能会更加普遍一点. 满足条件就舌标记为1, 否则标记 0 这样的方式.
select

  a.c_id,

  b.c_name,

  max(a.score),

  min(a.score),

  avg(a.score),

  -- 及格率

  sum(case when a.score >= 60 then 1 else 0 end) / count(a.s_id) "及格率",

  -- 中等率

  sum(case when a.score >= 70 and a.score < 80 then 1 else 0 end) / count(a.s_id) "中等率",

  -- 优良率

  sum(case when a.score >= 80 and a.score < 90 then 1 else 0 end) / count(a.s_id) "优良率",

  -- 优秀率

  sum(case when a.score >= 90 then 1 else 0 end) / count(a.s_id) as "优秀率"

from score  as a

-- 课程 name 是需要关联课程表才能拿到

inner join course as b

  on a.c_id = b.c_id

group by c_id, c_name
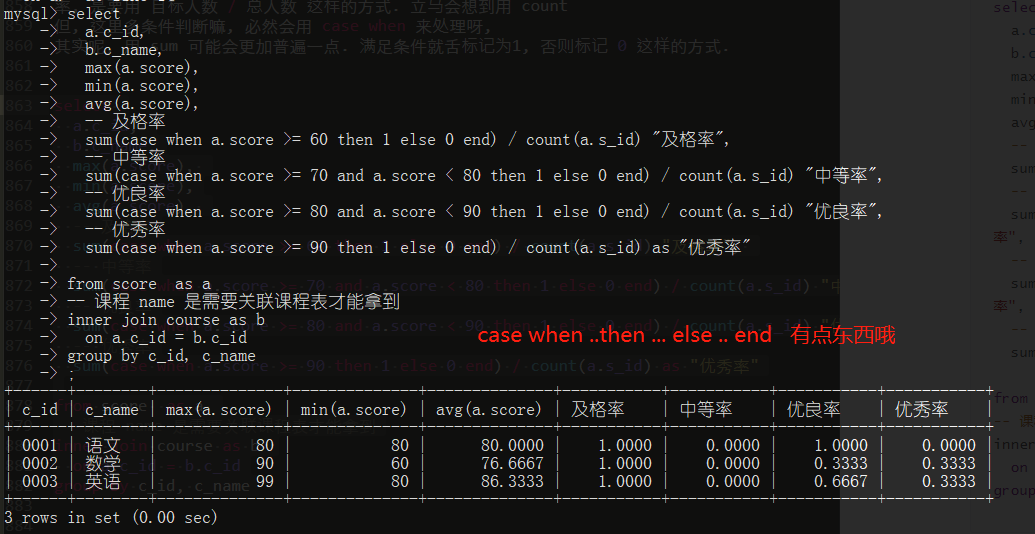
这个例子的关键点, 首先还是基于分组, 聚合 的用法, 中间过程呢, 会涉及表的拼接(inner join). 然后是 case when 可用来做条件计数 这个感觉蛮厉害的, 我其实在工作中都没用过. 类似的我都用 Python 来搞了, 没想到这 sql 原来还这么强大的哦.
需求 02
查询学生的总成绩, 并进行排名
分析
一个基础送分题, 按 s_id 分组, 对 score 统计即可.
select

  s_id as "学号",

  sum(score) as "总成绩"

from score

group by s_id
+--------+-----------+

| 学号   | 总成绩    |

+--------+-----------+

| 0001   |       269 |

| 0002   |       140 |

| 0003   |       240 |

+--------+-----------+

3 rows in set (0.00 sec)

mysql>
然后排序一波即可. (把姓名也 inner join 过来顺带)
select

  a.s_id as "学号",

  b.s_name as "姓名",

  sum(a.score) as "总成绩"

from score as a

-- 学生信息帖过来

inner join student as b

  on a.s_id = b.s_id

group by a.s_id, b.s_name

order by sum(score) desc
+--------+-----------+-----------+

| 学号   | 姓名      | 总成绩    |

+--------+-----------+-----------+

| 0001   | 王二      |       269 |

| 0003   | 胡小适    |       240 |

| 0002   | 星落      |       140 |

+--------+-----------+-----------+

3 rows in set (0.00 sec)
-- 这一句感觉怪怪的, 应该用上面别名的.

order by sum(score) desc
最后修改如下:
select

  a.s_id as 学号,

  b.s_name as 姓名,

  sum(a.score) as 总成绩

from score as a

-- 学生信息帖过来

inner join student as b

  on a.s_id = b.s_id

group by a.s_id, b.s_name

order by 总成绩 desc
+--------+-----------+-----------+

| 学号   | 姓名      | 总成绩    |

+--------+-----------+-----------+

| 0001   | 王二      |       269 |

| 0003   | 胡小适    |       240 |

| 0002   | 星落      |       140 |

+--------+-----------+-----------+

3 rows in set (0.00 sec)
可以, 发现, 在 mysql 中, 可以直接用 中文 作为别名.
小结
- sum(case when ..then 1 else 0 end) 可以用来进行 条件计数哦 (配合 group by )
- 表 join 可以在中途进行, 理清楚 sql 的执行顺序即可 from > on > join > where > group by > having > select > distinct > order by
- 发现 mysql 中, 别名可以直接使用中文, 比如 之前是 xxx as "总成绩", 也可直接 xxx as 总成绩 .
SQL 强化练习 (十)的更多相关文章
- 强化学习(十九) AlphaGo Zero强化学习原理
在强化学习(十八) 基于模拟的搜索与蒙特卡罗树搜索(MCTS)中,我们讨论了MCTS的原理和在棋类中的基本应用.这里我们在前一节MCTS的基础上,讨论下DeepMind的AlphaGo Zero强化学 ...
- 强化学习(十六) 深度确定性策略梯度(DDPG)
在强化学习(十五) A3C中,我们讨论了使用多线程的方法来解决Actor-Critic难收敛的问题,今天我们不使用多线程,而是使用和DDQN类似的方法:即经验回放和双网络的方法来改进Actor-Cri ...
- 强化学习(十五) A3C
在强化学习(十四) Actor-Critic中,我们讨论了Actor-Critic的算法流程,但是由于普通的Actor-Critic算法难以收敛,需要一些其他的优化.而Asynchronous Adv ...
- 强化学习(十四) Actor-Critic
在强化学习(十三) 策略梯度(Policy Gradient)中,我们讲到了基于策略(Policy Based)的强化学习方法的基本思路,并讨论了蒙特卡罗策略梯度reinforce算法.但是由于该算法 ...
- SQL入门经典(十) 之事务
事务是什么?事务关键在与其原子性.原子性概念是指可以把一些事情当作一个执行单元来看待.从数据库角度看待.他是指应该全部执行或者全部不执行一条或多条语句的最小组合.当处理数据时候经常确保一件事发生另一件 ...
- SQL强化(一)保险业务
保险业务 : 表结构 : sql语句 : /*1. 根据投保人电话查询出投保人 姓名 身份证号 所有保单 编号 险种 缴费类型*/SELECTt2.cust_name,t2.idcard,t4.pro ...
- 强化学习(十八) 基于模拟的搜索与蒙特卡罗树搜索(MCTS)
在强化学习(十七) 基于模型的强化学习与Dyna算法框架中,我们讨论基于模型的强化学习方法的基本思路,以及集合基于模型与不基于模型的强化学习框架Dyna.本文我们讨论另一种非常流行的集合基于模型与不基 ...
- 强化学习(十二) Dueling DQN
在强化学习(十一) Prioritized Replay DQN中,我们讨论了对DQN的经验回放池按权重采样来优化DQN算法的方法,本文讨论另一种优化方法,Dueling DQN.本章内容主要参考了I ...
- SQL强化练习(面试与学习必备)
一.经典选课题A 1.1.请同时使用GUI手动与SQL指令的形式创建数据库.表并添加数据. 题目:设有一数据库,包括四个表:学生表(Student).课程表(Course).成绩表(Score)以及教 ...
- SQL语句(十二)分组查询
(十二)分组查询 将数据表中的数据按某种条件分成组,按组显示统计信息 查询各班学生的最大年龄.最小年龄.平均年龄和人数 分组 SELECT <字段名表1> FROM <表名> ...
随机推荐
- 在python中通过模型api
前言 首先我选择的siliconflow(硅基流动)平台来调用它的api,无为啥,就是因为我点击了别人的邀请链接它送了我14块余额,那个人同样也获得14块余额 这时候,就不得不说一下我的邀请链接了ht ...
- Element-UI 使用心得之el-card
el-card 是Element-UI 内置的卡片组件,使用起来很方便,但是对Vuejs和html 不是精通的话,根据自己的要求布局,会出现自己的小困惑,必须添加垂直居中,按照CSS 布局设置,总是 ...
- QT5笔记:27. MDI应用程序设计
MDI:Multiple Document Interface 多窗口文档界面 例子: MainWindow.h #ifndef MAINWINDOW_H #define MAINWINDOW_H # ...
- Kettle - hello world
Kettle下载页面:点这里 Kettle 版本:pdi-ce-9.4.0.0-343 流程概览 详细步骤 1.首先打开Kettle的Spoon.bat 2.在主对象树中选择转换 3.然后在核心对象的 ...
- 大数据之路Week08_day02 (Flume架构介绍和安装)
Flume架构介绍和安装 写在前面在学习一门新的技术之前,我们得知道了解这个东西有什么用?我们可以使用它来做些什么呢?简单来说,flume是大数据日志分析中不能缺少的一个组件,既可以使用在流处理中,也 ...
- centos 8 编译*.cpp文件
1.安装g++ yum -y install gcc-c++ 2.编译*.cpp文件 g++ -o test_app_name test_source_file.cpp 3.运行编译结果 ./test ...
- C# .net 压缩文件解压上传及文件压缩下载
using ICSharpCode.SharpZipLib.Zip; using System; using System.Collections.Generic; using System.IO; ...
- Java Map一些基本使用方法
1 // Map key值不能相同,value值可以相同 2 // HashMap中的Entry对象是无序排列的 3 4 // 实例化1 5 Map<String, String> map ...
- 【Matlab】基于KDtree的最近邻搜索和范围搜索
摘要:介绍Matlab的rangesearch()函数和knnsearch()函数. rangesearch() -- 根据给定k-维数据集,返回指定距离范围内的所有数据点 knnsearch() - ...
- 探秘Transformer系列之(12)--- 多头自注意力
探秘Transformer系列之(12)--- 多头自注意力 目录 探秘Transformer系列之(12)--- 多头自注意力 0x00 概述 0x01 研究背景 1.1 问题 1.2 根源 1.3 ...