
scrapy 之自定义命令运行所有爬虫文件
1、在spider文件夹同级目录创建commands python包
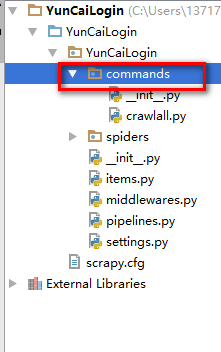
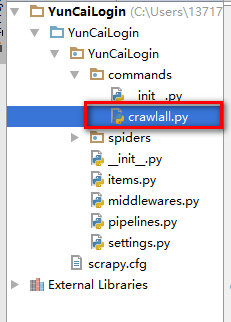
2、在包下创建command.py文件
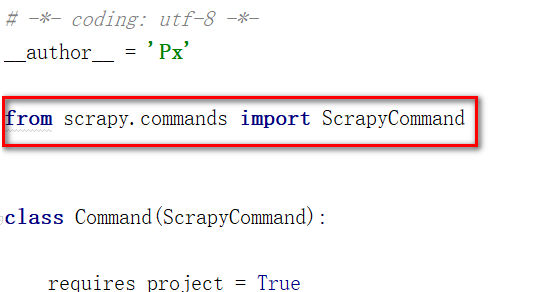
3、从scrapy.commands包下引入ScrapyCommand
4、创建一个类,继承ScrapyCommand
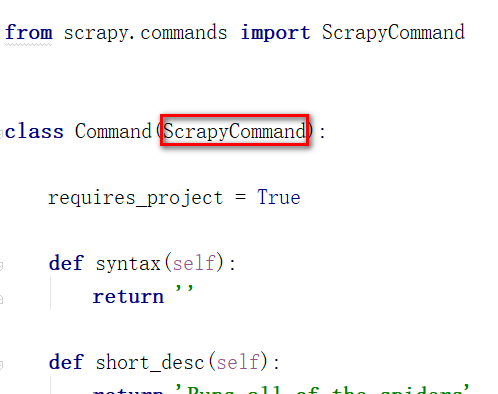
5、重新定义类变量 requires_project = True
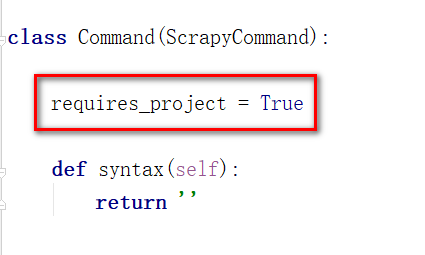
6、重写syntax short_desc方法,syntax返回空字符串 short_desc返回描述字符串

7、重写run方法。
8、在settings.py 中添加配置 COMMANDS_MODULE = '项目名称.目录名称'
def run(self, args, opts):

    spider_list = self.crawler_process.spiders.list()    #通过self.crawler_process.spider.list()获得所有爬虫

    for name in spider_list:                    #遍历所有爬虫

        self.crawler_process.crawl(name, **opts.__dict__)  #运行爬虫

    self.crawler_process.start()                  #启动进程
crawler_process 来自父类

完整代码
# -*- coding: utf-8 -*-

__author__ = 'Px'

from scrapy.commands import ScrapyCommand

class Command(ScrapyCommand):

    requires_project = True

    def syntax(self):

        return ''

    def short_desc(self):

        return 'Runs all of the spiders'

    def run(self, args, opts):

        spider_list = self.crawler_process.spiders.list()

        for name in spider_list:

            self.crawler_process.crawl(name, **opts.__dict__)

        self.crawler_process.start()
scrapy 之自定义命令运行所有爬虫文件的更多相关文章
- scrapy电影天堂实战(二)创建爬虫项目
公众号原文 创建数据库 我在上一篇笔记中已经创建了数据库,具体查看<scrapy电影天堂实战(一)创建数据库>,这篇笔记创建scrapy实例,先熟悉下要用到到xpath知识 用到的xpat ...
- 第三百四十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制
第三百四十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制 用命令创建自动爬虫文件 创建爬虫文件是根据scrap ...
- 二十三 Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制
用命令创建自动爬虫文件 创建爬虫文件是根据scrapy的母版来创建爬虫文件的 scrapy genspider -l 查看scrapy创建爬虫文件可用的母版 Available templates: ...
- Scrapy的shell命令(转)
scrapy python MrZONT 2015年08月29日发布 ...
- scrapy框架--新建调试的main.py文件
一.原因: 由于pycharm中没有scrapy的一个模板,所有没办法直接在scrapy文件中调试,所有我们需要写一个自己的main.py文件,在文件里面调用命令行,来实现scrapy的一个调试.(在 ...
- scrapy框架的命令行解释
scrapy框架的命令解释 创建爬虫项目 scrapy startproject 项目名例子如下: scrapy startproject test1 这个时候爬虫的目录结构就已经创建完成了,目录结构 ...
- python+pytest,通过自定义命令行参数,实现浏览器兼容性跑用例
场景拓展: UI自动化可能需要指定浏览器进行测试,为了做成自定义配置浏览器,可以通过动态添加pytest的命令行参数,在执行的时候,获取命令行传入的参数,在对应的浏览器执行用例. 1.自动化用例需要支 ...
- Scrapy 框架,爬虫文件相关
Spiders 介绍 由一系列定义了一个网址或一组网址类如何被爬取的类组成 具体包括如何执行爬取任务并且如何从页面中提取结构化的数据. 简单来说就是帮助你爬取数据的地方 内部行为 #1.生成初始的Re ...
- scrapy 基础组件专题(六):自定义命令
写好自己的爬虫项目之后,可以自己定制爬虫运行的命令. 一.单爬虫 在项目的根目录下新建一个py文件,如命名为start.py,写入如下代码: from scrapy.cmdline import ex ...
随机推荐
- 【java】之位运算^,&,<<,>>,<<<,>>>总结
1.^(亦或运算) ,针对二进制,相同的为0,不同的为1 public static void main(String[] args) { System.out.println("2^3运算 ...
- Unix即IDE
前言 在图形界面下大家都想要这种能够集成在一起的工具,那是因为这类窗口应用除了用复制粘贴,没有别的方法使他们更好地协同工作,它们缺失一种 共用接口(common interface) . 有关这个问题 ...
- 【rabbitmq】RabbitMQ 集群与网络分区
网络分区(network partitions) 官网-网络分区 网络设备故障导致的网络分裂.比如,存在A\B\C\D\E五个节点,A\B处于同一子网,B\C\D处于另外一子网,中间通过交换机相连.若 ...
- 树莓派 nfs server安装
安装服务 sudo apt-get install portmap sudo apt-get install nfs-kernel-server 配置: sudo nano /etc/expo ...
- 从零开始编译Poco C++和VS2015环境配置
Poco C++是一个C++的开源框架,详细介绍可以问百度介绍更详细,这里我就记录下我从零编译poco-1.9.0和配置 VS2015的环境,以备不时之需. 步骤:一.安装cmake: 二.编译poc ...
- [UE4]Event Tick
一.每一帧都会触发Event Tick事件,“Delta Seconds”参数表示当前帧说花费的时间 二.因为各种原因(比如卡帧等),每一帧所花费的时间并不是相同的
- C&C++类型定义typedef
1.声明 1.1结构声明: struct { int n; double x,y; }; 1.2带结构标志的声明 struct point{ double x,y; }; 1.3定义结构类型 1.3. ...
- asp微信支付代码证书文件post_url.aspx和post_url.aspx.cs源码下载
很多朋友在网上找的asp支付代码中都没有这两个证书文件,只能是用别人的,但是如果别人把他的网站这个文件删了,你的支付也就不能用了,今天我就把大家需要的这两个asp微信支付代码证书文件post_url. ...
- stm32 uart 中断 蜜汁bug
在项目中,使用stm32f103,配置uart1接收RXNE中断,使用DMA来进行UART1的发送. 初始化代码如下: void uart_init(u32 bound) { GPIO_InitTyp ...
- jenkins部署前后端分离的vue项目
1 General Name: 变量名. 类似给分支起一个名字的意思, 可随意取 Description: 描述, 非必填 Parameter Type: 选择 Branch or Tag Defau ...