
二十三 Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制
用命令创建自动爬虫文件
创建爬虫文件是根据scrapy的母版来创建爬虫文件的
scrapy genspider -l 查看scrapy创建爬虫文件可用的母版
Available templates:母版说明
basic 创建基础爬虫文件
crawl 创建自动爬虫文件
csvfeed 创建爬取csv数据爬虫文件
xmlfeed 创建爬取xml数据爬虫文件
创建一个基础母版爬虫,其他同理
scrapy genspider -t 母版名称 爬虫文件名称 要爬取的域名 创建一个基础母版爬虫,其他同理
如:scrapy genspider -t crawl lagou www.lagou.com
第一步,配置items.py接收数据字段
default_output_processor = TakeFirst()默认利用ItemLoader类,加载items容器类填充数据,是列表类型,可以通过TakeFirst()方法,获取到列表里的内容
input_processor = MapCompose(预处理函数)设置数据字段的预处理函数,可以是多个函数

# -*- coding: utf-8 -*-

# Define here the models for your scraped items

#

# See documentation in:

# http://doc.scrapy.org/en/latest/topics/items.html

#items.py,文件是专门用于,接收爬虫获取到的数据信息的,就相当于是容器文件

import scrapy

from scrapy.loader.processors import MapCompose,TakeFirst

from scrapy.loader import ItemLoader                #导入ItemLoader类也就加载items容器类填充数据

class LagouItemLoader(ItemLoader):                  #自定义Loader继承ItemLoader类,在爬虫页面调用这个类填充数据到Item类

    default_output_processor = TakeFirst()          #默认利用ItemLoader类,加载items容器类填充数据,是列表类型,可以通过TakeFirst()方法,获取到列表里的内容

def tianjia(value):                                 #自定义数据预处理函数

    return '叫卖录音网'+value                        #将处理后的数据返给Item

class LagouItem(scrapy.Item):                       #设置爬虫获取到的信息容器类

    title = scrapy.Field(                           #接收爬虫获取到的title信息

        input_processor = MapCompose(tianjia),      #将数据预处理函数名称传入MapCompose方法里处理,数据预处理函数的形式参数value会自动接收字段title

    )
第二步,编写自动爬虫与利用ItemLoader类加载items容器类填充数据
自动爬虫
Rule()设置爬虫规则
参数:
LinkExtractor()设置url规则
callback='回调函数名称'
follow=True 表示在抓取页面继续深入
LinkExtractor()对爬虫获取到的url做规则判断处理
参数:
allow= r'jobs/' 是一个正则表达式,表示符合这个url格式的,才提取
deny= r'jobs/' 是一个正则表达式,表示符合这个url格式的,不提取抛弃掉,与allow相反
allow_domains= www.lagou.com/ 表示这个域名下的连接才提取
deny_domains= www.lagou.com/ 表示这个域名下的连接不提取抛弃
restrict_xpaths= xpath表达式 表示可以用xpath表达式限定爬虫只提取一个页面指定区域的URL
restrict_css= css选择器,表示可以用css选择器限定爬虫只提取一个页面指定区域的URL
tags= 'a' 表示爬虫通过a标签去寻找url,默认已经设置,默认即可
attrs= 'href' 表示获取到a标签的href属性,默认已经设置,默认即可
利用自定义Loader类继承ItemLoader类,加载items容器类填充数据
ItemLoader()实例化一个ItemLoader对象来加载items容器类,填充数据,如果是自定义Loader继承的ItemLoader同样的用法
参数:
第一个参数:要填充数据的items容器类注意加上括号,
第二个参数:response
ItemLoader对象下的方法:
add_xpath('字段名称','xpath表达式')方法,用xpath表达式获取数据填充到指定字段
add_css('字段名称','css选择器')方法,用css选择器获取数据填充到指定字段
add_value('字段名称',字符串内容)方法,将指定字符串数据填充到指定字段
load_item()方法无参,将所有数据生成,load_item()方法被yield后数据被填充items容器指定类的各个字段
爬虫文件
# -*- coding: utf-8 -*-

import scrapy

from scrapy.linkextractors import LinkExtractor

from scrapy.spiders import CrawlSpider, Rule

from adc.items import LagouItem,LagouItemLoader  #导入items容器类,和ItemLoader类

class LagouSpider(CrawlSpider):                     #创建爬虫类

    name = 'lagou'                                  #爬虫名称

    allowed_domains = ['www.luyin.org']             #起始域名

    start_urls = ['http://www.luyin.org/']          #起始url

    rules = (

        #配置抓取列表页规则

        Rule(LinkExtractor(allow=('ggwa/.*')), follow=True),

        #配置抓取内容页规则

        Rule(LinkExtractor(allow=('post/\d+.html.*')), callback='parse_job', follow=True),

    )

    def parse_job(self, response):                  #回调函数,注意:因为CrawlS模板的源码创建了parse回调函数,所以切记我们不能创建parse名称的函数

        #利用ItemLoader类,加载items容器类填充数据

        item_loader = LagouItemLoader(LagouItem(), response=response)

        item_loader.add_xpath('title','/html/head/title/text()')

        article_item = item_loader.load_item()

        yield article_item
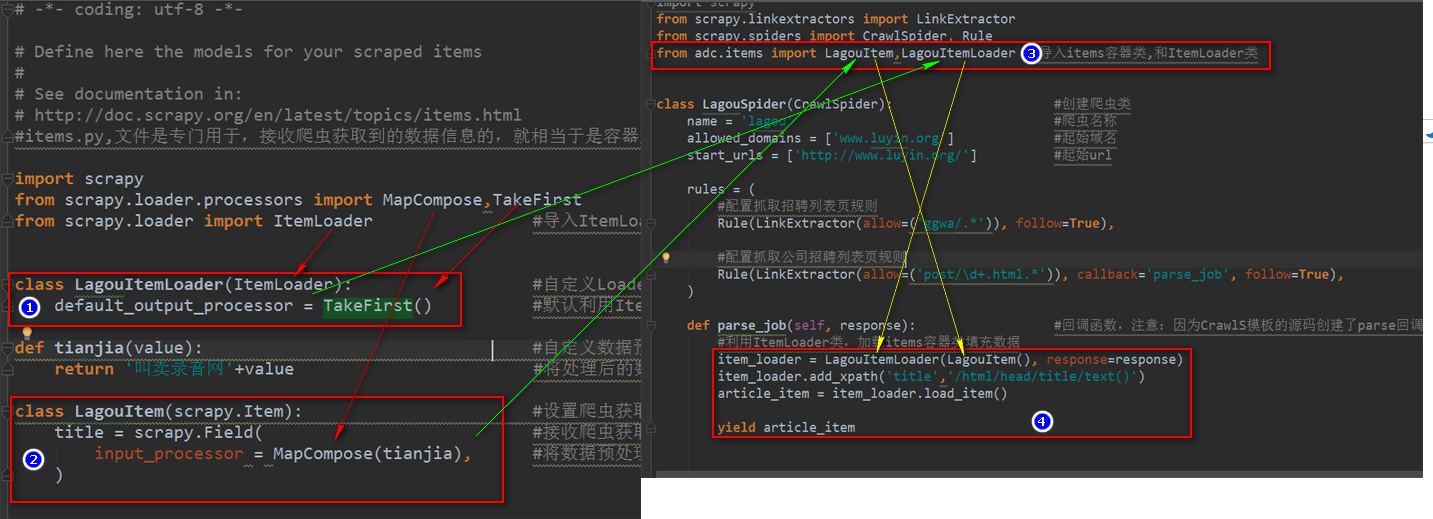
items.py文件与爬虫文件的原理图
二十三 Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制的更多相关文章
- 第三百四十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制
第三百四十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制 用命令创建自动爬虫文件 创建爬虫文件是根据scrap ...
- 第三百七十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门搜索
第三百七十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门 我的搜素简单实现原理我们可以用js来实现,首先用js获取到 ...
- 第三百五十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—利用开源的scrapy-redis编写分布式爬虫代码
第三百五十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—利用开源的scrapy-redis编写分布式爬虫代码 scrapy-redis是一个可以scrapy结合redis搭建分布式爬虫的开 ...
- 五十 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门搜索
第三百七十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门 我的搜素简单实现原理我们可以用js来实现,首先用js获取到 ...
- Python分布式爬虫打造搜索引擎完整版-基于Scrapy、Redis、elasticsearch和django打造一个完整的搜索引擎网站
Python分布式爬虫打造搜索引擎 基于Scrapy.Redis.elasticsearch和django打造一个完整的搜索引擎网站 https://github.com/mtianyan/Artic ...
- 第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目
第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目 scrapyd模块是专门用于部署scrapy项目的,可以部署和管理scrapy项目 下载地址:h ...
- 第三百七十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索结果分页
第三百七十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索结果分页 逻辑处理函数 计算搜索耗时 在开始搜索前:start_time ...
- 第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能
第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能 Django实现搜索功能 1.在Django配置搜索结果页的路由映 ...
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
随机推荐
- Objective-C中new与alloc/init的区别
在实际开发中很少会用到new,一般创建对象我们看到的全是[[className alloc] init],但是并不意味着你不会接触到new,在一些代码中还是会看到[className new],还有去 ...
- day6-面向对象
Python 面向对象 Python从设计之初就已经是一门面向对象的语言,正因为如此,在Python中创建一个类和对象是很容易的.本章节我们将详细介绍Python的面向对象编程. 如果你以前没有接触过 ...
- python全栈开发从入门到放弃之初识面向对象
面向过程 VS 面向对象 面向过程的程序设计的核心是过程(流水线式思维),过程即解决问题的步骤,面向过程的设计就好比精心设计好一条流水线,考虑周全什么时候处理什么东西. 优点是:极大的降低了写程序的复 ...
- WEB前端研发工程师编程能力成长之路(1)
[背景] 如果你是刚进入WEB前端研发领域,想试试这潭水有多深,看这篇文章吧: 如果你是做了两三年WEB产品前端研发,迷茫找不着提高之路,看这篇文章吧: 如果你是四五年的前端开发高手,没有难题能难得住 ...
- C# 各种导入 Excel 文件的数据的方法总结
在导入之前都需要将上传的文件保存到服务器,所以避免重复的写这些代码,先贴出上传文件并保存到服务器指定路径的代码. protected void btnImport_Click(object sende ...
- logstash安装
1.下载并安装公共签名密钥 rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearch 2.创建镜像源文件:/etc/yum.rep ...
- Python面试题目之(针对dict或者set数据类型)边遍历 边修改 报错dictionary changed size during iteration
# result 是一个字典, 把里面属性值是None的属性删除 for key in result: if not result[key]: del result[key] continue 但是报 ...
- JavaScript常用算法
一.排序算法 1.Array.sort(function)(JavaScript原生排序算法)参数:比较函数(可选)若无参数,则按照首字母的ASCII码排序,比较函数的作用为确定排序 function ...
- go channel 阻塞
初接触 go 有不对得请解释下 Channel是goroutine之间进行通信的一种方式,先看下面代码为什么会阻塞: func closer(ch chan int) { ch <- 1 log ...
- RS232引脚,RS485引脚
1.RS232引脚 2.RS485引脚