
selenium登录爬取知乎出现:请求异常请升级客户端后重试的问题(用Python中的selenium接管chrome)
一、问题
使用selenium自动化测试爬取知乎的时候出现了:错误代码10001:请求异常请升级客户端后重新尝试,这个错误的产生是由于知乎可以检测selenium自动化测试的脚本,因此可以阻止selenium的继续访问。这也算是比较高级的反爬取措施。
二、解决
解决方法,使用自己打开的一个浏览器,再用selenium接管这个浏览器这样就可以完成反爬的处理。
1.建议一个新的映射,以保存原来的chrome不被污染
1)添加环境变量
将chrome.exe放入系统环境变量中,找到驱动位置添加变量,如果没找到,最快的方法就是点击图标右键,点击访问文件地址
chrome.exe位置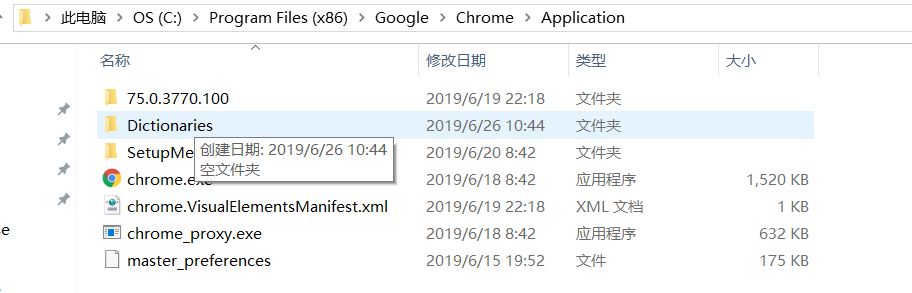
快捷访问方式,在菜单栏同样可以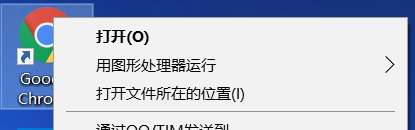
2)新建一个存放新环境的文件夹并映射
使用指令【chrome.exe --remote-debugging-port=9222 --user-data-dir="E:\data_info\selenium_data"】
其中--remote-debugging-port是建立新的移植位置,其中端口后面会使用(自定义), --user-data-dir是数据存储的目录(自定义)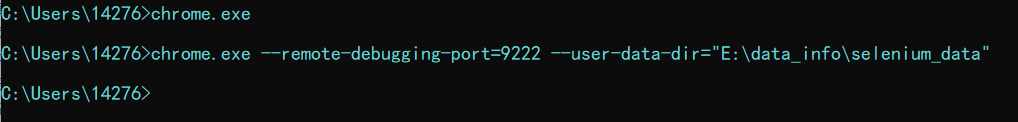
此时会打开一个网页放着就行
2.selenium代码接管
通过下面的代码就可以登录知乎
import time

import json

from selenium import webdriver

from selenium.webdriver.chrome.options import Options

from selenium.webdriver.support.ui import WebDriverWait

class ZhiHu:

    def __init__(self):

        self.url = 'https://www.zhihu.com/'

        self.chrome_options = Options()

        self.chrome_options.add_experimental_option("debuggerAddress", "127.0.0.1:9222")  #  前面设置的端口号

        self.browser = webdriver.Chrome(executable_path=r'E:\Environment\python_global\Scripts\chromedriver.exe', options=self.chrome_options)  # executable执行webdriver驱动的文件

    def get_start(self):

        self.browser.get(self.url)

        # time.sleep(20)  # 可以选择手动登录或者是自动化,我这里登录过就直接登陆了

        info = self.browser.get_cookies()  # 获取cookies

        print(info)

        with open(r"..\download_txt\info.json", 'w', encoding='utf-8') as f:

            f.write(json.dumps(info))

if __name__ == '__main__':

    zhihu = ZhiHu()

    zhihu.get_start()
三、结果展示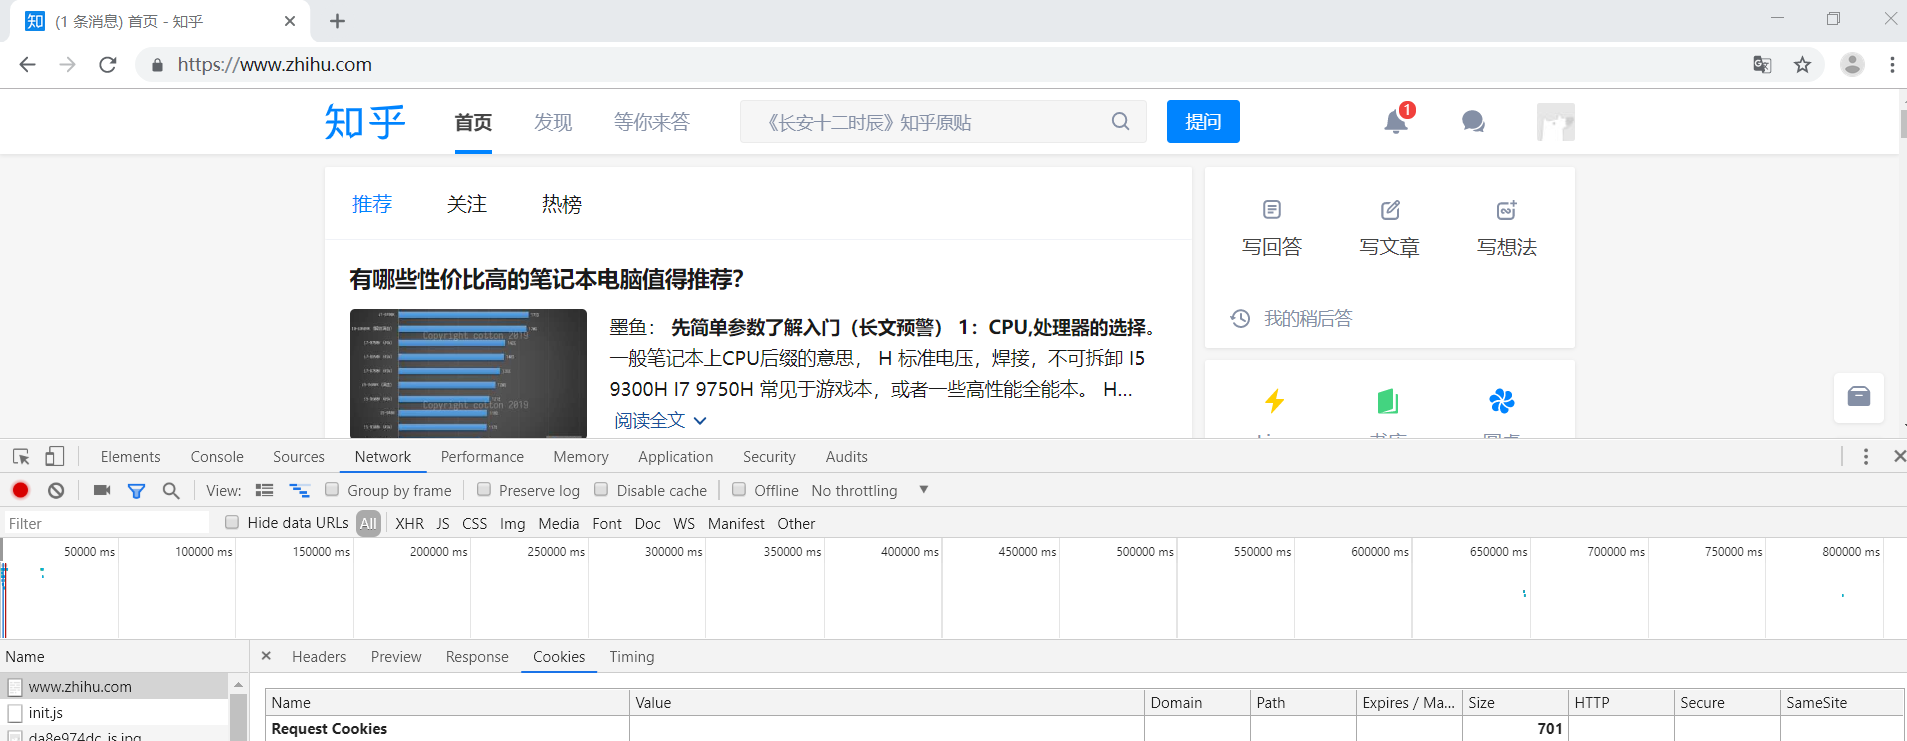
四、总结
利用这个selenium接管正在使用的浏览器就可以绕过知乎的反爬,当然也可以做更多的爬虫,selenium在爬虫的使用中还是有重要的地位,偷懒一点就可以使用这个。这种方法可以获取cookies这样在使用其他的爬虫,就可以使用这个cookies会加快爬取的效率,以及突破不适用浏览器的反爬措施。这引起我们另一个思考,我们直接接管我们正常的chrome好像更加的高效,这个可以以后的学习中尝试一下。
五、参考
附一些参考,方便自己学习,毕竟每次百度起来都很麻烦
https://www.cnblogs.com/HJkoma/p/9936434.htmlhttps://blog.csdn.net/qq_42206477/article/details/86477446
selenium登录爬取知乎出现:请求异常请升级客户端后重试的问题(用Python中的selenium接管chrome)的更多相关文章
- 第二个爬虫之爬取知乎用户回答和文章并将所有内容保存到txt文件中
自从这两天开始学爬虫,就一直想做个爬虫爬知乎.于是就开始动手了. 知乎用户动态采取的是动态加载的方式,也就是先加载一部分的动态,要一直滑道底才会加载另一部分的动态.要爬取全部的动态,就得先获取全部的u ...
- 通过scrapy,从模拟登录开始爬取知乎的问答数据
这篇文章将讲解如何爬取知乎上面的问答数据. 首先,我们需要知道,想要爬取知乎上面的数据,第一步肯定是登录,所以我们先介绍一下模拟登录: 先说一下我的思路: 1.首先我们需要控制登录的入口,重写star ...
- 使用python scrapy爬取知乎提问信息
前文介绍了python的scrapy爬虫框架和登录知乎的方法. 这里介绍如何爬取知乎的问题信息,并保存到mysql数据库中. 首先,看一下我要爬取哪些内容: 如下图所示,我要爬取一个问题的6个信息: ...
- scrapy 爬取知乎问题、答案 ,并异步写入数据库(mysql)
python版本 python2.7 爬取知乎流程: 一 .分析 在访问知乎首页的时候(https://www.zhihu.com),在没有登录的情况下,会进行重定向到(https://www. ...
- Python3.x:Selenium+PhantomJS爬取带Ajax、Js的网页
Python3.x:Selenium+PhantomJS爬取带Ajax.Js的网页 前言 现在很多网站的都大量使用JavaScript,或者使用了Ajax技术.这样在网页加载完成后,url虽然不改变但 ...
- scrapy爬取知乎某个问题下的所有图片
前言: 1.仅仅是想下载图片,别人上传的图片也是没有版权的,下载来可以自己欣赏做手机背景但不商用 2.由于爬虫周期的问题,这个代码写于2019.02.13 1.关于知乎爬虫 网上能访问到的理论上都能爬 ...
- 利用 Scrapy 爬取知乎用户信息
思路:通过获取知乎某个大V的关注列表和被关注列表,查看该大V和其关注用户和被关注用户的详细信息,然后通过层层递归调用,实现获取关注用户和被关注用户的关注列表和被关注列表,最终实现获取大量用户信息. 一 ...
- 教程+资源,python scrapy实战爬取知乎最性感妹子的爆照合集(12G)!
一.出发点: 之前在知乎看到一位大牛(二胖)写的一篇文章:python爬取知乎最受欢迎的妹子(大概题目是这个,具体记不清了),但是这位二胖哥没有给出源码,而我也没用过python,正好顺便学一学,所以 ...
- python scrapy爬取知乎问题和收藏夹下所有答案的内容和图片
上文介绍了爬取知乎问题信息的整个过程,这里介绍下爬取问题下所有答案的内容和图片,大致过程相同,部分核心代码不同. 爬取一个问题的所有内容流程大致如下: 一个问题url 请求url,获取问题下的答案个数 ...
随机推荐
- spring原理之四种基本标签的解析
四种标签 在spring的配置文件中存在四种基本的标签分别是:beans,bean,import,alias 四种标签的功能: beans:定义一个单独的应用配置(测试配置,开发配置等),在服务器部署 ...
- js javascript 如何获取某个值在数组中的下标
js 某个值在数组中的下标javascript中知道一个数组中的一个元素的值,如何获取数组下标JS 获取数组某个元素下标 函数方法 采用prototype原型实现方式,查找元素在数组中的索引值js查找 ...
- React Router 4.0 体验
React Router 4.0 (以下简称 RR4) 已经正式发布,它遵循React的设计理念,即万物皆组件.所以 RR4 只是一堆 提供了导航功能的组件(还有若干对象和方法),具有声明式(声明式编 ...
- postgresql 相关函数总结
1.获取当前日期的年份 select to_char(t.detect_date,'YYYY') select extract(year from now())为double precision 格式 ...
- vue学习指南:第二篇(详细Vue基础) - Vue的指令
一. Vue 的介绍 1. vue是一个 mvvm 的框架.(面试官经常会问的),angular 是 mvc的框架. 2. vm 是 vum 的实例,这个实例存在计算机内存中,主要干两件大事: 1. ...
- 剑指offer 8:旋转数组的最小数字
题目描述 把一个数组最开始的若干个元素搬到数组的末尾,我们称之为数组的旋转.输入一个非递减排序的数组的一个旋转,输出旋转数组的最小元素.例如数组{3,4,5,1,2}为{1,2,3,4,5}的一个旋转 ...
- sparkSQL中的example学习(1)
SparkSQLDemo.scala import org.apache.spark.sql.{Row, SparkSession} import org.apache.spark.sql.types ...
- 4.InfluxDB-InfluxQL基础语法教程--基本select语句
本文翻译自官网,官网地址:(https://docs.influxdata.com/influxdb/v1.7/query_language/data_exploration/) 基本语法如下: SE ...
- pipenv管理python开发环境
简介 简单说,pipenv就是把pip和virtualenv包装起来的一个便携工具. 它不会在你的项目文件夹里生成一大堆东西,只有两个文本文件: Pipfile, 简明地显示项目环境和依赖包. Pip ...
- IBM LOTUS DOMINO 9 部署SSL证书
前言 随着SHA1算法在2016年12月31日以后,将被强制淘汰,所有新的SSL证书都必须支持SHA256算法,所以我们必须将IBM Domino Server升级到9.0以上才可以支持SHA256算 ...