
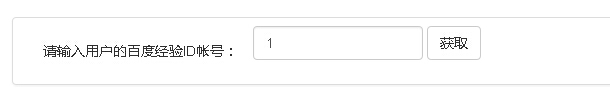
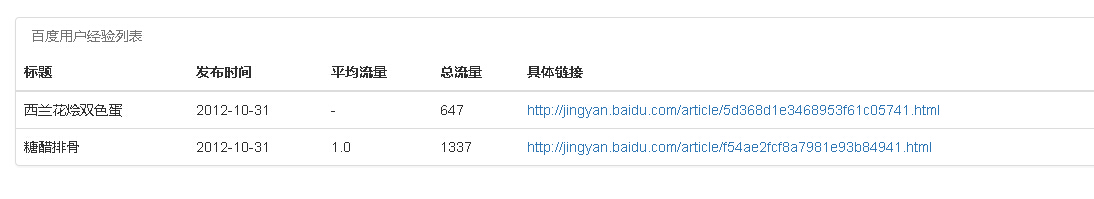
python提取百度经验<标题,发布时间,平均流量,总流量,具体的链接>
之前想研究下怎么抓网页数据.然后就有了下面的练习了.
如有BUG.也纯属正常. 只是练习.请勿投入产品使用.
#!/usr/bin/python

# -*- coding: utf-8 -*-

#Filenaem: tqjinyan.py

import os,sys,time,urllib2,re

import cookielib

import multiprocessing

import datetime,time

#定义存储完整的数据字典

#keyword: 具体短链接地址,发布时间,标题,平均每天浏览量,更新时间,总浏览量,链接地址

userJinYanAll={}

#提取用户总共有多少经验

def tiquNumber(url):

    regex = re.compile(r'&pn=(\d{1,10})"')

    web=urllib2.urlopen(url).read()

    num= regex.findall(web)

    if not len(num):

        num.append(1)

    num=map(int,num)

    num.sort()

    return num[-1]

#拼接每一页的链接,返回链接的列表

def retJinYanYe(url,num):

    # print '准备获取分页页面...'

    yesNumLianjie=[]

    for i in range(0,num+1,7):

        yesNumLianjie.append(url+"&pn="+str(i))

    return yesNumLianjie

#返回分页经验

def retNumTitle(jylist):

    numjisu=0

    for url in jylist:

        numjisu+=1

        #定义正则,链接,发布时间,标题

        regex_href = re.compile(r'<p class="tit"><a href="(.{1,200})" title="')

        regex_time=re.compile('<span class="exp-time">(.{1,12})</span>')

        regex_title=re.compile('" title="(.{1,80})" target="_blank">')

        #定义字典关键词

        regex_keyword=re.compile('e/(.{1,50}).html')

        #获取web分页中的数据

        web=urllib2.urlopen(url).read()

        #获取链接,发布时间,标题

        href=regex_href.findall(web)

        exp_time=regex_time.findall(web)

        title=regex_title.findall(web)

        #进行循环添加至列表的字典中

        # print url

        for i in range(0,len(title)):

            #定义一个空列表,用于添加至列表字典中

            userlist=[]

            keyword = regex_keyword.findall(href[i])

            # print keyword

            userlist.append(href[i])

            userlist.append(exp_time[i])

            userlist.append(title[i])

            # print keyword

            userJinYanAll[keyword[0]]=userlist

        # printstdout('\r正在获取第  %i  页的经验信息...' % numjisu)

        # print userJinYanAll

#根据地址,使用cookie浏览具体页面,返回浏览量,更新时间

def retLiuLanNum(keyword,url,i):

    loginUrl='http://jingyan.baidu.com'+url

    #以cookie来访问具体的网页

    # cj = cookielib.CookieJar()

    # opener = urllib2.build_opener(urllib2.HTTPCookieProcessor(cj))

    # urllib2.install_opener(opener)

    # resp = urllib2.urlopen(loginUrl)

    req=urllib2.Request(loginUrl,data="")

    f=urllib2.urlopen(req).read()

    regex_liulannum = re.compile(r'<span class="views">(\d{1,10})</span>')

    regex_updateTime=re.compile(r'<time>(.{1,20})</time>')

    viewsNum=regex_liulannum.findall(f)

    updateTime=regex_updateTime.findall(f)

    #平均流量

    if int(viewsNum[0])!=0:

        jianGeDay=pingJunNum(keyword,updateTime[0],viewsNum[0])

        pjNum=int(viewsNum[0])/int(jianGeDay)/1.00

        if pjNum<1:

            userJinYanAll[keyword].append('-')

        else:

            userJinYanAll[keyword].append(str(pjNum))

        # print pjNum

    else:

        userJinYanAll[keyword].append('-')

    # print pingJunNum(keyword,updateTime,viewsNum)

    # sys.exit()

    # print viewsNum,updateTime

    userJinYanAll[keyword].append(updateTime[0])

    userJinYanAll[keyword].append(viewsNum[0])

    userJinYanAll[keyword].append(loginUrl)

    # print userJinYanAll

    # sys.exit()
    #下面这句.因为格式需要<换成两行,如需测试.自行优化下格式.

    print str(i)+"\t\t"+userJinYanAll[keyword][1]+"\t"+userJinYanAll[keyword][5]+
      "\t"+userJinYanAll[keyword][3]+"\t"+userJinYanAll[keyword][2]+"\t"+userJinYanAll[keyword][6]

def getcookie():

    loginUrl='http://jingyan.baidu.com/article/ed2a5d1f1938f909f7be174f.html'

    cj = cookielib.CookieJar()

    opener=urllib2.build_opener(urllib2.HTTPCookieProcessor(cj))

    urllib2.install_opener(opener)

    resp=urllib2.urlopen(loginUrl)

    f = urllib2.urlopen(url= loginUrl)

def menu(url):

    try:

        #获取用户姝经验分页

        # print '提取经验总数量...'

        numYe=tiquNumber(url)

        #根据分页链接获取每页上面的链接

        jylist=retJinYanYe(url,numYe)

        # print '总共有:%s页经验.'%len(jylist)

        # print '根据分页信息获取具体链接..'

        # print jylist

        retNumTitle(jylist)

        # for t in jylist:

            #根据链接生成字典数据

            # retNumTitle(t)

        # print '共有:%s篇经验.'%len(userJinYanAll)

        # print '获取Cookie信息中...'

        getcookie()

        # print '获取每篇经验具体的经验信息,此时间比较久,请耐心等待...'

        # print '----------输出具体的经验列表----------'

        # print '序列\t发布时间\t总浏量\t平均每天的浏览量\t\t标题\t\t\t具体链接'

        i=0

        for k,v in userJinYanAll.items():

            i+=1

            retLiuLanNum(k,v[0],i)

            # print "%s:%s"%(k,v)

        # for k,v in userJinYanAll.items():

            # print k,v

            # print v[4]+"\t"+v[2]+"\t"+v[1]+"\t"+v[3]+"\t"+v[5]

        # print '-'*50

        # print userJinYanAll

        return userJinYanAll

        # userjianyanpaixu=sorted(userJinYanAll.iteritems(),key=lambda asd:asd[1],reverse=True)

        # for k,v in userjianyanpaixu.items():

        #     i+=1

        #     print str(i)+"\t\t"+userjianyanpaixu[1]+"\t"+userjianyanpaixu[5]+"\t"+userjianyanpaixu[3]+
     #    "\t"+userjianyanpaixu[2]+"\t"+userjianyanpaixu[6]

        # # print userJinYanAll

    except KeyboardInterrupt,e:

        return e

        # print "QUIT"

def printstdout(printname):

    sys.stdout.write("\r%s"%printname)

    sys.stdout.flush()

def pingJunNum(keyword,update,num):

    # print keyword,update,num

    updatetime=datetime.datetime.strptime(update,'%Y-%m-%d %H:%M')

    newde=datetime.datetime.now()

    chadate= newde-updatetime

    return str(chadate).split(' ')[0]

def sys_input():

    url_baidu='http://jingyan.baidu.com/user/npublic/expList?un='

    raw_str=urllib2.quote(raw_input('请输入用户百度经验ID: '))

    url=url_baidu+raw_str

    menu(url)

    # userjianyanpaixu=sorted(userJinYanAll.iteritems(),key=lambda asd:asd[1],reverse=True)

    # print userjianyanpaixu

    # for i in userjianyanpaixu:

        # print i[1]

def sys_input_wap(baidujyid):

    url_baidu='http://jingyan.baidu.com/user/npublic/expList?un='

    # raw_str=urllib2.quote(baidujyid)

    url=url_baidu+baidujyid

    returntest(url)

    # return url

def returntest(url):

    web=urllib2.urlopen(url).read()

    return web

if __name__=="__main__":

    sys_input()
=======================================================
|| 好吧. 代码如上. 或许有BUG.并且没有进行重构.优化. ||
|| 已知问题.百度会有相关IP访问频率屏蔽.所以不适合商用.仅测试. ||
=======================================================
版权声明:本文为博主原创文章,未经博主允许不得转载。
python提取百度经验<标题,发布时间,平均流量,总流量,具体的链接>的更多相关文章
- Python数据抓取(3) —抓取标题、时间及链接
本次分享,jacky将跟大家分享如何将第一财经文章中的标题.时间以及链接抓取出来 (一)观察元素抓取位置 网页的原始码很复杂,我们必须找到特殊的元素做抽取,怎么找到特殊的元素呢?使用开发者工具检视每篇 ...
- 标题右边10px位置紧跟发布时间
一个ul列表,拥有若干li,内容是新闻标题,标题右边10px位置紧跟发布时间,当标题过长需要控制标题width,需要兼容ie6,不能用max-width h4{font-size:14px;heigh ...
- 基于python对B站收藏夹按照视频发布时间进行排序
基于python对B站收藏夹按照视频发布时间进行排序 前言 在最一开始,我的B站收藏一直是存放在默认收藏夹中,但是随着视频收藏的越来越多,没有分类的视频放在一起,想在众多视频中找到想要的视频非常困难, ...
- dede调用文章的栏目,作者,发布时间.以及连接数据库输出一个表
发布时间: {dede:field.pubdate function="MyDate('Y-m-d H:i',@me)"/}类目:{dede:field.typename/}发布人 ...
- 使用 Python 编写脚本并发布
使用 Python 编写脚本并发布 P1: 脚本 通常在 Linux 服务器上会遇到在命令行中输入命令的操作,而有些操作包含的命令数目较多或者其中的命令包含的参数较多,如果一个一个的敲命令的话就太麻烦 ...
- excel批量提取网页标题
最近时间比较忙,有时候很多网页需要临时保存,以便空闲的时候查看.单纯的保存网页链接会让人很枯燥,所以需要自动批量提取标题. 为了这个小功能去写个小程序有点不划算,所以就利用excel实现了这个功能. ...
- 转:python提取浏览器Cookie
在用浏览器进行网页访问时,会向网页所在的服务器发送http协议的GET或者POST等请求,在请求中除了指定所请求的方法以及URI之外,后面还跟随着一段Request Header.Request He ...
- glibc 各版本发布时间以及内核默认glibc版本
最近有些软件要求glibc 2.14+,centos 6.x自带的版本是2.12的,特查了下glibc 各版本发布时间以及与对应的内核,如下: Complete glibc release histo ...
- 2.1 -1.0 Xcode(发布时间、使用、快捷键、插件相关)
本文并非最终版本,如有更新或更正会第一时间置顶,联系方式详见文末 如果觉得本文内容过长,请前往本人 “简书” 1.0 Xcode 发布时间 版本 iOS 版本 手机 日期 特殊介绍 Xcode 3.1 ...
随机推荐
- waffit防火墙检测
Waffit是一款Web应用防火墙检测工具,检测防火墙保护的站点是在渗透测试中非常重要的一步.如果没有对WAF进行配置,有时候可能存在漏洞.在渗透测试和风险评估中分析WAF也是非常重要的.通过编码攻击 ...
- smtp扫描
nc扫描 nc -nv ip号 25 nmap扫描
- Forms.WebBrowser与Controls.WebBrowser区别
Forms.WebBrowser与Controls.WebBrowser区别 Forms.WebBrowser有ScrollBarsEnabled 属性,即窗口滚动条,可以设置为false即可: Co ...
- 二叉树中和为某一值的路径(python)
题目描述 输入一颗二叉树的跟节点和一个整数,打印出二叉树中结点值的和为输入整数的所有路径.路径定义为从树的根结点开始往下一直到叶结点所经过的结点形成一条路径.(注意: 在返回值的list中,数组长度大 ...
- nagios维护之常见问题
一.重启nagios 报错: Starting nagios:This account is currently not available. #这个账户目前不可用: 解决方法: a.编辑/e ...
- 将unitest整合和python发送测试报告
废话少说先上代码 # -*- coding:UTF-8 -*- __autor__ = 'zhouli' __date__ = '2018/11/12 21:29' import unittest i ...
- 阿里读写分离数据源SELECT LAST_INSERT_ID()获取不到id
异常现象 insert 通过 mybatis 以下语法给领域类 赋予的 id 值为0. 后续根据主键的update操作失效.且无异常抛出 <selectKey keyProperty=" ...
- 封装JedisClient.提供API实现对redis的操作
需要导包,jedis-2.8.1.jar和博主的序列化工具类SerializeUtils package com.demo.redis; import java.util.ArrayList; imp ...
- swift - iOS10之后的加速器
import UIKit //1.加速器框架 import CoreMotion class ViewController: UIViewController { //1.创建运动管理者 必须设置为 ...
- Tomcat登陆mysql的密码设置
在登陆mysql的密码和数据库密码不一致时,可以修改Mysql数据库密码或者修改连接Mysql的配置文件: 1.修改连接Tomcat里连接Mysql的配置文件 需要修改两个配置文件 ,一个是在tom ...