
大数据hadoop与spark的区别
学习hadoop已经有很长一段时间了,好像是二三月份的时候朋友给了一个国产Hadoop发行版下载地址,因为还是在学习阶段就下载了一个三节点的学习版玩一下。在研究、学习hadoop的朋友可以去找一下看看(发行版 大快DKhadoop,去大快的网站上应该可以下载到的。)
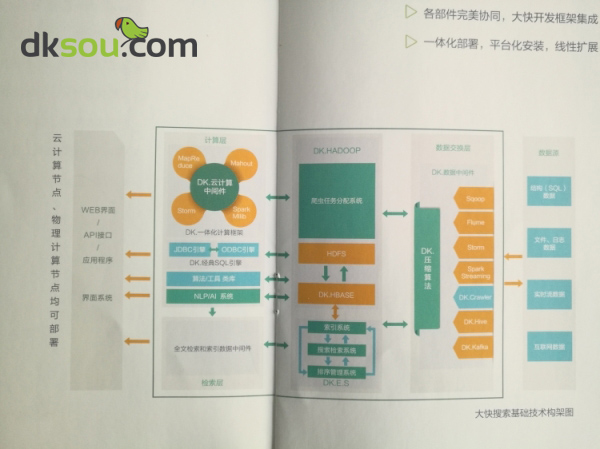
在学习hadoop的时候查询一些资料的时候经常会看到有比较hadoop和spark的,对于初学者来说难免会有点搞不清楚这二者到底有什么大的区别。我记得刚开始接触大数据这方面内容的时候,也就这个问题查阅了一些资料,在《FreeRCH大数据一体化开发框架》的这篇说明文档中有就Hadoop和spark的区别进行了简单的说明,但我觉得解释的也不是特别详细。我把个人认为解释的比较好的一个观点分享给大家:
它主要是从四个方面对Hadoop和spark进行了对比分析:
1、目的:首先需要明确一点,hadoophe spark 这二者都是大数据框架,即便如此二者各自存在的目的是不同的。Hadoop是一个分布式的数据基础设施,它是将庞大的数据集分派到由若干台计算机组成的集群中的多个节点进行存储。Spark是一个专门用来对那些分布式存储的大数据进行处理的工具,spark本身并不会进行分布式数据的存储。
2、两者的部署:Hadoop的框架最核心的设计就是:HDFS和MapReduce。HDFS为海量的数据提供了存储,则MapReduce为海量的数据提供了计算。所以使用Hadoop则可以抛开spark,而直接使用Hadoop自身的mapreduce完成数据的处理。Spark是不提供文件管理系统的,但也不是只能依附在Hadoop上,它同样可以选择其他的基于云的数据系统平台,但spark默认的一般选择的还是hadoop。
3、数据处理速度:Spark,拥有Hadoop、 MapReduce所具有能更好地适用于数据挖掘与机器学习等需要迭代的的优点;但不同于MapReduce的是Job中间输出结果可以保存在内存中,从而不再需要读写HDFS,
Spark 是一种与hadoop 相似的开源集群计算环境,但是两者之间还存在一些不同之处,这些有用的不同之处使 Spark 在某些工作负载方面表现得更加优越,换句话说,Spark 启用了内存分布数据集,除了能够提供交互式查询外,它还可以优化迭代工作负载。
4、数据安全恢复:Hadoop每次处理的后的数据是写入到磁盘上,所以其天生就能很有弹性的对系统错误进行处理;spark的数据对象存储在分布于数据集群中的叫做弹性分布式数据集中,这些数据对象既可以放在内存,也可以放在磁盘,所以spark同样可以完成数据的安全恢复。
大数据hadoop与spark的区别的更多相关文章
- [转帖]大数据hadoop与spark的区别
大数据hadoop与spark的区别 https://www.cnblogs.com/adnb34g/p/9233906.html Posted on 2018-06-27 14:43 左手中倒影 阅 ...
- 成都大数据Hadoop与Spark技术培训班
成都大数据Hadoop与Spark技术培训班 中国信息化培训中心特推出了大数据技术架构及应用实战课程培训班,通过专业的大数据Hadoop与Spark技术架构体系与业界真实案例来全面提升大数据工程师 ...
- 大数据 Hadoop,Spark和Storm
大数据(Big Data) 大数据,官方定义是指那些数据量特别大.数据类别特别复杂的数据集,这种数据集无法用传统的数据库进行存储,管理和处理.大数据的主要特点为数据量大(Volume),数据类别复 ...
- 大数据Hadoop与Spark学习经验谈
昨晚听了下Hulu大数据基础架构组负责人–董西成的关于大数据学习方法的直播,挺有收获的,下面截取一些PPT的关键内容,希望对正在学习大数据的人有帮助. 现状是目前存在的问题,比如找百度.查书这种学习方 ...
- 大数据篇:Spark
大数据篇:Spark Spark是什么 Spark是一个快速(基于内存),通用,可扩展的计算引擎,采用Scala语言编写.2009年诞生于UC Berkeley(加州大学伯克利分校,CAL的AMP实验 ...
- 大数据体系概览Spark、Spark核心原理、架构原理、Spark特点
大数据体系概览Spark.Spark核心原理.架构原理.Spark特点 大数据体系概览(Spark的地位) 什么是Spark? Spark整体架构 Spark的特点 Spark核心原理 Spark架构 ...
- 大数据计算新贵Spark在腾讯雅虎优酷成功应用解析
http://www.csdn.net/article/2014-06-05/2820089 摘要:MapReduce在实时查询和迭代计算上仍有较大的不足,目前,Spark由于其可伸缩.基于内存计算等 ...
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- 大数据hadoop面试题2018年最新版(美团)
还在用着以前的大数据Hadoop面试题去美团面试吗?互联网发展迅速的今天,如果不及时更新自己的技术库那如何才能在众多的竞争者中脱颖而出呢? 奉行着"吃喝玩乐全都有"和"美 ...
随机推荐
- js设计模式-观察者模式
定义: 观察者模式又叫发布订阅模式,它定义了对象间的一种一对多的依赖关系.观察者模式让两个对象松耦合地联系在一起,虽然不太清楚彼此的细节,但这不影响他们之间的互相通信. 思路 定义一个对象,在对象中实 ...
- shiro学习笔记-Subject#login(token)实现过程
本博文所有的代码均为shiro官网(http://shiro.apache.org/)中shiro 1.3.2版本中的源码. 追踪Subject的login(AuthenticationToken t ...
- 快速切题 poj2488 A Knight's Journey
A Knight's Journey Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 31195 Accepted: 10 ...
- Visual Studio build tools 安装出错的一种解决办法
一般是安装包丢失或损坏,那么我么可以用离线下载的方式来先行下载. 用 -h 看下帮助 主要是Layout参数. 下载完,到下载目录安装吧.
- 《Python》 面向对象初识
一.面向对象初识: 1.结构上理解:类由两部分组成 class A: # class是类的关键字,类名首字母默认大写 name = 'alex' # 静态属性,静态变量,静态字段 def func ...
- 玩转X-CTR100 l STM32F4 l DHT11温湿度传感器
我造轮子,你造车,创客一起造起来!塔克创新资讯[塔克社区 www.xtark.cn ][塔克博客 www.cnblogs.com/xtark/ ] DHT11数字温湿度传感器是一款含有已校准数字信号输 ...
- Java内存不足之PermGen space错误探究
一.Java 程序的运行机制与普通程序,如C或C++ 程序的运行机制有很大的区别. 普通程序运行之前必须首先编译成可执行的二进制码或机器码.机器码是与底层的硬件结构相关的,即使书写源代码的时候没有利用 ...
- Python学习(002)--Python介绍
一. Python介绍 python的创始人为吉多·范罗苏姆(Guido van Rossum).1989年的圣诞节期间,吉多·范罗苏姆为了在阿姆斯特丹打发时间,决心开发一个新的脚本解释程序,作为AB ...
- SWIFT中的repeat...while
SWIFT中的repeat...while类似于JAVA\.NET中的 do while.大同小异只是把do换成了repeat var index = 10 repeat{ print(index) ...
- 新手小白Linux(Centos6.5)部署java web项目(总)
一.准备 1.linux centos版本的相关命令操作,千万别找ubuntu的,好多命令都不一样,新手小白我傻傻不知道硬是浪费了一天的时间……(百度百科linux版本了解一下) 2.远程登录: P ...