
Hadoop namenode节点无法启动的问题解决
namenode是Hadoop集群HDFS的管理节点,管理着整个分布式文件系统的命名空间,以及文件与块的映射关系等,在Hadoop集群中扮演着至关重要的作用。
我之前安装的Hadoop集群中namenode和secondary namenode是在一个节点上安装的,安装的节点是在masters文件中配置的IP地址,然后在网上看了一些资料,希望将secondary namenode 分配到其他的集群节点上,做到更好的可维护性,也能够减小对namenode的压力。
网上的资料是说${HADOOP_HOME}/etc/hadoop/masters中配置的是secondary namenode运行的节点,并不是namenode的运行节点,因此在masters中将节点信息修改为希望将secondary namenode 运行的主机节点的IP地址,如图:
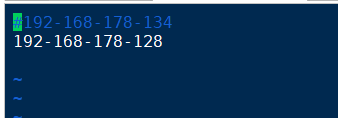
然后需要在 ${HADOOP_HOME}/etc/hadoop/hdfs-site.xml中配置secondary namenode 与 namenode运行的节点的信息,如图:
<property>
<name>dfs.http.address</name>
<value>192.168.178.134:50070</value>
<description>
The address and the base port where the dfs namenode web ui will listen on.
If the port is 0 then the server will start on a free port.
</description>
</property>
<property>
<name>dfs.namenode.secondary.http-address</name>
<value>192.168.178.128:50090</value>
</property>
</configuration>
这两个第一个配置的是namenode运行的节点信息,而第二个是secondary namenode运行的节点信息。由于我之前没有配置这两个,只是配置了一个namenode默认的地址信息,如下:
<property>
<name>fs.defaultFS</name>
<value>hdfs://192.168.178.134:9000</value>
</property>
然后无就把我这个删除了,只保留了上面那两个。然后进行集群的重新启动,刚开始启动是没有什么问题的,但是过了一天进行集群的启动就发现namenode无法启动,datanode正常启动。最后把我之前删掉的这一段加上就好了。
fs.defaultFS这个属性是HDFS的hadoop访问目录节点nameNode的地址和端口。
而上面的那个dfs.http.address是NameNode web管理端口以及namenode的地址信息。
Hadoop namenode节点无法启动的问题解决的更多相关文章
- Hadoop Datanode节点无法启动(All directories in dfs.data.dir are invalid)
Hadoop Datanode节点无法启动(All directories in dfs.data.dir are invalid) java.io.IOException: All director ...
- Hadoop namenode无法启动
最近遇到了一个问题,执行start-all.sh的时候发现JPS一下namenode没有启动 每次开机都得重新格式化一下namenode才可以 其实问题就出在tmp文件,默 ...
- Hadoop源码:namenode格式化和启动过程实现
body { margin: 0 auto; font: 13px / 1 Helvetica, Arial, sans-serif; color: rgba(68, 68, 68, 1); padd ...
- 一步步教你Hadoop多节点集群安装配置
1.集群部署介绍 1.1 Hadoop简介 Hadoop是Apache软件基金会旗下的一个开源分布式计算平台.以Hadoop分布式文件系统HDFS(Hadoop Distributed Filesys ...
- Hadoop系列(二):Hadoop单节点部署
环境:CentOS 7 JDK: 1.7.0_80 hadoop:2.8.5 hadoop(192.168.56.101) 配置基础环境 1. 测试环境可以直接关闭selinux和防火墙 2. 主机添 ...
- hadoop学习(二)hadoop集群的启动
一.完全分布式集群环境的搭建 1.配置hosts文件:将三台集群服务器的主机名与IP的对应关系互相配置到对方的hosts文件中,以便对方服务器能通过主机名寻找IP,hosts文件在/etc目录下. 2 ...
- Hadoop启动之后jps没有NameNode节点
这是因为多次格式化namenode节点出现的问题 1.先运行stop-all.sh 2.删除原目录,即core-site.xml下配置的<name>hadoop.tmp.dir</n ...
- hadoop yarn namenode datanoe 启动异常问题解决 分析日志
cat logs/hadoop-root-datanode-hadoop1.log ********************************************************** ...
- 全网最详细的Hadoop HA集群启动后,两个namenode都是standby的解决办法(图文详解)
不多说,直接上干货! 解决办法 因为,如下,我的Hadoop HA集群. 1.首先在hdfs-site.xml中添加下面的参数,该参数的值默认为false: <property> < ...
随机推荐
- 用SQL表达交并差操作
交-并-差的处理 SQL语言:并运算UNION,交运算INTERSECT,差运算EXCEPT 基本语法形式: 子查询{UNION [ALL] | INTERSECT [ALL] | EXPECT [A ...
- Access-Control-Allow-Origin设置跨域
我来自己写一下答案,以给后来的朋友一点思路和建议:1,首先把Access-Control-Allow-Origin设置成*是不妥的,自己的接口服务器不能允许所有人都可以访问.2,具体哪里可以设置Acc ...
- java 中类的方法
object类,即所有类的父类, getClass() 返回对象执行时的Class实例, getClass().getName();// 返回类的名字 toString();// equals();/ ...
- Nginx开启gzip压缩解决react打包文件过大
用create-react-app创建的react应用打包之后的build js有1M之多. 采用gzip打包传输,可以节约70%左右的带宽 nginx采用gzip打包方式 在nginx配置中添加如下 ...
- wireshark 抓包过滤器使用
目录 wireshark 抓包过滤器 一.抓包过滤器 二.显示过滤器 整理自陈鑫杰老师的wireshark教程课 wireshark 抓包过滤器 过滤器分为抓包过滤器和显示过滤器,抓包过滤器会将不满足 ...
- 分布式系列十二: Redis高级主题
持久化 Redis 支持持久化, 其持久化数据有两种方式. 两种可以同时使用. 如果同时使用, Reids 在重启时将使用 AOF 方式来还原数据. RDB 按照一定策略定时同步内存的数据到磁盘.文件 ...
- 论文翻译:BinaryConnect: Training Deep Neural Networks with binary weights during propagations
目录 摘要 1.引言 2.BinaryConnect 2.1 +1 or -1 2.2确定性与随机性二值化 2.3 Propagations vs updates 2.4 Clipping 2.5 A ...
- C# 最全的文件工具类FileHelper
using System; using System.Collections.Generic; using System.Data; using System.IO; using System.Lin ...
- Android studio 常见错误修改
一,依赖冲突 All com.android.support libraries must use the exact same version specification (mixing versi ...
- 九 Jenkins持续集成
随时随地将代码合并的方法叫做 持续集成 =================================================================== 视频用的10.0.0.1 ...