
MapReduce统计每个用户的使用总流量
1、原始数据
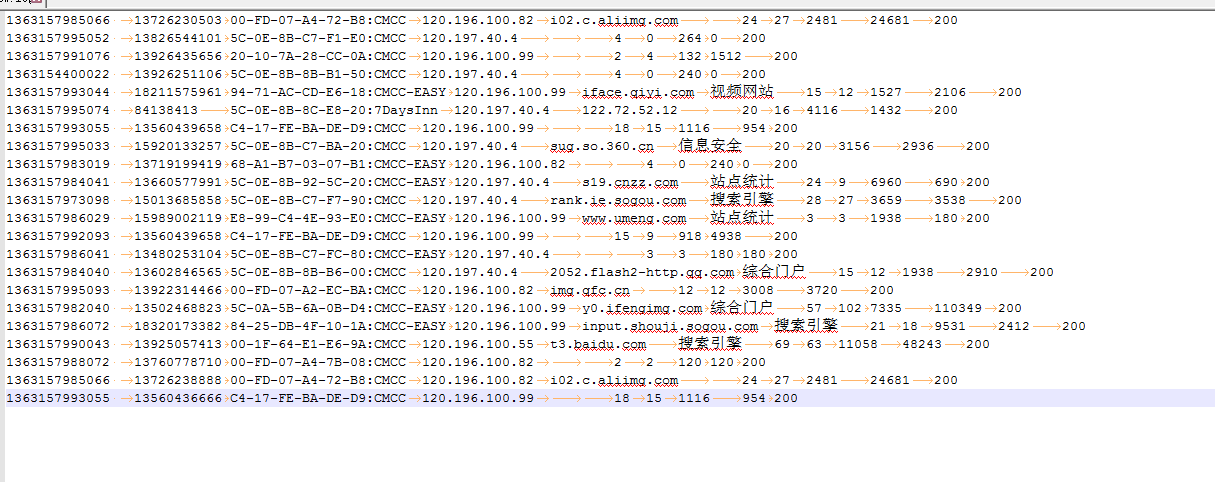
2、使用java程序
1)新建项目
2)导包
hadoop-2.7.3\share\hadoop\mapreduce
+hsfs的那些包
+common
3、写项目
1)实体类
注:属性直接定义为String和 Long定义更方便
package com.zy.flow;

import java.io.DataInput;

import java.io.DataOutput;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.io.Writable;

public class Flow implements Writable{//Writable可序列化的(序列化:把对象变成二进制流   反序列化:把二进制流变成对象)
//包含 电话 上行流量 下行流量 总流量

    private Text phone;

    private LongWritable upflow;//上行

    private LongWritable downflow;//下行

    private LongWritable sumflow;//总流量

    //这个对象以后要在集群中传输,所以要可序列化

    //序列化反序列化顺序要一致

    @Override//反序列化时会调用该方法

    public void readFields(DataInput in) throws IOException {

        phone=new Text(in.readUTF());

        upflow=new LongWritable(in.readLong());

        downflow=new LongWritable(in.readLong());

        sumflow=new LongWritable(in.readLong());

    }

    @Override//序列化时会调用该方法

    public void write(DataOutput out) throws IOException {

        out.writeUTF(phone.toString());

        out.writeLong(upflow.get());

        out.writeLong(downflow.get());

        out.writeLong(sumflow.get());

    }

    public Text getPhone() {

        return phone;

    }

    public void setPhone(Text phone) {

        this.phone = phone;

    }

    public LongWritable getUpflow() {

        return upflow;

    }

    public void setUpflow(LongWritable upflow) {

        this.upflow = upflow;

    }

    public LongWritable getDownflow() {

        return downflow;

    }

    public void setDownflow(LongWritable downflow) {

        this.downflow = downflow;

    }

    public LongWritable getSumflow() {

        return sumflow;

    }

    public void setSumflow(LongWritable sumflow) {

        this.sumflow = sumflow;

    }

    public Flow() {

    }

    public Flow(Text phone, LongWritable upflow, LongWritable downflow, LongWritable sumflow) {

        super();

        this.phone = phone;

        this.upflow = upflow;

        this.downflow = downflow;

        this.sumflow = sumflow;

    }

    public Flow(LongWritable upflow, LongWritable downflow, LongWritable sumflow) {

        super();

        this.upflow = upflow;

        this.downflow = downflow;

        this.sumflow = sumflow;

    }

    @Override//toString最后就是reduce中输出值的样式

    public String toString() {
    //输出样式

        return upflow+"\t"+downflow+"\t"+sumflow;

    }

}
2)FlowMap类
package com.zy.flow;

import java.io.IOException;

import javax.security.auth.callback.LanguageCallback;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

public class FlowMap extends Mapper<LongWritable, Text, Text, Flow>{

    @Override

    protected void map(LongWritable key, Text value, Mapper<LongWritable, Text, Text, Flow>.Context context)

            throws IOException, InterruptedException {

        //输入的值 value

        //切分value 寻找有价值的列

        String[] split = value.toString().split("\t");

        int length=split.length;

        //取哪几列split[1] split[length-3] split[length-2]

        String phone=split[1];

        Long upflow=Long.parseLong(split[length-3]);

        Long downflow=Long.parseLong(split[length-2]);

        Long sumflow=upflow+downflow;

        //输出

        context.write(new Text(phone), new Flow(new Text(phone), new LongWritable(upflow), new LongWritable(downflow),new LongWritable(sumflow)));

        //对象里虽然用不到phone但是要给它赋值,不然序列化时会报空指针异常

    }

}
3)Part(分区)类
package com.zy.flow;

import java.util.HashMap;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Partitioner;


//  map的输出是suffer的输入

public class Part extends Partitioner<Text, Flow> {//分区

    //逻辑自己写

    HashMap<String,Integer> map = new HashMap();

    public void setMap(){

    map.put("135",0);

    map.put("136", 1);

    map.put("137",2);

    map.put("138", 3);

    map.put("139",4);

    }
// 生成的文件 part-00000   part的编号的结尾就是这个int类型的返回值;

    @Override

    public int getPartition(Text key, Flow value, int arg2) {

        setMap();

        //从输入的数据中获得电话的前三位跟map对比。决定分到哪个区中

        String substring = key.toString().substring(0, 3);//例如截取135

        return map.get(substring)==null?5:map.get(substring);//根据键取值 键135 取出0

        //其他号码分到(编号为5)第6个区中

    }

    //在这个逻辑下partition分了6个区,所以以后要指定6个reducetask

}
4)FlowReduce类
package com.zy.flow;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

public class FlowReduce extends Reducer<Text, Flow, Text, Flow>{

    @Override

    protected void reduce(Text key, Iterable<Flow> value, Reducer<Text, Flow, Text, Flow>.Context context)

            throws IOException, InterruptedException {

        //累加

        long allup=0;

        long alldown=0;

        for (Flow flow : value) {

            allup+=Long.parseLong(flow.getUpflow().toString());//同一个电话的上行流量累加

            alldown+=Long.parseLong(flow.getDownflow().toString());//同一个电话的下行流量累加

        }

        long allsum=allup+alldown;

        context.write(key, new Flow(new Text(key), new LongWritable(allup),  new LongWritable(alldown),  new LongWritable(allsum)));

    }

}
5)FlowApp类
package com.zy.flow;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class FlowApp {

    public static void main(String[] args) throws Exception {

        //创建配置对象

        Configuration configuration = new Configuration();

        //得到job实例

        Job job = Job.getInstance(configuration);

        //指定job运行类

        job.setJarByClass(FlowApp.class);

        //指定job中的mapper

        job.setMapperClass(FlowMap.class);

        //指定mapper中的输出键和值类型

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(Flow.class);

        //指定job中的reducer

        job.setReducerClass(FlowReduce.class);

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(Flow.class);

        //-----

        //指定Partitioner使用的类

        job.setPartitionerClass(Part.class);

        //指定ReduceTask数量

        job.setNumReduceTasks(6);

        //-----

        //指定输入文件

        FileInputFormat.setInputPaths(job, new Path(args[0]));//运行时填入参数

        //指定输出文件

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        //提交作业

        job.waitForCompletion(true);

    }

}
4、运行
1)打包
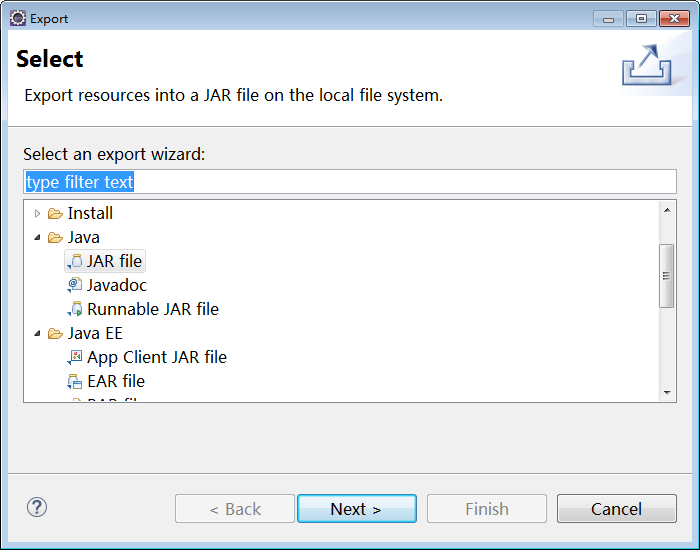
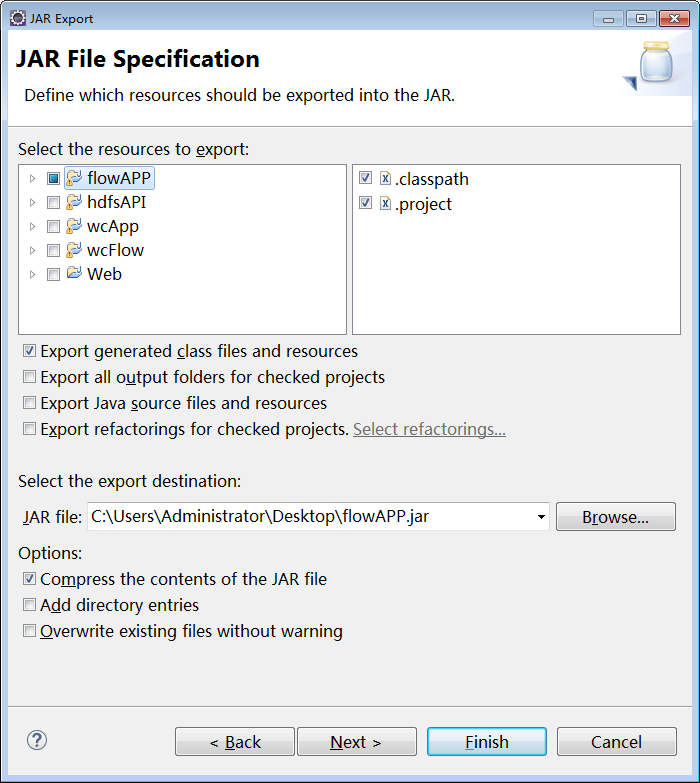
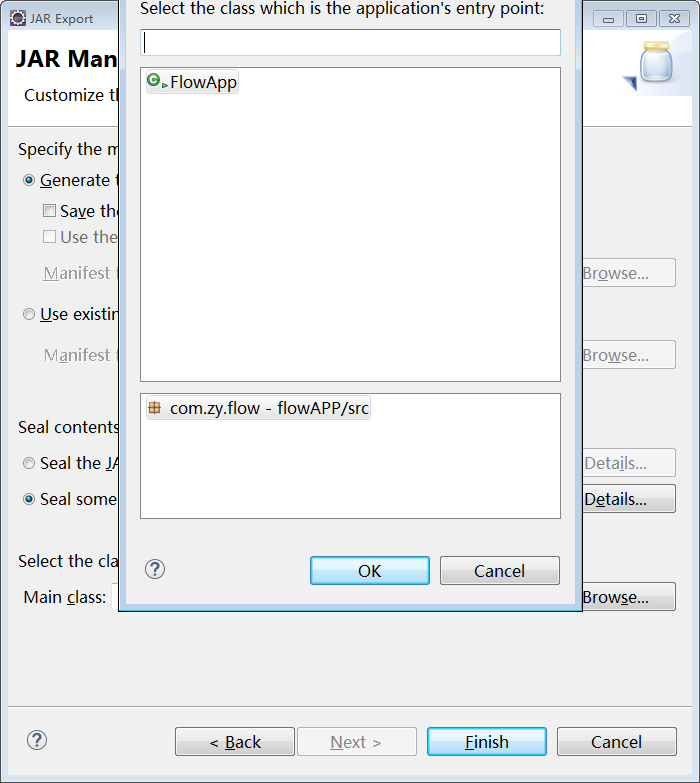
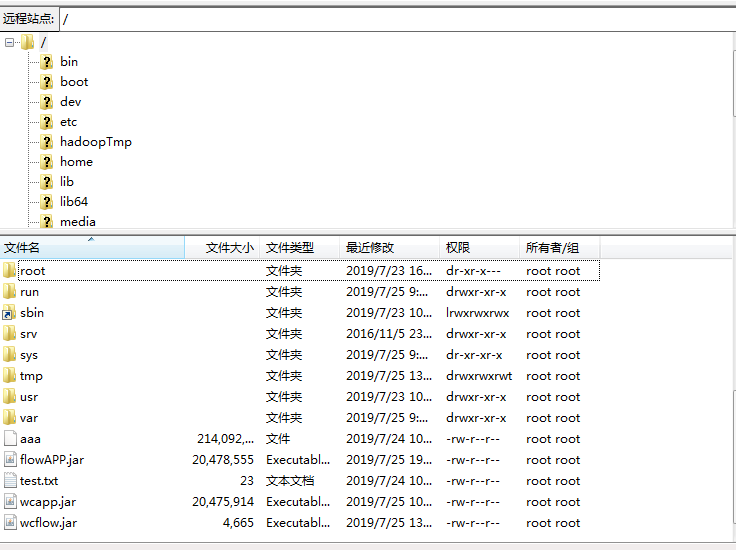
2)上传到linux
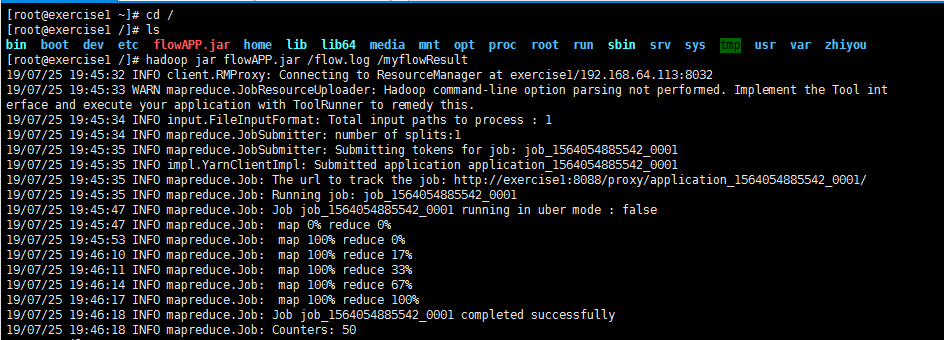
3)运行

MapReduce统计每个用户的使用总流量的更多相关文章
- MongoDb 用 mapreduce 统计留存率
MongoDb 用 mapreduce 统计留存率(金庆的专栏)留存的定义采用的是新增账号第X日:某日新增的账号中,在新增日后第X日有登录行为记为留存 输出如下:(类同友盟的留存率显示)留存用户注册时 ...
- 使用 Redis 统计在线用户人数
在构建应用的时候, 我们经常需要对用户的一举一动进行记录, 而其中一个比较重要的操作, 就是对在线的用户进行记录. 本文将介绍四种使用 Redis 对在线用户进行记录的方案, 这些方案虽然都可以对在线 ...
- Hadoop基础-Map端链式编程之MapReduce统计TopN示例
Hadoop基础-Map端链式编程之MapReduce统计TopN示例 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.项目需求 对“temp.txt”中的数据进行分析,统计出各 ...
- Tomcat集群下获取memcached缓存对象数量,统计在线用户数据量
项目需要统计在线用户数量,系统部署在集群环境下,使用会话粘贴的方式解决Session问题.要想得到真实在线用户数,必须是所有节点的总和. 这里考虑使用memcached存放用户登录数据,key为use ...
- 用HttpSessionListener统计在线用户或做账号在线人数管理
使用HttpSessionListener接口可监听session的创建和失效 session是在用户第一次访问页面时创建 在session超时或调用request.getSession().inva ...
- 拼多多后台开发面试真题:如何用Redis统计独立用户访问量
众所周至,拼多多的待遇也是高的可怕,在挖人方面也是不遗余力,对于一些工作3年的开发,稍微优秀一点的,都给到30K的Offer,当然,拼多多加班也是出名的,一周上6天班是常态,每天工作时间基本都是超过1 ...
- 拼多多面试真题:如何用 Redis 统计独立用户访问量!
阅读本文大概需要 2.8 分钟. 作者:沙茶敏碎碎念 众所周至,拼多多的待遇也是高的可怕,在挖人方面也是不遗余力,对于一些工作 3 年的开发,稍微优秀一点的,都给到 30K 的 Offer. 当然,拼 ...
- 从GoogleClusterData统计每个用户的使用率、平均每次出价
之前将google cluster data导入了Azure上的MySQL数据库,下一步就是对这些数据进行分析, 挖掘用户的使用规律了. 首先,为了加快执行速度,对user,time等加入索引. 然后 ...
- 如何用 Redis 统计独立用户访问量
众所周至,拼多多的待遇也是高的可怕,在挖人方面也是不遗余力,对于一些工作3年的开发,稍微优秀一点的,都给到30K的Offer,当然,拼多多加班也是出名的,一周上6天班是常态,每天工作时间基本都是超过1 ...
随机推荐
- i5 11300H 怎么样 相当于什么水平
i5-11300H 为 4 核 8 线程,主频 3.1GHz,睿频 4.4GHz,三级缓存 8MBi5-11300H 怎么样看完你就知道了 https://list.jd.com/list.html?
- 第2章 HTML中的JavaScript
目录 1. script标签 1.1 标签位置 1.2 defer推迟执行脚本 1.3 async异步执行脚本 1.4 动态加载脚本 2. noscript标签 1. script标签 <scr ...
- Github美化 添加徽章
Github美化 添加徽章 0. 前言 1. 准备 2. 开始 a. 打开shields.io b.制作静态徽章 c.制作动态徽章 d. 结果 3.额外 0. 前言 之前看见很多大项目都有很多勋章,比 ...
- 【转】借助LVS+Keepalived实现负载均衡
一.负载均衡:必不可少的基础手段 1.1 找更多的牛来拉车吧 当前大多数的互联网系统都使用了服务器集群技术,集群即将相同服务部署在多台服务器上构成一个集群整体对外提供服务,这些集群可以是Web应用服务 ...
- 定制个性化的GUI
你现在还在使用SAP GUI710或者是GUI720,又或者更早的640等吗?那么古董先生,推荐您使用GUI730吧,您可能会730好在哪?那我建议您去百度或者Google问吧.对于新的GUI730, ...
- JAVA获取当前文件路径this.getClass().getResource方法详细讲解
public class Test { public void run() { // TODO Auto-generated method stub System.out.println(" ...
- Javadoc命令与API
Javadoc命令与API Javadoc工具会抽取类,成员,方法的文档注释生成与这个类配套的API帮助文档 Javadoc命令和文档注释小公司基本不用,但我们应养成良好的编码习惯,所以还是了解一下 ...
- Django的数据库读写分离
Django的数据库读写分离 1.首先是配置数据库 在settings.py文件中增加多个数据库的配置: DATABASES = { 'default': { 'ENGINE': 'django.db ...
- vue、element-ui 后台菜单切换重新请求数据
我们在做后台管理系统时,通常将数据请求挂载到created或mounted钩子中,但这样引发的问题是它只会被出发一次,如果不同菜单中数据关联性较大,切换过程中未及时更新数据,容易引发一些问题,这种情况 ...
- Redis 实战 —— 09. 实现任务队列、消息拉取和文件分发
任务队列 P133 通过将待执行任务的相关信息放入队列里面,并在之后对队列进行处理,可以推迟执行那些耗时对操作,这种将工作交给任务处理器来执行对做法被称为任务队列 (task queue) . P13 ...