
Python入门学习之:10分钟1500访问量
看效果:
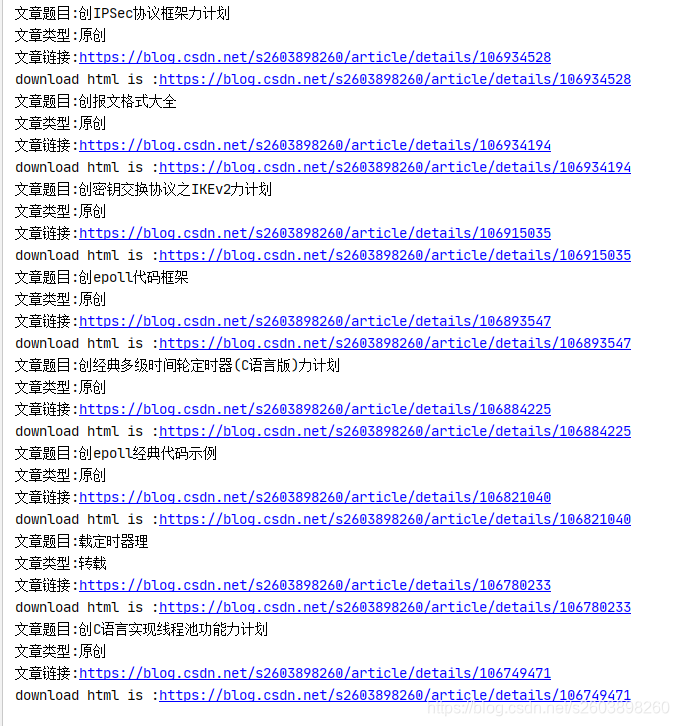
不扯没用的,直接上代码:
# author   : sunzd

# date     : 2019/9/01

# position : beijing

from fake_useragent import UserAgent

from bs4 import BeautifulSoup

from urllib import request

from urllib import error

import re

import time

def html_request(url):

    if url is None:

        return

    print("download html is :{0}".format(url))

    # 如果url包含中文,则需要进行编码

    # 模拟浏览器行为

    headers = {'UserAgent': str(UserAgent().random)}

    req = request.Request(url, headers=headers)

    try:

        html = request.urlopen(req).read().decode('utf-8')

    except error.URLError as e:

        if hasattr(e, "code"):

            print(e.code)

        if hasattr(e, "reason"):

            print(e.reason)

        return None

    # print(html)

    return html

def html_parser(url, html):

    if url is None or html is None:

        return

    # pattern = '<main>(.+?)</main>'   #因为<main>后紧跟的时‘\n’因此需要忽略掉使用模式修正符re.S使'.'可以匹配任意字符

    # articles = re.compile(pattern, re.S).findall(html)

    # articles = articles[0]

    pattern_art = '<div class="article-item-box csdn-tracking-statistics" data(.+?)</div>'

    # print(articles)

    articles = re.compile(pattern_art, re.S).findall(html.replace('\n', ''))

    print(articles.__len__())

    for article in articles:

        soup = BeautifulSoup(article, 'html.parser')

        title = soup.find('a', attrs={'target': '_blank'})

        # print(title)

        print(

            "文章题目:{0}\n文章类型:{1}".format(title.text.replace(' ', '').replace("原", "").replace("转", ""), title.span.text))

        print("文章链接:{0}".format(title.attrs['href']))

        html_request(title.attrs['href'])

        infors = soup.find('div', attrs={'class': 'info-box d-flex align-content-center'})

        # for infor in infors.p.next_siblings:   next_siblings : 因为不包括自己,因此会把第一个p节点信息去掉。

        # for infor in infors.children:

        #     if infor == ' ':  # ‘ ’空格也会识别为他的孩子,因此需要过滤掉

        #         continue

        #     # print("======{0}".format(infor))

        #     if infor.span:  # 只需要<span >节点的信息

        #         print("{0}".format(infor.span.text))

    pattern_next = '<li class="js-page-next js-page-action ui-pager ui-pager-disabled">'

    next = re.compile(pattern_next).findall(html)

    # print(html)

    print("是否为最后一页:{0}----{1}".format(len(next), next))

    if len(next) == 0:

        return 0

    else:

        return 0

if __name__ == '__main__':

    name = '你自己的名称'

    page = 1

    url = "https://blog.csdn.net/" + name + "/article/list/" + str(page) + '?'

    while page < 7:

        html = html_request(url)

        # print(html)

        next = html_parser(url, html)

        page += 1

        if page > 6:

            page = 1

        url = "https://blog.csdn.net/" + name + "/article/list/" + str(page) + '?'
Python入门学习之:10分钟1500访问量的更多相关文章
- emacs最简单入门,只要10分钟
macs最简单入门,只要10分钟 windwiny @2013 无聊的时候又看到鼓吹emacs的文章,以前也有几次想尝试,结果都是玩不到10分钟就退出删除了. 这次硬着头皮,打开几篇文章都看完 ...
- python入门学习:9.文件和异常
python入门学习:9.文件和异常 关键点:文件.异常 9.1 从文件中读取数据9.2 写入文件9.3 异常9.4 存储数据 9.1 从文件中读取数据 9.1.1 读取整个文件 首先创建一个pi_ ...
- python入门学习:8.类
python入门学习:8.类 关键点:类 8.1 创建和使用类8.2 使用类和实例8.3 继承8.4 导入类 8.1 创建和使用类 面向对象编程是最有效的软件编写方法之一.在面向对象编程中,你编写 ...
- python入门学习:7.函数
python入门学习:7.函数 关键点:函数 7.1 定义函数7.2 传递实参7.3 返回值7.4 传递列表7.5 传递任意数量的实参7.6 将函数存储在模块中 7.1 定义函数 使用关键字def ...
- python入门学习:6.用户输入和while循环
python入门学习:6.用户输入和while循环 关键点:输入.while循环 6.1 函数input()工作原理6.2 while循环简介6.3 使用while循环处理字典和列表 6.1 函数in ...
- python入门学习:5.字典
python入门学习:5.字典 关键点:字典 5.1 使用字典5.2 遍历字典5.3 嵌套 5.1 使用字典 在python中字典是一系列键-值对.每个键都和一个值关联,你可以使用键来访问与之相关 ...
- python入门学习:4.if语句
python入门学习:4.if语句 关键点:判断 4.1 一个简单的测试4.2 条件测试4.3 if语句 4.1 一个简单的测试 if语句基本格式如下,注意不要漏了冒号 1if 条件 :2 ...
- python入门学习:3.操作列表
python入门学习:3.操作列表 关键点:列表 3.1 遍历整个列表3.2 创建数值列表3.3 使用列表3.4 元组 3.1 遍历整个列表 循环这种概念很重要,因为它是计算机自动完成重复工作的常 ...
- python入门学习:2.列表简介
python入门学习:2.列表简介 关键点:列表 2.1 列表是什么2.2 修改.添加和删除元素2.3 组织列表 2.1 列表是什么 列表,是由一系列按特定顺序排列的元素组成.你可以创建包含字母表 ...
随机推荐
- 如何在 NetCore 中定义我们自己的JSON配置文件的管理器。
一.介绍 微软已经对外提供了新的平台,我们叫它们是 Net Core 平台,这个平台和 Net Framework 平台有本质的区别,这个最本质的区别就是微软的C#代码可以跨平台了.当前我们主流的3大 ...
- dython:Python数据建模宝藏库
尽管已经有了scikit-learn.statsmodels.seaborn等非常优秀的数据建模库,但实际数据分析过程中常用到的一些功能场景仍然需要编写数十行以上的代码才能实现. 而今天要给大家推荐的 ...
- 从零开始实现简单 RPC 框架 2:扩展利器 SPI
RPC 框架有很多可扩展的地方,如:序列化类型.压缩类型.负载均衡类型.注册中心类型等等. 假设框架提供的注册中心只有zookeeper,但是使用者想用Eureka,修改框架以支持使用者的需求显然不是 ...
- anaconda的报错:Anaconda:There is an instance of anaconda navigator already running error
anaconda的报错:Anaconda:There is an instance of anaconda navigator already running error 出现这个问题的时候人蒙了,主 ...
- 【原创】Dubbo 2.7.8多个远程代码执行漏洞
马上年底了,发现年初定的几个漏洞的KPI还没来得及完成,趁着最近有空赶紧突击一波,之前业务部门被爆过Dubbo的漏洞,干脆就把Dubbo拖过来挖一把.之前没用过Dubbo,既然要挖它就先大体了解了一下 ...
- Windows Go 开发环境下载、安装并配置
前言 对于我们Windows用户而言,Go提供两种环境安装方式(源码安装除外): 1.MSI安装(MSI文件是Windows Installer的数据包,它实际上是一个数据库,包含安装一种产品所需要的 ...
- Android手机QQ的UI自动化实践
本文首发于果的博客园,原文链接:https://www.cnblogs.com/yuxiuyan/p/14992682.html, 转载请注明出处. UI自动化 我们为什么要搞UI自动化 可能很多同学 ...
- Linux+Apache+Mysql+PHP简单的测试环境搭建
系统版本为:Linux localhost.localdomain 2.6.32-431.el6.x86_64 #1 SMP Fri Nov 22 03:15:09 UTC 2013 x86_64 x ...
- 从零开始实现简单 RPC 框架 4:注册中心
RPC 中服务消费端(Consumer) 需要请求服务提供方(Provider)的接口,必须要知道 Provider 的地址才能请求到. 那么,Consumer 要从哪里获取 Provider 的地址 ...
- Node + Selenium 报错 UnhandledPromiseRejectionWarning: Error: ECONNREFUSED connect ECONNREFUSED 127.0.0.1:5319
安装selenium-webdriver npm i selenium-webdriver 当前安装版本: "selenium-webdriver": "^4.0.0-a ...