
Netty源码分析第7章(编码器和写数据)---->第3节: 写buffer队列
Netty源码分析七章: 编码器和写数据
第三节: 写buffer队列
之前的小节我们介绍过, writeAndFlush方法其实最终会调用write和flush方法
write方法最终会传递到head节点, 调用HeadContext的write方法:
public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) throws Exception {

    unsafe.write(msg, promise);

}
这里通过unsafe对象的write方法, 将消息写入到缓存中, 具体的执行逻辑, 我们在这个小节进行剖析
我们跟到AbstractUnsafe的write方法中:
public final void write(Object msg, ChannelPromise promise) {

    assertEventLoop();

    //负责缓冲写进来的byteBuf

    ChannelOutboundBuffer outboundBuffer = this.outboundBuffer;

    if (outboundBuffer == null) {

        safeSetFailure(promise, WRITE_CLOSED_CHANNEL_EXCEPTION);

        ReferenceCountUtil.release(msg);

        return;

    }

    int size;

    try {

        //非堆外内存转化为堆外内存

        msg = filterOutboundMessage(msg);

        size = pipeline.estimatorHandle().size(msg);

        if (size < 0) {

            size = 0;

        }

    } catch (Throwable t) {

        safeSetFailure(promise, t);

        ReferenceCountUtil.release(msg);

        return;

    }

    //插入写队列

    outboundBuffer.addMessage(msg, size, promise);

}
首先看 ChannelOutboundBuffer outboundBuffer = this.outboundBuffer
ChannelOutboundBuffer的功能就是缓存写入的ByteBuf
我们继续看try块中的 msg = filterOutboundMessage(msg)
这步的意义就是将非对外内存转化为堆外内存
filterOutboundMessage方法方法最终会调用AbstractNioByteChannel中的filterOutboundMessage方法:
protected final Object filterOutboundMessage(Object msg) {

    if (msg instanceof ByteBuf) {

        ByteBuf buf = (ByteBuf) msg;

        //是堆外内存, 直接返回

        if (buf.isDirect()) {

            return msg;

        }

        return newDirectBuffer(buf);

    }

    if (msg instanceof FileRegion) {

        return msg;

    }

    throw new UnsupportedOperationException(

            "unsupported message type: " + StringUtil.simpleClassName(msg) + EXPECTED_TYPES);

}
首先判断msg是否byteBuf对象, 如果是, 判断是否堆外内存, 如果是堆外内存, 则直接返回, 否则, 通过newDirectBuffer(buf)这种方式转化为堆外内存
回到write方法中:
outboundBuffer.addMessage(msg, size, promise)将已经转化为堆外内存的msg插入到写队列
我们跟到addMessage方法当中, 这是ChannelOutboundBuffer中的方法:
public void addMessage(Object msg, int size, ChannelPromise promise) {

    Entry entry = Entry.newInstance(msg, size, total(msg), promise);

    if (tailEntry == null) {

        flushedEntry = null;

        tailEntry = entry;

    } else {

        Entry tail = tailEntry;

        tail.next = entry;

        tailEntry = entry;

    }

    if (unflushedEntry == null) {

        unflushedEntry = entry;

    }

    incrementPendingOutboundBytes(size, false);

}
首先通过 Entry.newInstance(msg, size, total(msg), promise) 的方式将msg封装成entry
然后通过调整tailEntry, flushedEntry, unflushedEntry三个指针, 完成entry的添加
这三个指针均是ChannelOutboundBuffer的成员变量
flushedEntry指向第一个被flush的entry
unflushedEntry指向第一个未被flush的entry
也就是说, 从flushedEntry到unflushedEntry之间的entry, 都是被已经被flush的entry
tailEntry指向最后一个entry, 也就是从unflushedEntry到tailEntry之间的entry都是没flush的entry
我们回到代码中:
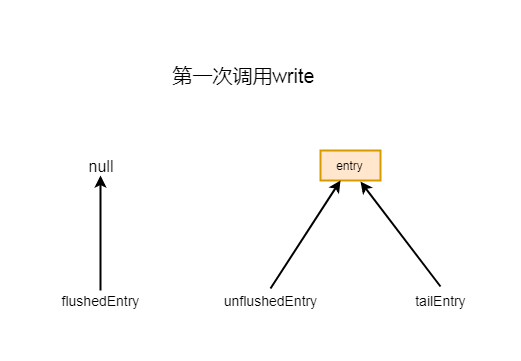
创建了entry之后首先判断尾指针是否为空, 在第一次添加的时候, 均是空, 所以会将flushedEntry设置为null, 并且将尾指针设置为当前创建的entry
最后判断unflushedEntry是否为空, 如果第一次添加这里也是空, 所以这里将unflushedEntry设置为新创建的entry
第一次添加如下图所示
7-3-1
如果不是第一次调用write方法, 则会进入 if (tailEntry == null) 中else块:
Entry tail = tailEntry 这里tail就是当前尾节点
tail.next = entry 代表尾节点的下一个节点指向新创建的entry
tailEntry = entry 将尾节点也指向entry
这样就完成了添加操作, 其实就是将新创建的节点追加到原来尾节点之后
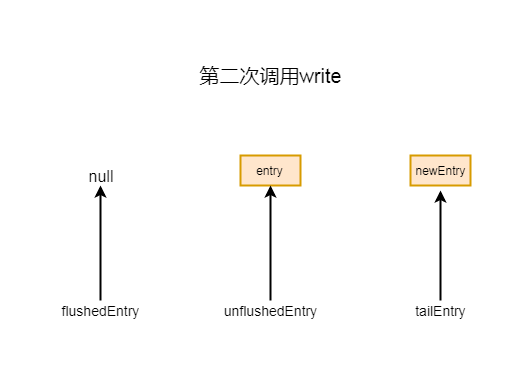
第二次添加 if (unflushedEntry == null) 会返回false, 所以不会进入if块
第二次添加之后指针的指向情况如下图所示:
7-3-4
以后每次调用write, 如果没有调用flush的话都会在尾节点之后进行追加
回到代码中, 看这一步incrementPendingOutboundBytes(size, false)
这步时统计当前有多少字节需要被写出, 我们跟到这个方法中:
private void incrementPendingOutboundBytes(long size, boolean invokeLater) {

    if (size == 0) {

        return;

    }

    //TOTAL_PENDING_SIZE_UPDATER当前缓冲区里面有多少待写的字节

    long newWriteBufferSize = TOTAL_PENDING_SIZE_UPDATER.addAndGet(this, size);

    //getWriteBufferHighWaterMark() 最高不能超过64k

    if (newWriteBufferSize > channel.config().getWriteBufferHighWaterMark()) {

        setUnwritable(invokeLater);

    }

}
看这一步:
long newWriteBufferSize = TOTAL_PENDING_SIZE_UPDATER.addAndGet(this, size)
TOTAL_PENDING_SIZE_UPDATER表示当前缓冲区还有多少待写的字节, addAndGet就是将当前的ByteBuf的长度进行累加, 累加到newWriteBufferSize中
在继续看判断 if (newWriteBufferSize > channel.config().getWriteBufferHighWaterMark())
channel.config().getWriteBufferHighWaterMark() 表示写buffer的高水位值, 默认是64k, 也就是说写buffer的最大长度不能超过64k
如果超过了64k, 则会调用setUnwritable(invokeLater)方法设置写状态
我们跟到setUnwritable(invokeLater)方法中:
private void setUnwritable(boolean invokeLater) {

    for (;;) {

        final int oldValue = unwritable;

        final int newValue = oldValue | 1;

        if (UNWRITABLE_UPDATER.compareAndSet(this, oldValue, newValue)) {

            if (oldValue == 0 && newValue != 0) {

                fireChannelWritabilityChanged(invokeLater);

            }

            break;

        }

    }

}
这里通过自旋和cas操作, 传播一个ChannelWritabilityChanged事件, 最终会调用handler的channelWritabilityChanged方法进行处理
以上就是写buffer的相关逻辑
Netty源码分析第7章(编码器和写数据)---->第3节: 写buffer队列的更多相关文章
- Netty源码分析第7章(编码器和写数据)---->第1节: writeAndFlush的事件传播
Netty源码分析第七章: 编码器和写数据 概述: 上一小章我们介绍了解码器, 这一章我们介绍编码器 其实编码器和解码器比较类似, 编码器也是一个handler, 并且属于outbounfHandle ...
- Netty源码分析第7章(编码器和写数据)---->第4节: 刷新buffer队列
Netty源码分析第七章: 编码器和写数据 第四节: 刷新buffer队列 上一小节学习了writeAndFlush的write方法, 这一小节我们剖析flush方法 通过前面的学习我们知道, flu ...
- Netty源码分析第7章(编码器和写数据)---->第5节: Future和Promies
Netty源码分析第七章: 编码器和写数据 第五节: Future和Promise Netty中的Future, 其实类似于jdk的Future, 用于异步获取执行结果 Promise则相当于一个被观 ...
- Netty源码分析第7章(编码器和写数据)---->第2节: MessageToByteEncoder
Netty源码分析第七章: Netty源码分析 第二节: MessageToByteEncoder 同解码器一样, 编码器中也有一个抽象类叫MessageToByteEncoder, 其中定义了编码器 ...
- Netty源码分析第6章(解码器)---->第1节: ByteToMessageDecoder
Netty源码分析第六章: 解码器 概述: 在我们上一个章节遗留过一个问题, 就是如果Server在读取客户端的数据的时候, 如果一次读取不完整, 就触发channelRead事件, 那么Netty是 ...
- Netty源码分析第3章(客户端接入流程)---->第1节: 初始化NioSockectChannelConfig
Netty源码分析第三章: 客户端接入流程 概述: 之前的章节学习了server启动以及eventLoop相关的逻辑, eventLoop轮询到客户端接入事件之后是如何处理的?这一章我们循序渐进, 带 ...
- Netty源码分析第3章(客户端接入流程)---->第2节: 处理接入事件之handle的创建
Netty源码分析第三章: 客户端接入流程 第二节: 处理接入事件之handle的创建 上一小节我们剖析完成了与channel绑定的ChannelConfig初始化相关的流程, 这一小节继续剖析客户端 ...
- Netty源码分析第3章(客户端接入流程)---->第3节: NioSocketChannel的创建
Netty源码分析第三章: 客户端接入流程 第三节: NioSocketChannel的创建 回到上一小节的read()方法: public void read() { //必须是NioEventLo ...
- Netty源码分析第3章(客户端接入流程)---->第4节: NioSocketChannel注册到selector
Netty源码分析第三章: 客户端接入流程 第四节: NioSocketChannel注册到selector 我们回到最初的NioMessageUnsafe的read()方法: public void ...
随机推荐
- Java并发编程--1.Thread和Runnable
创建线程 Java有两种方式创建线程, 继承Thread类和实现Runnable接口 继承Thread 步骤: 1.自定义一个类继承Thread类, 重写run方法 2.创建自定义类的对象,调用sta ...
- 禁止 "启动时恢复任何注册的应用程序"
在关闭计算机时 有些程序会进行注册 并在下次启动时恢复关闭前的状态(Restart Manager) 比如Chrome浏览器 应用程序实现这一功能可以调用RegisterApplicationRest ...
- 构建Vue开发环境
1.开发环境的准备工作 IDE 可以选择WebStom或者VisualStudio Code Node.js的安装 node + npm 调试环境 Google Chrome + Vue.js 2.什 ...
- Kafka设计解析(三)Kafka High Availability (下)
转载自 技术世界,原文链接 Kafka设计解析(三)- Kafka High Availability (下) 摘要 本文在上篇文章基础上,更加深入讲解了Kafka的HA机制,主要阐述了HA相关各种场 ...
- Spring整合MyBatis(二)Spring整合MyBatis
摘要: 本文结合<Spring源码深度解析>来分析Spring 5.0.6版本的源代码.若有描述错误之处,欢迎指正. 了解了MyBatis的独立使用过程后,我们再看看它与Spring整合的 ...
- P1776 宝物筛选_NOI导刊2010提高(02)
题目描述 终于,破解了千年的难题.小FF找到了王室的宝物室,里面堆满了无数价值连城的宝物……这下小FF可发财了,嘎嘎.但是这里的宝物实在是太多了,小FF的采集车似乎装不下那么多宝物.看来小FF只能含泪 ...
- Use UMDH to identify memory leak problem
We sometimes got memory leak problem, and we need to find the leaked memory, Here is a usful tool fr ...
- [转]Kafka 设计与原理详解
一.Kafka简介 本文综合了我之前写的kafka相关文章,可作为一个全面了解学习kafka的培训学习资料. 1 2 1 2 转载请注明出处 : 本文链接 1.1 背景历史 当今社会各种应用系统诸如商 ...
- 复制web项目时注意修改web项目名
改web项目的项目名可以右击->properties->搜索web找到settings->修改context name
- Cenos6.6 升级 python3.5.2 安装配置 django1.10
1 准备编译环境(环境如果不对的话,可能遇到各种问题,比如wget无法下载https链接的文件) yum groupinstall 'Development Tools' yum install zl ...