
selenium基础-打开百度进行搜索
1. 安装Python
2. 安装selenium
3. 下载谷歌驱动ChromeDriver,放到Python的Scripts目录下
4. 编写代码,如下
# coding: utf-8

from selenium import webdriver  # 浏览器驱动器

from selenium.webdriver.common.by import By  # 定位器

from selenium.webdriver.common.keys import Keys  # 键盘对象

from selenium.webdriver.support import expected_conditions as EC  # 判断器

from selenium.webdriver.support.wait import WebDriverWait  # 浏览器等待对像

import time

# 创建一个谷歌浏览器对象

browser = webdriver.Chrome()

try:

    # 浏览器对象打开百度地址

    browser.get("https://www.baidu.com")

    # 查找id为 'kw'的标签,即输入框

    inputs = browser.find_element_by_id("kw")

    # 在输入框中填入'Python'

    inputs.send_keys("Python")

    # '按下'回车键(第一种)

    inputs.send_keys(Keys.ENTER)

    # 点击'百度一下'(第二种)

    # browser.find_element_by_id("su").click()

    # 创建一个等待对像,超时时间为10秒,调用的时间间隔为0.5

    wait = WebDriverWait(browser, 10, 0.5)

    # 每隔0.5秒检查一次,直到页面元素出现id为'content_left'的标签

    wait.until(EC.presence_of_all_elements_located((By.ID, "content_left")))

except Exception as e:

    print e

else:

    # 打印请求的url

    print browser.current_url

    # 打印所有cookies

    print browser.get_cookies()

finally:

    # 等待10秒

    time.sleep(10)

    # 关闭浏览器对象

    browser.close()
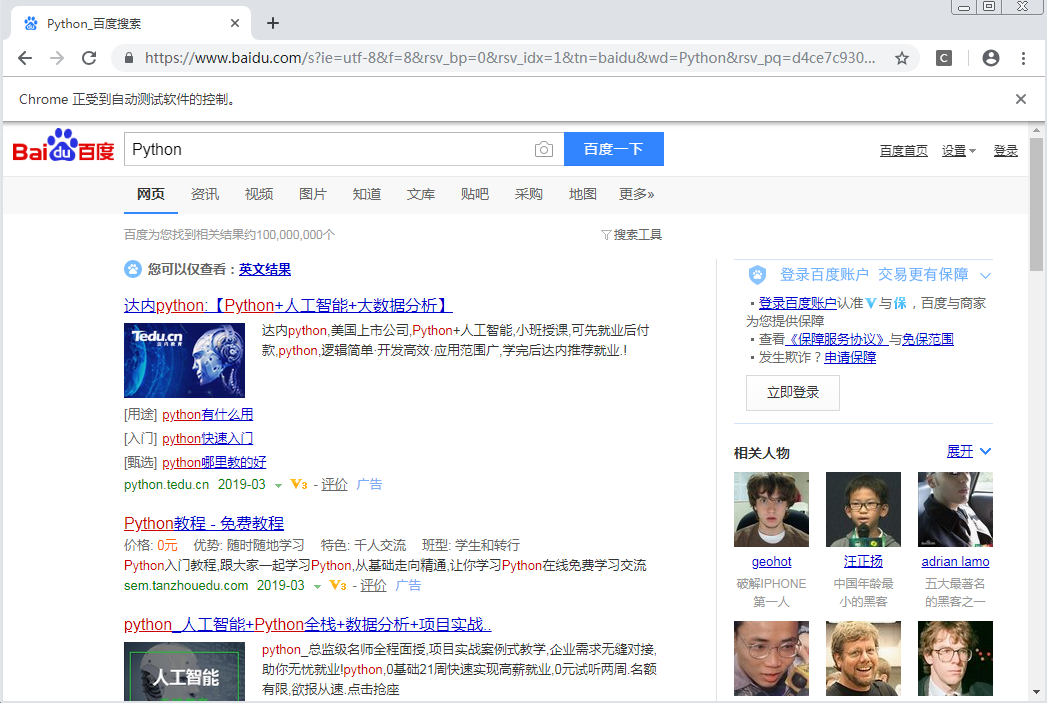
结果:
selenium基础-打开百度进行搜索的更多相关文章
- Selenium基础知识(一)环境与搜索
所需环境: 1.python2.7 + pycharm 2.Selenium 3.浏览器驱动(IEDriverServer.exe) 这里使用的是ie浏览器 将驱动放到一个环境变量路径,这里直接放在 ...
- 【cl】selenium实例一:打开百度,获取第四个标题
/*创建类的时候是TestNG Class*/ package Selenium_lassen; import static org.junit.Assert.*; import java.util. ...
- python+selenium实现自动化百度搜索关键词
通过python配合爬虫接口利用selenium实现自动化打开chrome浏览器,进行百度关键词搜索. 1.安装python3,访问官网选择对应的版本安装即可,最新版为3.7. 2.安装seleniu ...
- python+selenium实现百度关键词搜索自动化操作
缘起 之前公司找外面网络公司做某些业务相关关键词排名,了解了一下相关的情况,网络公司只需要我们提供网站地址和需要做的关键词即可,故猜想他们采取的方式应该是通过模拟用户搜索提升网站权重进而提升排名. 不 ...
- Python+Selenium基础篇-打开和关闭火狐浏览器
本节介绍如何初始化一个webdriver实例对象driver,然后打开和关闭firefox浏览器.要用selenium打开fiefox浏览器.首先需要去下载一个driver插件geckodriver. ...
- 使用python和selenium写一个百度搜索的case
今天练习的内容主要写了一个小功能,在百度上搜索某词汇,然后实现web上的back功能 代码如下: import unittest from selenium import webdriver from ...
- selenium(4):初次尝试,通过百度进行搜索
实现场景:打开chrome浏览器后,打开百度,再搜索栏里输入‘测试’,点击搜索按钮. 代码:定位方式,通过元素的ID. 定位技巧: ①鼠标定位需要定位的输入框,鼠标右键单击.选择检查. ②即可轻松的查 ...
- Selenium基础教程(二)环境搭建
一.环境搭建 (1)初学者最佳环境: Python 2.7 + Selenium 2+ Firefox 46 (2)喜欢尝新的环境: Python 3.6 + Selenium 3+ Firefox ...
- 『心善渊』Selenium3.0基础 — 4、Selenium基础元素定位详解
目录 1.什么是元素定位 2.Selenium元素定位常用API (1)By_id 定位 (2)by_name 定位 (3)by_class_name 定位 (4)by_tag_name 定位 (5) ...
随机推荐
- css选择器分类与作用
本文旨在总结css中各种选择器及其相应用途(持续更新) 通配符(全局)选择器 样式:*{} 示例: 总结:选定文档中所有类型的对象,如图所示写在css样式文件开头用来定义全局通用的一些属性.font- ...
- 在server 2003中搭建域服务(Http NTLM 代理)
在server 2003中搭建域服务(Http NTLM 代理) 在windows server 2003 X64中搭建域服务的操作. 可参考百度经验:http://www.cnblogs.com/z ...
- centos7上的postgresql10安装和配置
安装数据库 安装参考官方文档:https://www.postgresql.org/download/linux/redhat/ 1.Install the repository RPM: yum i ...
- Python 循环的技巧
当在字典中循环时,用 items() 方法可将关键字和对应的值同时取出 >>> knights = {'gallahad': 'the pure', 'robin': 'the br ...
- 前端常见算法面试题之 - 重建二叉树[JavaScript解法]
题目描述 输入某二叉树的前序遍历和中序遍历的结果,请重建出该二叉树.假设输入的前序遍历和中序遍历的结果中都不含重复的数字.例如输入前序遍历序列[1,2,4,7,3,5,6,8],和中序遍历序列[4,7 ...
- spring boot 配置全局日期类型转换器
1. 首先自定义一个类型转换器 import org.springframework.core.convert.converter.Converter; import org.springframew ...
- 搭建Harbor私有镜像仓库--v1.5.1
搭建Harbor私有镜像仓库--v1.5.1 1.介绍 Docker容器应用的开发和运行离不开可靠的镜像管理,虽然Docker官方也提供了公共的镜像仓库,但是从安全和效率等方面考虑,部署我们私有环境 ...
- deep learning loss总结
在深度学习中会遇到各种各样的任务,我们期望通过优化最终的loss使网络模型达到期望的效果,因此loss的选择是十分重要的. cross entropy loss cross entropy loss和 ...
- 虚拟机搭建Hadoop集群
安装包准备 操作系统:ubuntu-16.04.3-desktop-amd64.iso 软件包:VirtualBox 安装包:hadoop-3.0.0.tar.gz,jdk-8u161-linux-x ...
- decode 函数及其用法
http://blog.csdn.net/oscar999/article/details/18399177