
使用Redis实现UA池
前提
最近忙于业务开发、交接和游戏,加上碰上了不定时出现的犹豫期和困惑期,荒废学业了一段时间。天冷了,要重新拾起开始下阶段的学习了。之前接触到的一些数据搜索项目,涉及到请求模拟,基于反爬需要使用随机的User Agent,于是使用Redis实现了一个十分简易的UA池。
背景
最近的一个需求,有模拟请求的逻辑,要求每次请求的请求头中的User Agent要满足下面几点:
- 每次获取的
User Agent是随机的。 - 每次获取的
User Agent(短时间内)不能重复。 - 每次获取的
User Agent必须带有主流的操作系统信息(可以是Uinux、Windows、IOS和安卓等等)。
这里三点都可以从UA数据的来源解决,实际上我们应该关注具体的实现方案。简单分析一下,流程如下:

在设计UA池的时候,它的数据结构和环形队列十分类似:
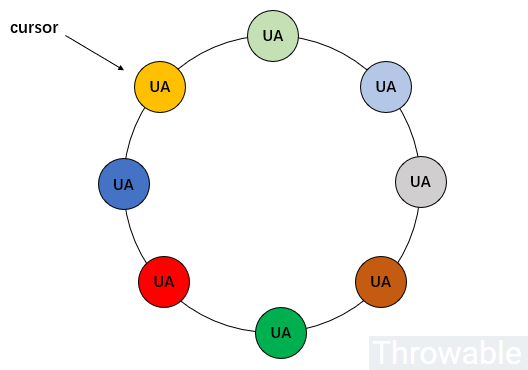
上图中,假设不同颜色的UA是完全不同的UA,它们通过洗牌算法打散放进去环形队列中,实际上每次取出一个UA之后,只需要把游标cursor前进或者后退一格即可(甚至可以把游标设置到队列中的任意元素)。最终的实现就是:需要通过中间件实现分布式队列(只是队列,不是消息队列)。
具体实现方案
毫无疑问需要一个分布式数据库类型的中间件才能存放已经准备好的UA,第一印象就感觉Redis会比较合适。接下来需要选用Redis的数据类型,主要考虑几个方面:
- 具备队列性质。
- 最好支持随机访问。
- 元素入队、出队和随机访问的时间复杂度要低,毕竟获取
UA的接口访问量会比较大。
支持这几个方面的Redis数据类型就是List,不过注意List本身不能去重,去重的工作可以用代码逻辑实现。然后可以想象客户端获取UA的流程大致如下:
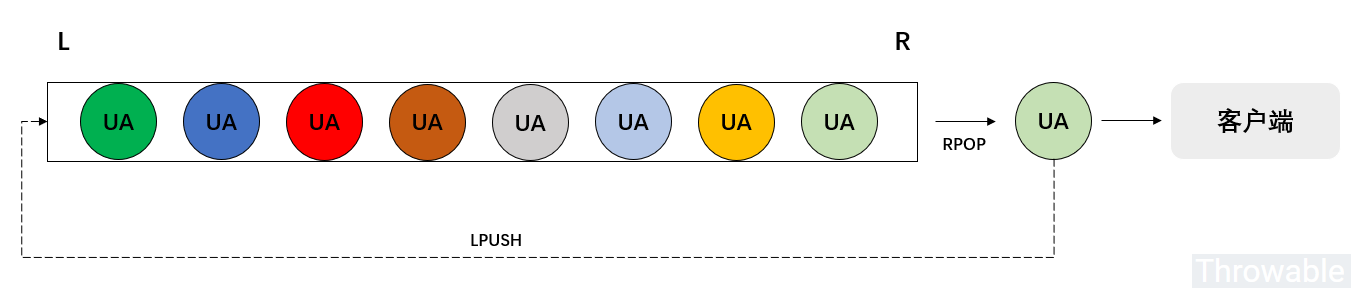
结合前面的分析,编码过程有如下几步:
- 准备好需要导入的
UA数据,可以从数据源读取,也可以直接文件读取。 - 因为需要导入的
UA数据集合一般不会太大,考虑先把这个集合的数据随机打散,如果使用Java开发可以直接使用Collections#shuffle()洗牌算法,当然也可以自行实现这个数据随机分布的算法,这一步对于一些被模拟方会严格检验UA合法性的场景是必须的。 - 导入
UA数据到Redis列表中。 - 编写
RPOP + LPUSH的Lua脚本,实现分布式循环队列。
编码和测试示例
引入Redis的高级客户端Lettuce依赖:
<dependency>

    <groupId>io.lettuce</groupId>

    <artifactId>lettuce-core</artifactId>

    <version>5.2.1.RELEASE</version>

</dependency>
编写RPOP + LPUSH的Lua脚本,Lua脚本名字暂称为L_RPOP_LPUSH.lua,放在resources/scripts/lua目录下:
local key = KEYS[1]

local value = redis.call('RPOP', key)

redis.call('LPUSH', key, value)

return value
这个脚本十分简单,但是已经实现了循环队列的功能。剩下来的测试代码如下:
public class UaPoolTest {

    private static RedisCommands<String, String> COMMANDS;

    private static AtomicReference<String> LUA_SHA = new AtomicReference<>();

    private static final String KEY = "UA_POOL";

    @BeforeClass

    public static void beforeClass() throws Exception {

        // 初始化Redis客户端

        RedisURI uri = RedisURI.builder().withHost("localhost").withPort(6379).build();

        RedisClient redisClient = RedisClient.create(uri);

        StatefulRedisConnection<String, String> connect = redisClient.connect();

        COMMANDS = connect.sync();

        // 模拟构建UA池的原始数据,假设有10个UA,分别是UA-0 ... UA-9

        List<String> uaList = Lists.newArrayList();

        IntStream.range(0, 10).forEach(e -> uaList.add(String.format("UA-%d", e)));

        // 洗牌

        Collections.shuffle(uaList);

        // 加载Lua脚本

        ClassPathResource resource = new ClassPathResource("/scripts/lua/L_RPOP_LPUSH.lua");

        String content = StreamUtils.copyToString(resource.getInputStream(), StandardCharsets.UTF_8);

        String sha = COMMANDS.scriptLoad(content);

        LUA_SHA.compareAndSet(null, sha);

        // Redis队列中写入UA数据,数据量多的时候可以考虑分批写入防止长时间阻塞Redis服务

        COMMANDS.lpush(KEY, uaList.toArray(new String[0]));

    }

    @AfterClass

    public static void afterClass() throws Exception {

        COMMANDS.del(KEY);

    }

    @Test

    public void testUaPool() {

        IntStream.range(1, 21).forEach(e -> {

            String result = COMMANDS.evalsha(LUA_SHA.get(), ScriptOutputType.VALUE, KEY);

            System.out.println(String.format("第%d次获取到的UA是:%s", e, result));

        });

    }

}
某次运行结果如下:
第1次获取到的UA是:UA-0

第2次获取到的UA是:UA-8

第3次获取到的UA是:UA-2

第4次获取到的UA是:UA-4

第5次获取到的UA是:UA-7

第6次获取到的UA是:UA-5

第7次获取到的UA是:UA-1

第8次获取到的UA是:UA-3

第9次获取到的UA是:UA-6

第10次获取到的UA是:UA-9

第11次获取到的UA是:UA-0

第12次获取到的UA是:UA-8

第13次获取到的UA是:UA-2

第14次获取到的UA是:UA-4

第15次获取到的UA是:UA-7

第16次获取到的UA是:UA-5

第17次获取到的UA是:UA-1

第18次获取到的UA是:UA-3

第19次获取到的UA是:UA-6

第20次获取到的UA是:UA-9
可见洗牌算法的效果不差,数据相对分散。
小结
其实UA池的设计难度并不大,需要注意几个要点:
- 一般主流的移动设备或者桌面设备的系统版本不会太多,所以来源
UA数据不会太多,最简单的实现可以使用文件存放,一次读取直接写入Redis中。 - 注意需要随机打散
UA数据,避免同一个设备系统类型的UA数据过于密集,这样可以避免触发模拟某些请求时候的风控规则。 - 需要熟悉
Lua的语法,毕竟Redis的原子指令一定离不开Lua脚本。
(本文完 c-2-d e-a-20191114)
原文链接
- Github Page:http://throwable.club/2019/11/14/redis-in-action-ua-pool/
- Coding Page:http://throwable.coding.me/2019/11/14/redis-in-action-ua-pool/
使用Redis实现UA池的更多相关文章
- selenium、UA池、ip池、scrapy-redis的综合应用案例
案例: 网易新闻的爬取: https://news.163.com/ 爬取的内容为一下4大板块中的新闻内容 爬取: 特点: 动态加载数据 ,用 selenium 爬虫 1. 创建项目 scrapy ...
- Redis客户端连接池
使用场景 对于一些大对象,或者初始化过程较长的可复用的对象,我们如果每次都new对象出来,那么意味着会耗费大量的时间. 我们可以将这些对象缓存起来,当接口调用完毕后,不是销毁对象,当下次使用的时候,直 ...
- redis运用连接池报错解决
redis使用连接池报错解决redis使用十几小时就一直报异常 redis.clients.jedis.exceptions.JedisConnectionException: Could not g ...
- selenium在scrapy中的使用、UA池、IP池的构建
selenium在scrapy中的使用流程 重写爬虫文件的构造方法__init__,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次). 重写爬虫文件的closed ...
- 14.UA池和代理池
今日概要 scrapy下载中间件 UA池 代理池 今日详情 一.下载中间件 先祭出框架图: 下载中间件(Downloader Middlewares) 位于scrapy引擎和下载器之间的一层组件. - ...
- UA池和代理池
scrapy下载中间件 UA池 代理池 一.下载中间件 先祭出框架图: 下载中间件(Downloader Middlewares) 位于scrapy引擎和下载器之间的一层组件. - 作用: (1)引擎 ...
- UA池和代理池在scrapy中的应用
一.下载中间件 下载中间件(Downloader Middlewares) 位于scrapy引擎和下载器之间的一层组件. - 作用: (1)引擎将请求传递给下载器过程中, 下载中间件可以对请求进行一系 ...
- 爬虫开发13.UA池和代理池在scrapy中的应用
今日概要 scrapy下载中间件 UA池 代理池 今日详情 一.下载中间件 下载中间件(Downloader Middlewares) 位于scrapy引擎和下载器之间的一层组件. - 作用: ( ...
- scrapy下载中间件,UA池和代理池
一.下载中间件 框架图: 下载中间件(Downloader Middlewares) 位于scrapy引擎和下载器之间的一层组件. - 作用: (1)引擎将请求传递给下载器过程中, 下载中间件可以对请 ...
随机推荐
- 运用Java调用Kettle Job和Trans(带参数)
1.首先创建一个kettle trans 2.对表输入进行编辑 ${dateNow}为要传入的参数. 3.代码编写 首先需要把包导入 import org.pentaho.di.core.Kettle ...
- Instrument API介绍
1. Instrumentation介绍 JVMTI(JVM Tool Interface)是 Java 虚拟机所提供的 native 编程接口,是 JVMPI(Java Virtual Machi ...
- SpringCloud-创建服务消费者-Ribbon方式(附代码下载)
场景 SpringCloud-服务注册与实现-Eureka创建服务注册中心(附源码下载): https://blog.csdn.net/BADAO_LIUMANG_QIZHI/article/deta ...
- 阿里云ECS部署Redis主备哨兵集群遇到的问题
一.部署 详细部署步骤:https://blog.csdn.net/lihongtai/article/details/82826809 Redis5.0版本需要注意的参数配置:https://www ...
- 【STM32-V6】STM32F429BIT6开发板开源, 丰富软件资源, 强劲硬件配置, 配套400多实例, 9套手册持续更新中2019-12-12
淘宝购买地址:淘宝购买链接 次.当前标准库最新版本V2.3,HAL库最新版本V1.1 安富莱微信公共平台,欢迎大家关注(打造高质量公众号) 新版用户手册,重在BSP驱动包设计方法,HAL库的框架学习, ...
- finger
finger <username> 显示用户信息,包括用户的home目录,上一次登录的时间,默认shell等 finger XXXXX #输出: #Login: XXXXX Name: X ...
- 工具类Arrays.asList()方法把数组转换成集合
工具类Arrays.asList()方法把数组转换成集合 不能使用其修改集合相关的方法,它的add/remove/clear方法会抛出UnsupportedOperationException() 问 ...
- IT兄弟连 HTML5教程 W3C盒子模型
日常生活中所见的盒子也就是能装东西的一种箱子,如果家里的东西很多,那么就需要按类别装到不同的箱子中.网页中的内容表现也是一样的,如果页面内容比较多,又想让页面更整洁.更美观.有很好的用户体验,则也需要 ...
- 每个Web开发者都该了解的12条命令行
转载请注明出处:葡萄城官网,葡萄城为开发者提供专业的开发工具.解决方案和服务,赋能开发者.原文出处:https://tutorialzine.com/2017/08/12-terminal-comma ...
- Mysql - 高可用方案之MMM(二)
一.概述 上一篇博客中(https://www.cnblogs.com/ddzj01/p/11535796.html)介绍了如何搭建MMM架构,本文将通过实验介绍MMM架构的优缺点. 二.优点 1. ...