
Stanford机器学习---第九讲. 聚类
原文:http://blog.csdn.net/abcjennifer/article/details/7914952
本栏目(Machine learning)包括单参数的线性回归、多参数的线性回归、Octave Tutorial、Logistic Regression、Regularization、神经网络、机器学习系统设计、SVM(Support Vector Machines 支持向量机)、聚类、降维、异常检测、大规模机器学习等章节。内容大多来自Standford公开课machine learning中Andrew老师的讲解和其他书籍的借鉴。(https://class.coursera.org/ml/class/index)
第九讲. 聚类——Clustering
===============================
(一)、什么是无监督学习?
(二)、KMeans聚类算法
(三)、Cluster问题的(distortion)cost function
(四)、如何选择初始化时的类中心
(五)、聚类个数的选择
=====================================
(一)、什么是无监督学习
之前的几章我们只涉及到有监督学习,本章中,我们通过讨论另一种Machine learning方式:无监督学习。首先呢,我们来看一下有监督学习与无监督学习的区别。
给定一组数据(input,target)为Z=(X,Y)。
有监督学习:最常见的是regression & classification。
- regression:Y是实数vector。回归问题,就是拟合(X,Y)的一条曲线,使得下式cost function L最小。

- classification:Y是一个finite number,可以看做类标号。分类问题需要首先给定有label的数据训练分类器,故属于有监督学习过程。分类问题中,cost function L(X,Y)是X属于类Y的概率的负对数。
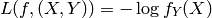 ,其中fi(X)=P(Y=i | X);
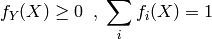
无监督学习:无监督学习的目的是学习一个function f,使它可以描述给定数据的位置分布P(Z)。 包括两种:density estimation & clustering.
- density estimation就是密度估计,估计该数据在任意位置的分布密度
- clustering就是聚类,将Z聚集几类(如K-Means),或者给出一个样本属于每一类的概率。由于不需要事先根据训练数据去train聚类器,故属于无监督学习。
- PCA和很多deep learning算法都属于无监督学习。
好了,大家理解了吧,unsupervised learning也就是不带类标号的机器学习。
练习:

=====================================
(二)、K-Means聚类算法
KMeans是聚类算法的一种,先来直观的看一下该算法是怎样聚类的。给定一组数据如下图所示,K-Means算法的聚类流程如图:


图中显示了Kmeans聚类过程,给定一组输入数据{x(1),x(2),...,x(n)}和预分类数k,算法如下:

首先随机指定k个类的中心U1~Uk,然后迭代地更新该centroid。
其中,C(i)表示第i个数据离那个类中心最近,也就是将其判定为属于那个类,然后将这k各类的中心分别更新为所有属于这个类的数据的平均值。
=====================================
(三)、Cluster问题的(distortion)cost function
在supervised learning中我们曾讲过cost function,类似的,在K-means算法中同样有cost function,我们有时称其为distortion cost function.
如下图所示,J(C,U)就是我们要minimize的function.

即最小化所有数据与其聚类中心的欧氏距离和。
再看上一节中我们讲过的KMeans算法流程,第一步为固定类中心U,优化C的过程:

第二步为优化U的过程:

这样进行迭代,就可以完成cost function J的优化。
练习:

这里大家注意,回归问题中有可能因为学习率设置过大产生随着迭代次数增加,cost function反倒增大的情况。但聚类是不会产生这样的问题的,因为每一次聚类都保证了使J下降,且无学习率做参数。
=====================================
(四)、如何选择初始化时的类中心
在上面的kmeans算法中,我们提到可以用randomly的方法选择类中心,然而有时效果并不是非常好,如下图所示:

fig.1. original data
对于上图的这样一组数据,如果我们幸运地初始化类中心如图2,

fig.2. lucky initialization

fig.3. unfortunate initialization
但如果将数据初始化中心选择如图3中的两种情况,就悲剧了!最后的聚类结果cost function也会比较大。针对这个问题,我们提出的solution是,进行不同initialization(50~1000次),每一种initialization的情况分别进行聚类,最后选取cost function J(C,U)最小的作为聚类结果。
=====================================
(五)、聚类个数的选择
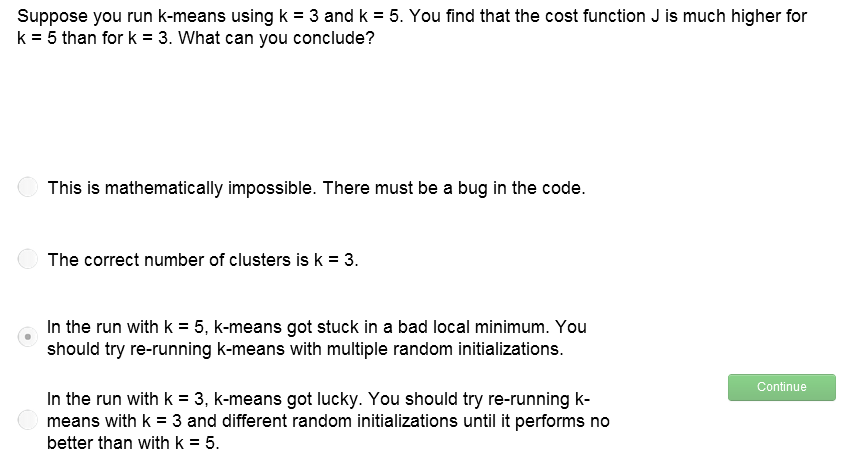
How to choose the number of clusters? 这应该是聚类问题中一个头疼的part,比如KMeans算法中K的选择。本节就来解决这个问题。
最著名的一个方法就是elbow-method,做图k-J(cost function)如下:

若做出的图如上面左图所示,那么我们就找图中的elbow位置作为k的选定值,如果像右图所示并无明显的elbow点呢,大概就是下图所示的数据分布:
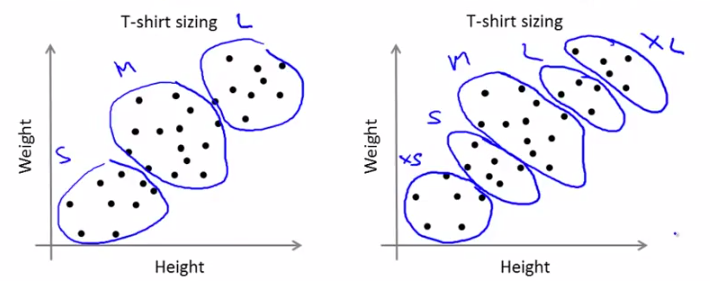
这种情况下需要我们根据自己的需求来进行聚类,比如Tshirt的size,可以聚成{L,M,S}三类,也可以分为{XL,L,M,S,XS}5类。需要大家具体情况具体分析了~
练习:
Stanford机器学习---第九讲. 聚类的更多相关文章
- Stanford机器学习---第二讲. 多变量线性回归 Linear Regression with multiple variable
原文:http://blog.csdn.net/abcjennifer/article/details/7700772 本栏目(Machine learning)包括单参数的线性回归.多参数的线性回归 ...
- Stanford机器学习笔记-9. 聚类(Clustering)
9. Clustering Content 9. Clustering 9.1 Supervised Learning and Unsupervised Learning 9.2 K-means al ...
- Stanford机器学习---第一讲. Linear Regression with one variable
原文:http://blog.csdn.net/abcjennifer/article/details/7691571 本栏目(Machine learning)包括单参数的线性回归.多参数的线性回归 ...
- Stanford机器学习笔记-9. 聚类(K-means算法)
9. Clustering Content 9. Clustering 9.1 Supervised Learning and Unsupervised Learning 9.2 K-means al ...
- 机器学习六--K-means聚类算法
机器学习六--K-means聚类算法 想想常见的分类算法有决策树.Logistic回归.SVM.贝叶斯等.分类作为一种监督学习方法,要求必须事先明确知道各个类别的信息,并且断言所有待分类项都有一个类别 ...
- PE格式第九讲,资源表解析
PE格式第九讲,资源表解析 一丶熟悉Windows管理文件的方法 首先,为什么标题是这个,主要是为了下边讲解资源方便,因为资源结构体很乱.如果直接拿出来讲解,那么就会很晕. 1.windows管理文件 ...
- Linux第九讲随笔 -进程管理 、ps aux 、
Linux第九讲1,进程管理 Linux在执行每一个程序时,就会在内存中为这个程序建立一个进程,以便让内核可以管理这个运行中的进程,进程是系统分配各种资源,进程调度的基本单位. 怎么查看进程 一.ps ...
- python学习第九讲,python中的数据类型,字符串的使用与介绍
目录 python学习第九讲,python中的数据类型,字符串的使用与介绍 一丶字符串 1.字符串的定义 2.字符串的常见操作 3.字符串操作 len count index操作 4.判断空白字符,判 ...
- Linux基础知识第九讲,linux中的解压缩,以及软件安装命令
目录 Linux基础知识第九讲,linux中的解压缩,以及软件安装命令 一丶Linux Mac Windows下的压缩格式简介 2.压缩以及解压缩 3.linux中的软件安装以及卸载 1.apt进行安 ...
随机推荐
- offsetWidth与scrollLeft
有两个值一个是:scrollTop一个是scrollLeft第一个代表页面利用滚动条滚动到下方时,隐藏在滚动条上方的页面的高度:第二个代表页面利用滚动条滚动到右侧时,隐藏在滚动条左侧的页面的宽度 do ...
- 原生js dom记忆的内容
1.DOM基础getElementByIdgetElementByTagNamegetElementByName getElementsByClass querySelector querySelec ...
- 18.C#扩展方法(十章10.1-10.2)
今天的话题,我们来聊下扩展方法,自己也真心感叹自己的文笔,那叫一个惨啊,回顾写的文章,看着看着也忘记当时是怀着什么心态写的,哈哈,现代人真心是太随性了,可能也是太冷漠了,接着写的吧,总是会有帮助,也会 ...
- 阿里百川IIMSDK-- 加好友,获取好友
加好友, 其实就是跟发消息一样 获取好友列表 同步好友列表 SDK内部默认会在每次登陆成功后与服务端同步好友列表,开发者可以通过设置disableAutoRequestAllContacts来禁用这个 ...
- if...else语句的应用题
应用题 namespace ConsoleApplication1 { /* 题目要求:提示用户输入年龄,如果大于等于18,那么用户可以查看.如果小于10岁,则告知用户”少儿不宜“. 如果大于等于10 ...
- poj3580 伸展树(区间翻转 区间搬移 删除结点 加入结点 成段更新)
好题.我做了很久,学了大牛们的区间搬移.主要的代码都有注释. #include<cstdio> #include<cstring> #include<iostream&g ...
- RHCS
简介 Red Hat Cluster Suite :红帽子集群套件 高可用性.高可靠性.负载均衡.存储共享 高可用集群是 RHCS 的核心功能.当应用程序出现故障,或者系统硬件. 网络出现故障时,应用 ...
- Oracle新建数据库(新用户)
1.首先,创建(新)用户: create user username identified by password; username:新用户名的用户名 password: 新用户的密码也可以不创建新 ...
- Java编程思想学习(八) 内部类
可以将一个类的定义放在另一个类的定义内部,这就是内部类. 内部类的定义是简单的,但是它的语法确实很是复杂,让人不是很好理解.下面就内部类做一个小结. 一.内部类的分类 总的来讲内部类分为普通内部类,匿 ...
- SpringMVC 配置log4j
log4j.properties相关 http://www.cnblogs.com/ITEagle/archive/2010/04/23/1718365.html http://www.cnblogs ...