
Python之scrapy框架之post传输数据错误:TypeError: to_bytes must receive a unicode, str or bytes object, got int
错误名:TypeError: to_bytes must receive a unicode, str or bytes object, got int
错误翻译:类型错误:to_bytes必须接收unicode、str或bytes对象,得到int to_bytes也就是需要传给服务器的二进制数据
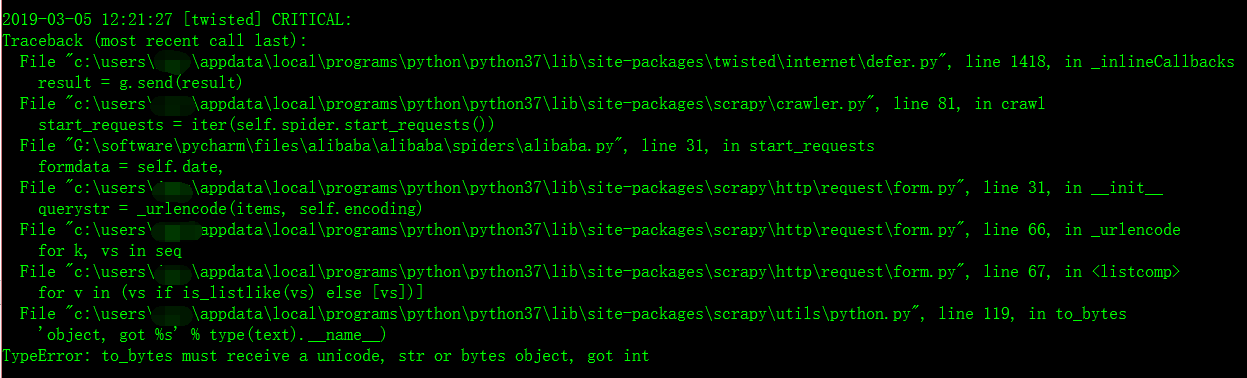
今天我企图用scrapy爬虫框架爬取阿里巴巴以及百度和腾讯的招聘网站的职位信息,在简单的进行数据分析。但是当我在写框架代码时,遇到了一个错误,我找了很久,最后发现只是一个小小的错误,就是字符串的格式出错了,我足足弄了两个小时。唉,真是想骂自己啊。。。
先来上我的错误代码
 from lxml import etree
 import scrapy
 from scrapy.linkextractors import LinkExtractor
 from scrapy.spiders import Rule,CrawlSpider
 from alibaba.items import AlibabaItem
 import json

 class AlibabaSpider(CrawlSpider):
     name = "alibabahr"
     allowed_domains = ["alibaba.com"]

     def __init__(self,pageIndex):      #由于阿里巴巴的限制,他们将职位信息放在了一个json文件中,用js进行数据传输,但是也没有关系,还是一样可以抓取到   下面是json数据抓取的链接URL
         self.start_urls = ["https://job.alibaba.com/zhaopin/socialPositionList/doList.json"]
         self.pageIndex = pageIndex   #这是需要抓取的页数

     def start_requests(self):
         for page in range(int(self.pageIndex)):
             yield scrapy.FormRequest(
                 url = self.start_urls[0],
                 callback = self.parse,
                 formdata = {"pageIndex":page,"pageSize":10},  #因为阿里的一个json文件中,是放10个职位的信息,也就是一页的信息,官网上是一            #页10个职位信息   大家看到那个"pageIndex":page,"pageSize":10  了吗,那个value值在这里是一个int型的数据,但是在进行post数据传输时,scrapy.FormRuquest            #这个方法默认是传输字符串的   所以就会报那个错误,我们只需要把那个10和page变成str数据结构就行了。           #将最后那句改成  : formdata = {"pageIndex":str(page),"pageSize":"10"},   就可以了
             )

     def parse(self, response):
         content = json.loads(response.body)['returnValue']
         pageIndex = content['pageIndex']
         jobDates = content['datas']
         print("pageIndex:" + str(pageIndex))
         print(jobDates)
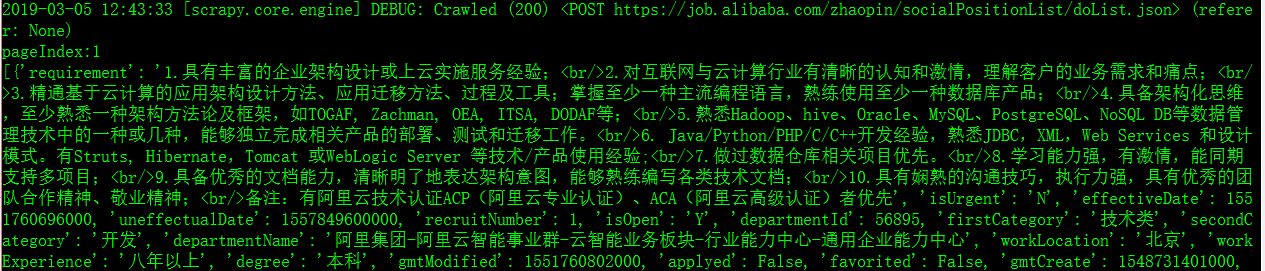
改正错误之后,显示的信息是真确的,如图:
Python之scrapy框架之post传输数据错误:TypeError: to_bytes must receive a unicode, str or bytes object, got int的更多相关文章
- python爬虫scrapy框架——人工识别登录知乎倒立文字验证码和数字英文验证码(2)
操作环境:python3 在上一文中python爬虫scrapy框架--人工识别知乎登录知乎倒立文字验证码和数字英文验证码(1)我们已经介绍了用Requests库来登录知乎,本文如果看不懂可以先看之前 ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- python爬虫scrapy框架
Scrapy 框架 关注公众号"轻松学编程"了解更多. 一.简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量 ...
- Python爬虫Scrapy框架入门(1)
也许是很少接触python的原因,我觉得是Scrapy框架和以往Java框架很不一样:它真的是个框架. 从表层来看,与Java框架引入jar包.配置xml或.property文件不同,Scrapy的模 ...
- Python爬虫Scrapy框架入门(0)
想学习爬虫,又想了解python语言,有个python高手推荐我看看scrapy. scrapy是一个python爬虫框架,据说很灵活,网上介绍该框架的信息很多,此处不再赘述.专心记录我自己遇到的问题 ...
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
- Python爬虫-- Scrapy框架
Scrapy框架 Scrapy使用了Twisted作为框架,Twisted有些特殊的地方是它是事件驱动的,并且比较适合异步的代码.对于会阻塞线程的操作包含访问文件.数据库或者Web.产生新的进程并需要 ...
- Python爬虫 ---scrapy框架初探及实战
目录 Scrapy框架安装 操作环境介绍 安装scrapy框架(linux系统下) 检测安装是否成功 Scrapy框架爬取原理 Scrapy框架的主体结构分为五个部分: 它还有两个可以自定义下载功能的 ...
- python安装Scrapy框架
看到自己写的惨不忍睹的爬虫,觉得还是学一下Scrapy框架,停止一直造轮子的行为 我这里是windows10平台,python2和python3共存,这里就写python2.7安装配置Scrapy框架 ...
随机推荐
- mybatis中的factory工厂与Sqlsession
1.SqlSession的使用范围 SqlSession中封装了对数据库的操作,如:查询.插入.更新.删除等.通过SqlSessionFactory创建SqlSession,而SqlSessionFa ...
- Ninject在.NET WebForm和MVC中的使用
1.建立项目:Models/BLL/DAL/IBLL/IDAL/WebSite 2.WebSite要引用其余几个项目 3.NuGet中搜索Ninject,安装 Ninject.Ninject.Web. ...
- jquery获得/修改html标签
1.添加 meta$("head").append('<meta http-equiv="content-type" content="text ...
- mysql中timestamp简单用法
该时间字段有比较特殊的地方,显示内容datetime字段一样.当取值为null或者不赋值时,显示当前系统时间,然后在其他地区读取的时候会根据当地的时间转换成当地的系统时间.
- [Selenium]Grid模式下运行时打印出当前Case在哪台node机器上运行
当Case在本地运行成功,在Grid模式下运行失败时,我们需要在Grid模式下进行调试,同时登录远程的node去查看运行的情况. Hub是随机将case分配到某台node上运行的,怎样知道当前的cas ...
- 有些标签的class有多个值,用空格隔开的,是什么意思阿?
这个div同时应用了三个class.三个class的设置都会对它起作用,相互冲突时,越后面的class优先权越高.
- Jakarta Commons Cookbook
Cookbook就是工具书,应该是前年看的,在中关村看的影印版,全英文,本书主要讲解了一下模块: Core:BeanUtils,Lang,Collections,logging Db:DbUtil ...
- 如何讓 iOS UIWebView 連線時傳送自訂 Cookie 的方法[转]
利用 NSHTTPCookieStorage 管理 Cookie 傳送 在 iOS 中如果自行建立 UIWebView 來開啟遠端站台資料,這時可以透過以下方法加入 Cookie.原理是透過 iOS ...
- (DP)uva 10036 Problem C: Divisibility
链接: http://acm.hust.edu.cn/vjudge/contest/view.action?cid=88171#problem/F 代码: #include <cstdio> ...
- 企业搜索引擎开发之连接器connector(二十六)
连接器通过监视器对象DocumentSnapshotRepositoryMonitor从上文提到的仓库对象SnapshotRepository(数据库仓库为DBSnapshotRepository)中 ...