
Hadoop的伪分布式安装和部署流程
在opt目录创建install software test other四个目录
/opt/installed #安装包
/opt/software #软件包
/opt/other #其他
/opt/test #测试
1.上传hadoop
yum install lrzsz //安装lrzsz用于上传
cd install //进入Install文件夹
输入rz
找到本地下载好的hadoop压缩包 点击hadoop-2.7.7.tar.gz上传
因hadoop使用java编写,所以需要jdk
rz jdk-8u181-linux-x64.tar.gz
2.解压hadoop
tar -zxvf jdk-8u181-linux-x64.tar.gz -C /opt/software
tar -zxvf hadoop-2.7.7.tar.gz -C /opt/software #把角度看和hadoop解压到指定的software文件夹中
cd ../software
mv jdk1.8.0_221 jdk1.8 //把jdk改名
3.配置环境
vim /etc/profile
在末尾加:
JAVA_HOME=/opt/software/jdk1.8
CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
Path=$PATH:$JAVA_HOME/bin
:wq退出
source /etc/profile #linux内核 重新加载某个文件
4. 测试 是否配置成功
java -version
显示如下则成功
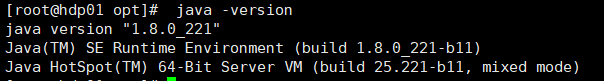
5.hadoop目录说明
cd hadoop-2.7.7 #进入Hadoop安装目
bin 普通命令目录
etc #所有的配置文件
include #C语言相关文件
lib/native #C语言相关类库
libexec #C语言相关类库2
logs #日志文件
sbin #管理命令目录
share #jar包和源码
6.配置六个文件
cd etc/hadoop的目录
1. vim hadoop-env.sh
25行 JAVA_HOME=/opt/software/jdk1.8 #JDK的存放目录
33行 export HADOOP_CONF_DIR=/opt/software/hadoop-2.7.7/etc/hadoop
2.vim core-site.xml #我们在x-site中配置 实际上就是将系统原来的配置给覆盖了
<configuration>
<property>
<name>fs.defaultFS</name>
<value>hdfs://主机名:9000</value>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/opt/software/hadoop-2.7.7/tmp</value>
</property>
</configuration>
3.vim hdfs-site.xml
<configuration>
<property>
<name>dfs.replication</name>
<value>1</value>
</property>
</configuration>
4.cp mapred-site.xml.template mapred-site.xml
vim mapred-site.xml
<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
</configuration>
5.vim yarm-site.xml
<configuration>
<!-- Site specific YARN configuration properties -->
<property>
<name>yarn.resourcemanager.hostname</name>
<value>主机名</value>
</property>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
</configuration>
6.vim slaves
加入 主机名
vim /etc/hosts
加入 ip地址 主机名
7.配置一下环境变量
vim /etc/profile
JAVA_HOME=/opt/software/jdk1.8
CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
HADOOP_HOME=/opt/software/hadoop-2.7.7
PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
source /etc/profile
8.配置一个免密
ssh-keygen #生成公钥
ssh-copy-id 主机名
9.格式化文件系统
hadoop namenode -format
如果看到 has been successfully formatted. 则成功
10.运行服务器
start-all.sh 开启
stop-all.sh 关闭
Hadoop的伪分布式安装和部署流程的更多相关文章
- Hadoop的伪分布式安装和部署的流程
1.准备工作 下载一些用到的命令 yum install -y vim yum install -y lrzsz yum install net-tools 目录约定 /opt #工作目录 /opt/ ...
- Hadoop开发第3期---Hadoop的伪分布式安装
一.准备工作 1. 远程连接工具的安装 PieTTY 是在PuTTY 基础上开发的,改进了Putty 的用户界面,提供了多语种支持.Putty 作为远程连接linux 的工具,支持SSH 和telne ...
- Hadoop之伪分布式安装
一.Hadoop的安装模式有3种 ①单机模式:不能使用HDFS,只能使用MapReduce,所以单击模式主要用于测试MR程序. ②伪分布式模式:用多个线程模拟真实多台服务器,即模拟真实的完全分布式环境 ...
- 【Hadoop】伪分布式安装
创建hadoop用户 创建用户命令: sudo useradd -m hadoop -s /bin/bash 创建好后需要更改hadoop用户的密码,命令如下: sudo passwd hadoop ...
- 【hadoop】 hadoop 单机伪分布式安装
准备: 虚拟机(CentOS 6.9) JDK1.8 hadoop2.8.0 一.JDK安装及配置 rpm -ivh jdkxxxx 安装 配置环境变量 vim /etc/profile export ...
- 伪分布式安装core-site.xml和hdfs-site.xml配置文件
hadoop的伪分布式安装流程如下所示: 其中core-site.xml和hdfs-site.xml是两个很重要的配置文件. core-site.xml <configuration> & ...
- 伪分布式安装Hadoop
Hadoop简单介绍 Hadoop:适合大数据分布式存储与计算的平台. Hadoop两大核心项目: 1.HDFS:Hadoop分布式文件系统 HDFS的架构: 主从结构: 主节点,只有一个:namen ...
- hadoop 2.7.3伪分布式安装
hadoop 2.7.3伪分布式安装 hadoop集群的伪分布式部署由于只需要一台服务器,在测试,开发过程中还是很方便实用的,有必要将搭建伪分布式的过程记录下来,好记性不如烂笔头. hadoop 2. ...
- Hadoop单机和伪分布式安装
本教程为单机版+伪分布式的Hadoop,安装过程写的有些简单,只作为笔记方便自己研究Hadoop用. 环境 操作系统 Centos 6.5_64bit 本机名称 hadoop001 本机IP ...
随机推荐
- 154. 寻找旋转排序数组中的最小值 II
转跳点:--\(˙<>˙)/-- 原本打算大年三十十一起写完的,结果这篇拖到了年初一…… 这道题比刚刚那道,麻烦一点,因为有重复,所以我们需要考虑重复的情况,就是刚刚的两种情况变成了三种: ...
- springcloud--ruul(路由网关)
Zuul的主要功能就是路由转发和过滤器 实例: 1:添加依赖pom.xml: <dependencies> <dependency> <groupId>org.sp ...
- IO流常用模式
主要运用2个设计模式,适配器和装饰者模式.
- ActorFramework教程对比及规划
牢骚太盛防肠断,风物长宜放眼量. 一.引子 昨天的文章,本来就是想写写ActorFramework的教程内容,结果写着写着偏了,变成了吐槽. 首先,声明一下,自己从未参加过任何LabVIEW培训班,也 ...
- TensorFlow--交互式使用--tf.InteractiveSession()
用tf.Session()创建会话时只有在会话中run某个张量才能得到这个张量的运算结果,而交互式环境下如命令行.IPython,想要执行一行就得到结果,这就需要用到tf.InteractiveSes ...
- 【机器学习实战学习笔记(2-2)】决策树python3.6实现及简单应用
文章目录 1.ID3及C4.5算法基础 1.1 计算香农熵 1.2 按照给定特征划分数据集 1.3 选择最优特征 1.4 多数表决实现 2.基于ID3.C4.5生成算法创建决策树 3.使用决策树进行分 ...
- Elasticsearch 使用集群 - 删除索引
章节 Elasticsearch 基本概念 Elasticsearch 安装 Elasticsearch 使用集群 Elasticsearch 健康检查 Elasticsearch 列出索引 Elas ...
- UVA - 11346 Probability(概率)(连续概率)
题意:在[-a, a]*[-b, b]区域内随机取一个点P,求以(0, 0)和P为对角线的长方形面积大于S的概率(a,b>0, S>=0). 分析: 1.若长方形面积>S,则选取的P ...
- css div框加小箭头
<div class="con"> <div class="arrow"> </div></div> .c ...
- 数据库连接池C3P0的使用
一.直接使用代码链接(一般企业开发不会用到.大多数用方法二) 1.导入jar 2.新建JDBCUtil import java.io.FileInputStream; import java.io.I ...