
NMS(non maximum suppression,非极大值抑制)
"""
nms输入的数据为box的左上角x1,y1与右下角x2,y2+confidence,rows=batch_size,line=[x1,y1,x2,y2,confidence];
首先将batch_size按照已给的confidence从大到小排序,将最大confidence的box保存,而后与其它batch_size-1个boxes进行iou,
得到新的batch_size-1个iou(confidence),然后与阈值(threshold)相比较,保留满足阈值的boxes,
而后将保留后的boxes按照求解的confidence进行从大到小排序,保留最大box,以此类推,最终保留下来的为需要的boxes,
包含对应原来的confidence
其具体做法如下code。
"""
import numpy as np
boxes = np.array([
                [204, 102, 358, 250, 0.5],
                [257, 118, 380, 250, 0.7],
                [280, 135, 400, 250, 0.6],
                [255, 118, 360, 235, 0.7]])
box_threshold = 0.7
def NMS(BOXES, box_threshold):
    """Pure Python NMS baseline."""
    x1 = BOXES[:, 0]  # xmin
    y1 = BOXES[:, 1]  # ymin
    x2 = BOXES[:, 2]  # xmax
    y2 = BOXES[:, 3]  # ymax
    confidence = BOXES[:, 4]  # confidence
    boxes_areas = (x2 - x1 + 1) * (y2 - y1 + 1)  # the size of bbox
    confidence_index = confidence.argsort()[::-1]  # sort bounding boxes by decreasing order, returning array([3, 1, 2, 0])
    save_boxes_end_index = []  # store the final bounding boxes of index
    while confidence_index.size > 0: # 此行代码表示存在有置信度的box,才会运行。若只有一个box则下面将会和自己比较
        i = confidence_index[0]  # 永远取置信率最高的框作为物体的最佳框
        save_boxes_end_index.append(i)  # 第一次运行保存置信度最大box的索引值
        # 获取两个框相交矩形的坐标
        # 左上角坐标取二者最大;右下角取二者最小
        xx1 = np.maximum(x1[i], x1[confidence_index[1:]])  # array([ 257.,  280.,  255.]) 保存相交区域左上角x
        yy1 = np.maximum(y1[i], y1[confidence_index[1:]])  # array([ 118.,  135.,  118.])  保存相交区域左上角y
        xx2 = np.minimum(x2[i], x2[confidence_index[1:]])  # array([ 360.,  360.,  358.]) 保存相交区域右下角x
        yy2 = np.minimum(y2[i], y2[confidence_index[1:]])  # array([ 235.,  235.,  235.]) 保存相交区域右下角y
        w = np.maximum(0.0, xx2 - xx1 + 1)  # array([ 104.,   81.,  104.])
        h = np.maximum(0.0, yy2 - yy1 + 1)  # array([ 118.,  101.,  118.])
        # 计算相交矩形面积
        boxes_cross_areas = w * h  # array([ 12272.,   8181.,  12272.])
        # 计算IOU
        # Cross Area / (bbox + particular area - Cross Area)
        boxes_iou = boxes_cross_areas / (boxes_areas[i] + boxes_areas[confidence_index[1:]] - boxes_cross_areas)
        # reserve all the bounding box whose ovr less than thresh
        confidence_process_index = np.where(boxes_iou <= box_threshold)[0]           # 返回boxes_iou中小于box_threshold的索引值
        # 与置信度最大的box比较,分别求解出其它boxes的iou值(是下次其它boxes置信度的值),而后只保留比例小于阙值的框,然后继续处理
        confidence_index = confidence_index[confidence_process_index + 1]  # 因为boxes_iou根据其它boxes与最大box得到一维矩阵,实际少了第一个box,因此confidence_process_index需要+1,而后得到新的confidence——index
    boxes_end = []
    for i in range(len(save_boxes_end_index)):
        boxes_end.append(BOXES[save_boxes_end_index[i]])
    boxes_end=np.array(boxes_end)
    return boxes_end
boxes_end = NMS(boxes, box_threshold)
print(boxes_end)

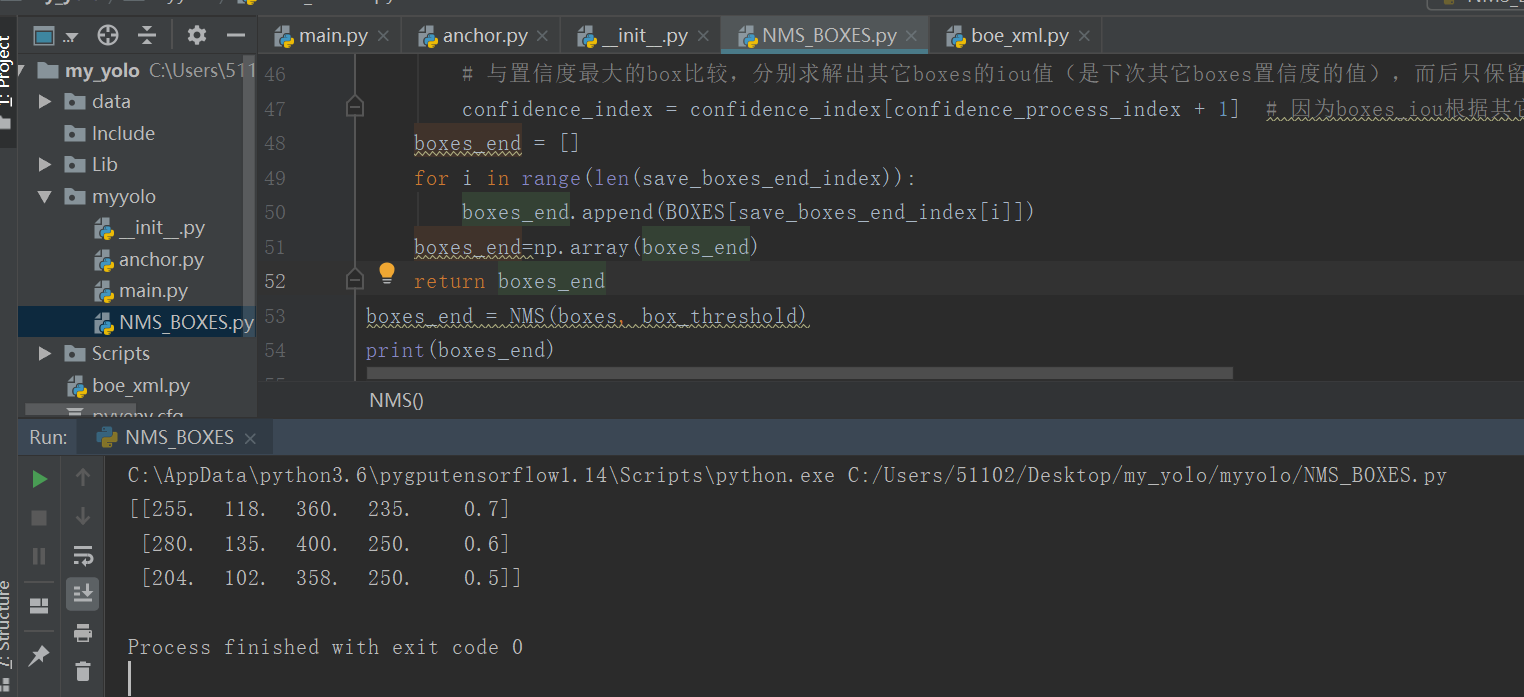
其运行结果如下:
NMS(non maximum suppression,非极大值抑制)的更多相关文章
- NMS(Non-Maximum Suppression) 非极大值抑制
NMS 非极大值抑制:找到局部最大值,并删除邻域内其他的值. 简单说一下流程: 首先剔除背景(背景无需NMS),假设有6个边界框,根据分类置信度对这6个边界框做降序排列,假设顺序为A.B.C.D.E ...
- Non-maximum suppression(非极大值抑制算法)
在RCNN系列目标检测中,有一个重要的算法,用于消除一些冗余的bounding box,这就是non-maximum suppression算法. 这里有一篇博客写的挺好的: http://www.c ...
- 非极大值抑制算法(Python实现)
date: 2017-07-21 16:48:02 非极大值抑制算法(Non-maximum suppression, NMS) 算法原理 非极大值抑制算法的本质是搜索局部极大值,抑制非极大值元素. ...
- 非极大值抑制(Non-Maximum Suppression,NMS)
概述 非极大值抑制(Non-Maximum Suppression,NMS),顾名思义就是抑制不是极大值的元素,可以理解为局部最大搜索.这个局部代表的是一个邻域,邻域有两个参数可变,一是邻域的维数,二 ...
- 非极大值抑制Non-Maximum Suppression(NMS)
非极大值抑制(Non-Maximum Suppression,NMS) 概述 非极大值抑制(Non-Maximum Suppression,NMS),顾名思义就是抑制不是极大值的元素,可以理解为局 ...
- Non-Maximum Suppression,NMS非极大值抑制
Non-Maximum Suppression,NMS非极大值抑制概述非极大值抑制(Non-Maximum Suppression,NMS),顾名思义就是抑制不是极大值的元素,可以理解为局部最大搜索. ...
- 目标检测 非极大值抑制(Non-Maximum Suppression,NMS)
非极大值抑制(Non-Maximum Suppression,NMS),顾名思义就是抑制不是极大值的元素,可以理解为局部最大搜索.也可以理解为只取置信度最高的一个识别结果. 举例:  如图所示,现在 ...
- 非极大值抑制(NMS)
转自:https://www.cnblogs.com/makefile/p/nms.html 概述 非极大值抑制(Non-Maximum Suppression,NMS),顾名思义就是抑制不是极大值的 ...
- 非极大值抑制(NMS)的几种实现
因为之前对比了RoI pooling的几种实现,发现python.pytorch的自带工具函数速度确实很慢,所以这里再对Faster-RCNN中另一个速度瓶颈NMS做一个简单对比试验. 这里做了四组对 ...
- 非极大值抑制(NMS)
非极大值抑制顾名思义就是抑制不是极大值的元素,搜索局部的极大值.这个局部代表的是一个邻域,邻域有两个参数可变,一个是邻域的维数,二是邻域的大小.这里不讨论通用的NMS算法,而是用于在目标检测中提取分数 ...
随机推荐
- Mesa: GeoReplicated, Near RealTime, Scalable Data Warehousing
Mesa的定义并没有反映出他的特点,因为分布式,副本,高可用,他都是依赖google的其他基础设施完成的 他最大的特点是,和传统数仓比,可以做到near real-time的返回聚合的查询结果 算入实 ...
- File checksum
File checksum https://golang.org/pkg/io/#Copy https://blog.iphpo.com/blog/2017/03/golang-產生檔案的md5-ha ...
- centos 6.8操作系统安装arcgis server 10.4-后续篇
./Setup //执行安装 (运行安装脚本后会进行安装环境检测,会检查检查软件包和主机名,检测通过才可以开始安装.)如果检查不通过,会提示和报错,并中断安装过程.(1) 解决 hostname 问题 ...
- Javascript / Nodejs call 和 apply
call: 改变了函数运行的作用域,即改变函数里面this的指向apply:同call,apply第二个参数是数组结构 例如: this.name = 'Ab'var obj = {name: 'BB ...
- YII2框架集成go!aop
AOP实践:YII2框架本身拥有一个功能,叫做行为.它可以动态的为当前的类附加额外的功能,但这种功能在代码层级结构是静态的,有侵入性的. 下面以YII2框架集成go!aop库为例,介绍在YII2中如何 ...
- LinkedHashMap原理
作者:艺旭家 链接:https://www.jianshu.com/p/8f4f58b4b8ab 总结 LinkedHashMap是继承于HashMap,是基于HashMap和双向链表来实现的. Ha ...
- socks5 代理服务器ss5配置
安装 yum install pam-devel openldap-devel openssl-devel yum -y install gcc automake make pam-devel ope ...
- Java 文件完整性校验 MD5 sha1 sha256 sha224 sha384 sha512
由于项目中需要使用文件做备份,并且要提供备份文件的下载功能.备份文件体积较大,为确保下载后的文件与原文件一致,需要提供文件完整性校验. 网上有这么多此类文章,其中不少使用到了 org.apache.c ...
- 【C/C++开发】C++11:右值引用和转发型引用
右值引用 为了解决移动语义及完美转发问题,C++11标准引入了右值引用(rvalue reference)这一重要的新概念.右值引用采用T&&这一语法形式,比传统的引用T&(如 ...
- django缓存相关
版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本文链接:https://blog.csdn.net/weixin_39726347/articl ...