
【Hadoop】Hadoop MR 自定义序列化类
1、基本概念
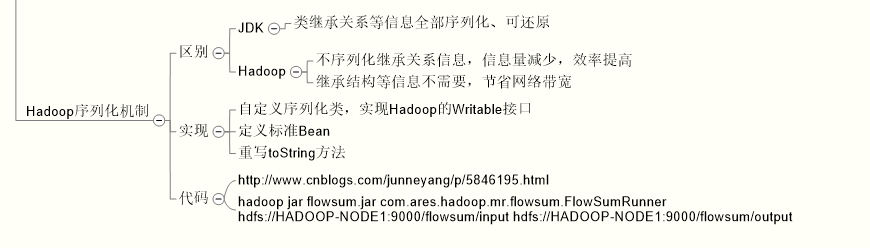
2、Mapper代码
package com.ares.hadoop.mr.flowsum;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.util.StringUtils;

import org.apache.log4j.Logger;

import com.ares.hadoop.mr.wordcount.MRTest;

//Long, String, String, Long --> LongWritable, Text, Text, LongWritable

public class FlowSumMapper extends Mapper<LongWritable, Text, Text, FlowBean> {

    private static final Logger LOGGER = Logger.getLogger(MRTest.class);

    private String line;

    private int length;

    private final static char separator = '\t';

    private String phoneNum;

    private long upFlow;

    private long downFlow;

    //private long sumFlow;

    private Text text = new Text();

    private FlowBean flowBean = new FlowBean();

    @Override

    protected void map(LongWritable key, Text value,

            Mapper<LongWritable, Text, Text, FlowBean>.Context context)

            throws IOException, InterruptedException {

        // TODO Auto-generated method stub

        //super.map(key, value, context);

        line = value.toString();

        String[] fields = StringUtils.split(line, separator);

        length = fields.length;

        if (length != ) {

            LOGGER.error(key.get() + ", " + line + " LENGTH INVALID, IGNORE...");

        }

        phoneNum = fields[];

        try {

            upFlow = Long.parseLong(fields[length-]);

            downFlow = Long.parseLong(fields[length-]);

            //sumFlow = upFlow + downFlow;

        } catch (Exception e) {

            // TODO: handle exception

            LOGGER.error(key.get() + ", " + line + " FLOW DATA INVALID, IGNORE...");

        }

        flowBean.setPhoneNum(phoneNum);

        flowBean.setUpFlow(upFlow);

        flowBean.setDownFlow(downFlow);

        //flowBean.setSumFlow(sumFlow);

        text.set(phoneNum);

        context.write(text, flowBean);

    }

}
3、Reducer代码
package com.ares.hadoop.mr.flowsum;

import java.io.IOException;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

public class FlowSumReducer extends Reducer<Text, FlowBean, Text, FlowBean>{

    //private static final Logger LOGGER = Logger.getLogger(MRTest.class);

    private FlowBean flowBean = new FlowBean();

    @Override

    protected void reduce(Text key, Iterable<FlowBean> values,

            Reducer<Text, FlowBean, Text, FlowBean>.Context context)

            throws IOException, InterruptedException {

        // TODO Auto-generated method stub

        //super.reduce(arg0, arg1, arg2);

        long upFlowCounter = ;

        long downFlowCounter = ;

        for (FlowBean flowBean : values) {

            upFlowCounter += flowBean.getUpFlow();

            downFlowCounter += flowBean.getDownFlow();

        }

        flowBean.setPhoneNum(key.toString());

        flowBean.setUpFlow(upFlowCounter);

        flowBean.setDownFlow(downFlowCounter);

        flowBean.setSumFlow(upFlowCounter + downFlowCounter);

        context.write(key, flowBean);

    }

}
4、序列化Bean代码
package com.ares.hadoop.mr.flowsum;

import java.io.DataInput;

import java.io.DataOutput;

import java.io.IOException;

import org.apache.hadoop.io.Writable;

public class FlowBean implements Writable {

    private String phoneNum;

    private long upFlow;

    private long downFlow;

    private long sumFlow;

    public FlowBean() {

        // TODO Auto-generated constructor stub

    }

//    public FlowBean(String phoneNum, long upFlow, long downFlow, long sumFlow) {

//        super();

//        this.phoneNum = phoneNum;

//        this.upFlow = upFlow;

//        this.downFlow = downFlow;

//        this.sumFlow = sumFlow;

//    }

    public String getPhoneNum() {

        return phoneNum;

    }

    public void setPhoneNum(String phoneNum) {

        this.phoneNum = phoneNum;

    }

    public long getUpFlow() {

        return upFlow;

    }

    public void setUpFlow(long upFlow) {

        this.upFlow = upFlow;

    }

    public long getDownFlow() {

        return downFlow;

    }

    public void setDownFlow(long downFlow) {

        this.downFlow = downFlow;

    }

    public long getSumFlow() {

        return sumFlow;

    }

    public void setSumFlow(long sumFlow) {

        this.sumFlow = sumFlow;

    }

    @Override

    public void readFields(DataInput in) throws IOException {

        // TODO Auto-generated method stub

        phoneNum = in.readUTF();

        upFlow = in.readLong();

        downFlow = in.readLong();

        sumFlow = in.readLong();

    }

    @Override

    public void write(DataOutput out) throws IOException {

        // TODO Auto-generated method stub

        out.writeUTF(phoneNum);

        out.writeLong(upFlow);

        out.writeLong(downFlow);

        out.writeLong(sumFlow);

    }

    @Override

    public String toString() {

        return "" + upFlow + "\t" + downFlow + "\t" + sumFlow;

    }

}
5、TestRunner代码
package com.ares.hadoop.mr.flowsum;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

import org.apache.log4j.Logger;

public class FlowSumRunner extends Configured implements Tool {

    private static final Logger LOGGER = Logger.getLogger(FlowSumRunner.class);

    @Override

    public int run(String[] args) throws Exception {

        // TODO Auto-generated method stub

        LOGGER.debug("MRTest: MRTest STARTED...");

        if (args.length != ) {

            LOGGER.error("MRTest: ARGUMENTS ERROR");

            System.exit(-);

        }

        Configuration conf = new Configuration();

        //FOR Eclipse JVM Debug

        //conf.set("mapreduce.job.jar", "flowsum.jar");

        Job job = Job.getInstance(conf);

        // JOB NAME

        job.setJobName("flowsum");

        // JOB MAPPER & REDUCER

        job.setJarByClass(FlowSumRunner.class);

        job.setMapperClass(FlowSumMapper.class);

        job.setReducerClass(FlowSumReducer.class);

        // MAP & REDUCE

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(FlowBean.class);

        // MAP

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(FlowBean.class);

        // JOB INPUT & OUTPUT PATH

        //FileInputFormat.addInputPath(job, new Path(args[0]));

        FileInputFormat.setInputPaths(job, args[]);

        FileOutputFormat.setOutputPath(job, new Path(args[]));

        // VERBOSE OUTPUT

        if (job.waitForCompletion(true)) {

            LOGGER.debug("MRTest: MRTest SUCCESSFULLY...");

            return ;

        } else {

            LOGGER.debug("MRTest: MRTest FAILED...");

            return ;

        }

    }

    public static void main(String[] args) throws Exception {

        int result = ToolRunner.run(new Configuration(), new FlowSumRunner(), args);

        System.exit(result);

    }

}
参考资料:
http://www.cnblogs.com/robert-blue/p/4157768.html
http://www.cnblogs.com/qlee/archive/2011/05/18/2049610.html
http://blog.163.com/lzm07@126/blog/static/25705468201331611857190/
http://blog.csdn.net/lastsweetop/article/details/9193907
【Hadoop】Hadoop MR 自定义序列化类的更多相关文章
- Hadoop【MR开发规范、序列化】
Hadoop[MR开发规范.序列化] 目录 Hadoop[MR开发规范.序列化] 一.MapReduce编程规范 1.Mapper阶段 2.Reducer阶段 3.Driver阶段 二.WordCou ...
- hadoop提交作业自定义排序和分组
现有数据如下: 3 3 3 2 3 1 2 2 2 1 1 1 要求为: 先按第一列从小到大排序,如果第一列相同,按第二列从小到大排序 如果是hadoop默认的排序方式,只能比较key,也就是第一列, ...
- hadoop深入研究:(十三)——序列化框架
hadoop深入研究:(十三)--序列化框架 Mapreduce之序列化框架(转自http://blog.csdn.net/lastsweetop/article/details/9376495) 框 ...
- 在hadoop作业中自定义分区和归约
当遇到有特殊的业务需求时,需要对hadoop的作业进行分区处理 那么我们可以通过自定义的分区类来实现 还是通过单词计数的例子,JMapper和JReducer的代码不变,只是在JSubmit中改变了设 ...
- 【Hadoop】MapReduce自定义分区Partition输出各运营商的手机号码
MapReduce和自定义Partition MobileDriver主类 package Partition; import org.apache.hadoop.io.NullWritable; i ...
- 为什么hadoop中用到的序列化不是java的serilaziable接口去序列化而是使用Writable序列化框架
继上一个模块之后,此次分析的内容是来到了Hadoop IO相关的模块了,IO系统的模块可谓是一个比较大的模块,在Hadoop Common中的io,主要包括2个大的子模块构成,1个是以Writable ...
- Hadoop【MR的分区、排序、分组】
[toc] 一.分区 问题:按照条件将结果输出到不同文件中 自定义分区步骤 1.自定义继承Partitioner类,重写getPartition()方法 2.在job驱动Driver中设置自定义的Pa ...
- hadoop修改MR的提交的代码程序的副本数
hadoop修改MR的提交的代码程序的副本数 Under-Replicated Blocks的数量很多,有7万多个.hadoop fsck -blocks 检查发现有很多replica missing ...
- Hadoop streaming使用自定义python版本和第三方库
在使用Hadoop的过程中,遇到了自带python版本比较老的问题. 下面以python3.7为例,演示如何在hadoop上使用自定义的python版本以及第三方库. 1.在https://www.p ...
随机推荐
- http登陆时的密码加密
系统设计登陆页面的时候,需要谨慎.因为登陆数据是在网络上进行传输,很可能中途被拦截. 最好的登陆是使用https,这样网络传输是安全的.google,baidu,alibaba都使用https的方式. ...
- 部分浏览器上a标签包裹的dom元素显示不正常
在苹果和部分安卓机上出现,pc端和chrome浏览器响应式设计里怎么样也不会出现的访问后a标签包裹的dom元素显示不正常a标签内的hr元素颜色显示不正常hr水平线的颜色被 bootstrap的css的 ...
- 行为型设计模式之中介者模式(Mediator)
结构 意图 用一个中介对象来封装一系列的对象交互.中介者使各对象不需要显式地相互引用,从而使其耦合松散,而且可以独立地改变它们之间的交互. 适用性 一组对象以定义良好但是复杂的方式进行通信.产生的相互 ...
- [bzoj2111][ZJOI2010]Perm 排列计数 ——问题转换,建立数学模型
题目大意 称一个1,2,...,N的排列P1,P2...,Pn是Magic的,当且仅当2<=i<=N时,Pi>Pi/2. 计算1,2,...N的排列中有多少是Magic的,答案可能很 ...
- cocos2d-iphone 与 UI组件
http://zhidao.baidu.com/link?url=v9d7y2doWqcPhKz1lz8TkO7ZQfslg-e-55JE0XP9VdKJ0vHobcLPEAXaXjD2lD-TGmg ...
- c/c++相关面试准备笔记1
在c++程序中调用被C编译器编译后的函数,为什么要加extern “C”? C++语言支持函数重载,C语言不支持函数重载.函数被C++编译后在库中的名字与C语言的不同.C++提供了C连接交换指定符号 ...
- postman的使用(转载)
Postman介绍 Postman是google开发的一款功能强大的网页调试与发送网页HTTP请求,并能运行测试用例的的Chrome插件.其主要功能包括: 模拟各种HTTP requests 从常用的 ...
- PSR-1 基础编码规范
本篇规范制定了代码基本元素的相关标准, 以确保共享的PHP代码间具有较高程度的技术互通性. 关键词 “必须”("MUST").“一定不可/一定不能”("MUST NOT& ...
- 网盘+SVN
1.安装网盘 选择一个国内有名的网盘存储,例如金山网盘.360云盘等,注册账户会默认赠送几G的使用空间,然后下载其对应的网盘客户端管理软件(也可以使用浏览器方式),使用账号登录,就可以上传.管理文件等 ...
- J.U.C并发框架源码阅读(十六)FutureTask
基于版本jdk1.7.0_80 java.util.concurrent.FutureTask 代码如下 /* * ORACLE PROPRIETARY/CONFIDENTIAL. Use is su ...