
python爬虫入门(1)-urllib模块
- url:需要打开的网址
- data:Post提交的数据
- timeout:设置网站的访问超时时间
    import urllib.request

    response = urllib.request.urlopen("http://www.fishc.com")#是一个HTTP响应类型

    html =response.read()#读取响应内容,为bytes类型

    # print(type(html),html) #输出的为一串<class 'bytes'>

    html = html.decode('utf-8')#bytes类型解码为str类型

    print(html)
import urllib.request

response = urllib.request.urlopen("http://placekitten.com/g/400/400")

cat_img = response.read()

with open('cat_400_400.jpg','wb')as f:

  f.write(cat_img)
import urllib.request

import urllib.parse

import json

import time

while True:

    content = input("请输入需要翻译的内容《输入q!退出程序》:")

    if content == 'q!':

        break

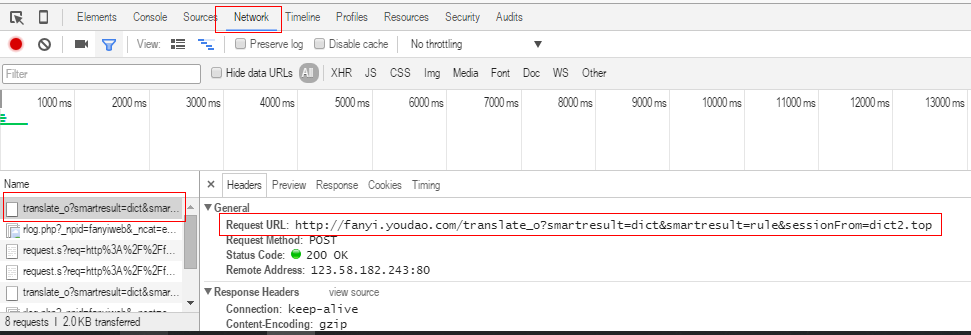
    url = "http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule&smartresult=ugc&sessionFrom=http://www.youdao.com/"    #即RequestURL中的链接

    data = {}

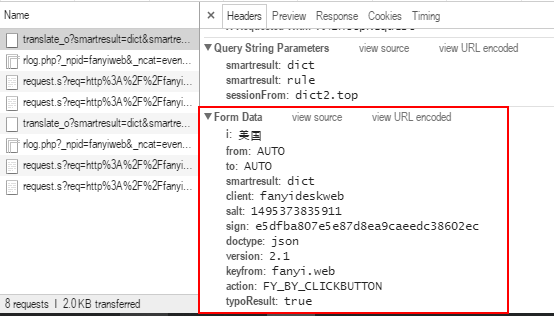
    #Form Data中的内容,适当删除无用信息

    data['i'] = content

    data['smartresult'] = 'dict'

    data['client'] = 'fanyideskweb'

    data['doctype'] = 'json'

    data['version'] = '2.1'

    data['keyfrom'] = 'fanyi.web'

    data['action'] = 'FY_BY_CLICKBUTTON'

    data['typoResult'] = 'true'

    data = urllib.parse.urlencode(data).encode('utf-8')

    #打开网址并提交表单

    response = urllib.request.urlopen(url, data)

    html = response.read().decode('utf-8')

    target = json.loads(html)

    print("翻译结果:%s" % (target['translateResult'][0][0]['tgt']))

    time.sleep(2)
    import urllib.request

    import random

    url ='http://www.whatismyip.com.tw/'

    iplist =['61.191.41.130:80','115.46.97.122:8123',]

    #参数是一个字典{'类型':'代理IP:端口号'}

    proxy_support = urllib.request.ProxyHandler({'http':random.choice(iplist)})

    #定制、创建一个opener

    opener = urllib.request.build_opener(proxy_support)

    #通过addheaders修改User-Agent

    opener.addheaders =[('User-Agent','Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/48.0.2564.97 Safari/537.36')]

    #安装opener

    urllib.request.install_opener(opener)

    response = urllib.request.urlopen(url)

    html = response.read().decode('utf-8')

    print(html)
    import urllib.request

    import re

    def open_url(url):

        #打开URL并修改header,将URL内容读取

        req = urllib.request.Request(url)

        #通过add_header修改User-Agent

        req.add_header('User-Agent','Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/48.0.2564.97 Safari/537.36')

        page = urllib.request.urlopen(req)

        html = page.read().decode('utf-8')

        return html

    def get_img(html):

        p = r'<img class="BDE_Image" src="([^"]+\.jpg)'

        imglist = re.findall(p,html)#寻找到图片的链接

        for each in imglist:

          filename = each.split("/")[-1]

          urllib.request.urlretrieve(each,filename,None)#保存图片


  if __name__ =='__main__':

        url ="https://tieba.baidu.com/p/5090206152"

        get_img(open_url(url))
python爬虫入门(1)-urllib模块的更多相关文章
- Python爬虫入门之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- Python爬虫入门之Urllib库的基本使用
那么接下来,小伙伴们就一起和我真正迈向我们的爬虫之路吧. 1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解 ...
- Python爬虫入门:Urllib库的高级使用
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- Python爬虫入门:Urllib库的基本使用
1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解释才呈现出来的,实质它 是一段HTML代码,加 JS.CS ...
- 芝麻HTTP:Python爬虫入门之Urllib库的基本使用
1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解释才呈现出来的,实质它是一段HTML代码,加 JS.CSS ...
- 芝麻HTTP: Python爬虫入门之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- Python爬虫入门:Urllib parse库使用详解(二)
文字转载:https://www.jianshu.com/p/e4a9e64082ef,转载内容仅供学习 如有侵权,请联系删除 获取url参数 urlparse 和 parse_qs ParseRes ...
- 3.Python爬虫入门三之Urllib和Urllib2库的基本使用
1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解释才呈现出来的,实质它是一段HTML代码,加 JS.CSS ...
- Python爬虫入门四之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- 转 Python爬虫入门四之Urllib库的高级用法
静觅 » Python爬虫入门四之Urllib库的高级用法 1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我 ...
随机推荐
- 解决IE6已终止操作问题
令人崩溃的IE6问题再次出现,打开某个页面时,弹出提示框“Internet Explorer无法打开Internet 站点...已终止操作”. 查了一下资料,感觉“因为js(一个比较复杂的js) ...
- RedHat7.4最小化安装yum源不可用问题解决
本次安装的RedHat7.4是安装在Oracle VM VirtualBox5.2.8虚拟机上面的,本文不对安装虚拟机步骤做详细说明. 工具准备: Oracle VM VirtualBox5.2.8 ...
- 正则表达式-RegExp-常用正则表达式
正则表达式-RegExp-常用正则表达式 作者:nuysoft/JS攻城师/高云 QQ:47214707 EMail:nuysoft@gmail.com 声明:本文为原创文章,如需转载,请注明来源 ...
- 【eclipse】Multiple annotations found at this line:——解决方法
问题截图: 就是eclipse的maven插件太旧了 用新插件新建的maven项目就没有报错 用软件对比了一下这两个pom文件 只有项目名有区别 所以就是插件的问题 一个简单安装离线maven插件的方 ...
- Asp.Net Core 2.0 WebUploader FastDfs 文件上传 分段上传
功能点: 1. 使用.net core 2.0 实现文件上传 2. 使用webuploader实现单文件,多文件上传 3. 使用webuploader实现大文件的分段上传. 4. 使用webuploa ...
- 通俗易懂讲解IO模型
前言 说到IO模型,都会牵扯到同步.异步.阻塞.非阻塞这几个词.从词的表面上看,很多人都觉得很容易理解.但是细细一想,却总会发现有点摸不着头脑.自己也曾被这几个词弄的迷迷糊糊的,每次看相关资料弄明白了 ...
- input输入框延时发送请求问题
同样是面试遇到的问题,input输入框,怎么减少发送请求次数. 键盘抬起触发事件,首先清除定时器,再开启定时器.只要小于1s的连续输入,都会先把上一次定时器清除.停顿一秒后,开始执行请求事件(此处为c ...
- enabled和priority属性
本篇来继续学习@Test下的注释,这篇学习两个属性的基本使用.第一个是设置该条用例不被执行,第二个的作用是设置用例执行的优先顺序. 1. 属性enabled 在Testng中,如果方法前面添加了@Te ...
- C5 标准IO库:APUE 笔记
C5 :标准IO库 在第三章中,所有IO函数都是围绕文件描述符展开,文件描述符用于后续IO操作.由于文件描述符相关的操作是不带缓冲的IO,需要操作者本人指定缓冲区分配.IO长度等,对设备环境要求一定的 ...
- JAVA8新特性简单总结
速度更快代码更少强大的StreamAPI便于并行最大化的减少空指针异常Lambda表达式<具体做什么事>和函数式接口Lambda表达式(也叫做闭包)它允许我们将一个函数当作方法的参数(传递 ...