
【Python】理想论坛每小时发帖量统计图表
写以下代码的目的是分析一天中各时段理想论坛中用户发帖回帖的活跃程度,获得结尾那张图表是核心。
以下代码两种爬虫协助,论坛爬虫先爬主贴,爬到主贴后启动帖子爬虫爬子贴,然后把每个子贴的发表时间等存入数据库。
再用一个程序对各个时段中发帖次数进行统计,然后用Excel生产图表。
获取数据的爬虫代码如下:
# 论坛爬虫,用于爬取主贴再爬子贴
from bs4 import BeautifulSoup
import requests
import threading
import re
import pymysql

user_agent='Mozilla/4.0 (compatible;MEIE 5.5;windows NT)'
headers={'User-Agent':user_agent}

# 论坛爬虫类(多线程)
class forumCrawler(threading.Thread):
    def __init__(self,name,url):
        threading.Thread.__init__(self,name=name)
        self.name=name
        self.url=url
        self.infos=[]

    def run(self):
        print("线程"+self.name+"开始爬取页面"+self.url);

        try:
            rsp=requests.get(self.url,headers=headers)
            soup= BeautifulSoup(rsp.text,'html.parser',from_encoding='utf-8')
            #print(rsp.text); # rsp.text是全文

            # 找出span
            for spans in soup.find_all('span',class_="forumdisplay"):
                #找出link
                for link in spans.find_all('a'):
                    if link and link.get("href"):
                        #print(link.get("href"))
                        #print(link.text+'\n')
                        topicLink="http://www.55188.com/"+link.get("href")

                        tc=topicCrawler(name=self.name+'_tc#'+link.get("href"),url=topicLink)
                        tc.start()

        except Exception as e:
            print("线程"+self.name+"发生异常。")# 不管怎么出现的异常,就让它一直爬到底
            print(e);

# 帖子爬虫类(多线程)
class topicCrawler(threading.Thread):
    def __init__(self,name,url):
        threading.Thread.__init__(self,name=name)
        self.name=name
        self.url=url
        self.infos=[]

    def run(self):
        while(self.url!="none"):
            print("线程"+self.name+"开始爬取页面"+self.url);

            try:
                rsp=requests.get(self.url,headers=headers)
                self.url="none"#用完之后置空,看下一页能否取到值
                soup= BeautifulSoup(rsp.text,'html.parser',from_encoding='utf-8')
                #print(rsp.text); # rsp.text是全文

                # 找出一页里每条发言
                for divs in soup.find_all('div',class_="postinfo"):
                    #print(divs.text) # divs.text包含作者和发帖时间的文字

                    # 用正则表达式将多个空白字符替换成一个空格
                    RE = re.compile(r'(\s+)')
                    line=RE.sub(" ",divs.text)

                    arr=line.split(' ')

                    #print(len(arr))
                    arrLength=len(arr)

                    if arrLength==7:
                        info={'楼层':arr[1],
                              '作者':arr[2].replace('只看:',''),
                              '日期':arr[4],
                              '时间':arr[5]}
                        self.infos.append(info);
                    elif arrLength==8:
                        info={'楼层':arr[1],
                              '作者':arr[2].replace('只看:',''),
                              '日期':arr[5],
                              '时间':arr[6]}
                        self.infos.append(info);

                #找下一页所在地址
                for pagesDiv in soup.find_all('div',class_="pages"):
                    for strong in pagesDiv.find_all('strong'):
                        print('当前为第'+strong.text+'页')

                        # 找右边的兄弟节点
                        nextNode=strong.next_sibling
                        if nextNode and nextNode.get("href"): # 右边的兄弟节点存在,且其有href属性
                            #print(nextNode.get("href"))
                            self.url='http://www.55188.com/'+nextNode.get("href")

                if self.url!="none":
                    print("有下一页,线程"+self.name+"前往下一页")
                    continue
                else:
                    print("无下一页,线程"+self.name+'爬取结束,开始打印...')

                    for info in self.infos:
                        print('\n')
                        for key in info:
                            print(key+":"+info[key])

                    print("线程"+self.name+'打印结束.')

                    insertDB(self.name,self.infos)

            except Exception as e:
                print("线程"+self.name+"发生异常。重新爬行")# 不管怎么出现的异常,就让它一直爬到底
                print(e);
                continue

# 数据库插值
def insertDB(crawlName,infos):
    conn=pymysql.connect(host=',db='test',charset='utf8')

    for info in infos:
        sql="insert into test.topic(floor,author,tdate,ttime,crawlername,addtime) values ('"+info['楼层']+"','"+info['作者']+"','"+info['日期']+"','"+info['时间']+"','"+crawlName+"',now() )"
        print(sql)
        conn.query(sql)

    conn.commit()# 写操作之后commit不可少
    conn.close()

# 入口函数
def main():
    for i in range(1,10):
        url='http://www.55188.com/forum-8-'+str(i)+'.html'
        tc=forumCrawler(name='fc#'+str(i),url=url)
        tc.start()

# 开始
main()
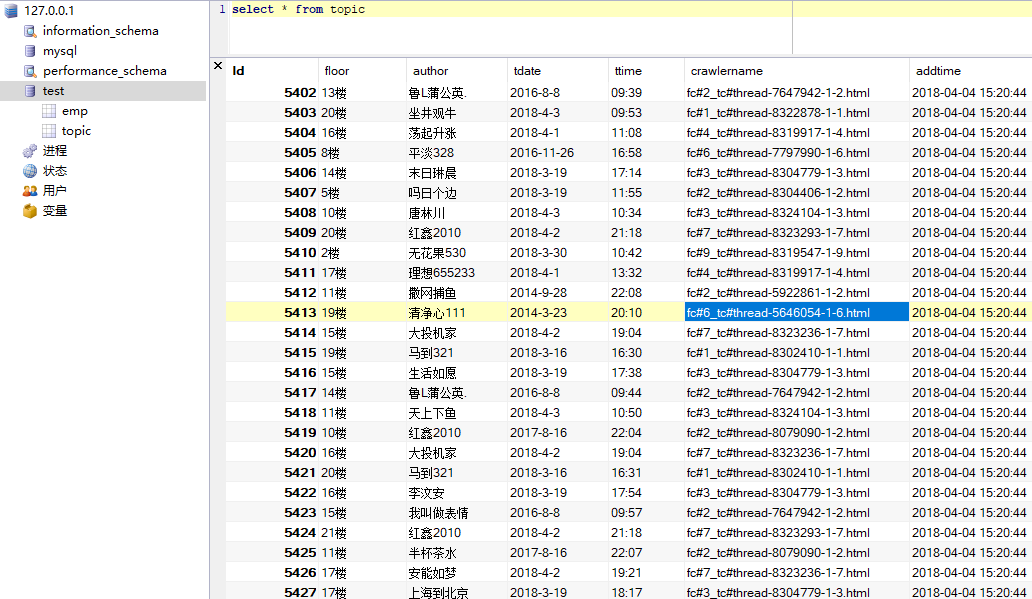
控制台输出太多就不贴了,把插入数据后的数据库展示一下,ttime字段就是想要获得的关键数据:
再做一个小程序对发帖时间进行统计,代码如下:
# 对发帖时间进行统计
import pymysql

# 入口函数
def main():
    dic={':0}

    conn=pymysql.connect(host=',db='test',charset='utf8')

    cs=conn.cursor()
    cs.execute("select * from topic")
    results = cs.fetchall()

    for row in results:
        ttime=row[4]
        hour=ttime.split(':')[0]
        dic[hour]=dic[hour]+1

    conn.close()

    print(dic)
# 开始
main()
输出字典如下:
C:\Users\horn1\Desktop\python\17>python sum.py
{': 388}
用Excel来个图形化看看:
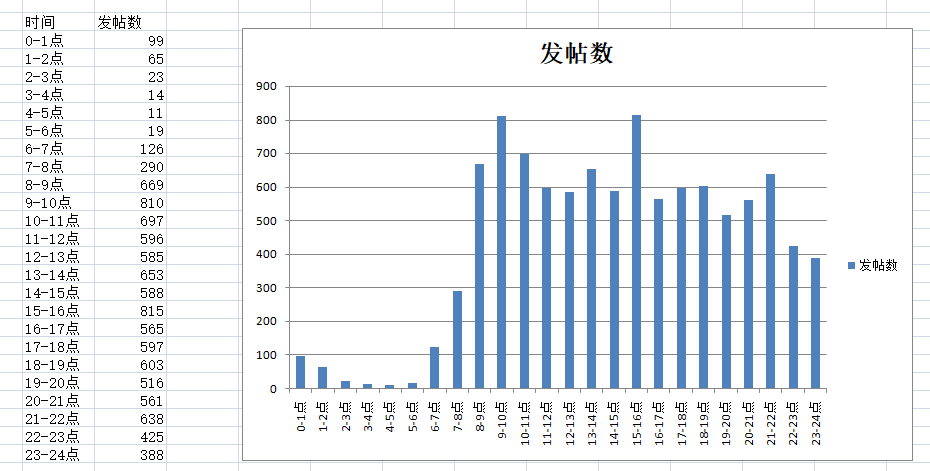
从上图可以得出以下结论:
1.早上0点-6点是交易者最闲的时候,他们大部分都在睡觉,3-5点睡得最熟。
2.发帖峰值一个是在9-10点,一个是15-16点。股市在9:30开盘,低开高开也出来了,行情也走了一段,大家开始热情高涨了发帖,之后就逐步回落,午休落入低谷,下午15点收盘后,大家又争相发表对这天行情的看法,但能一天走势能谈多少,于是一个小时就消停了。另外15-16点也是股评家发表股评的黄金时段。
3.入夜了,虽然早已收盘,大家依旧在浏览论坛,希望从帖子里发现什么或者讨论什么,直到23-24点还有不少人从事这项活动。
呵呵,我也玩票了一把数据分析。
2018年4月4日16点14分
【Python】理想论坛每小时发帖量统计图表的更多相关文章
- 【ichartjs】爬取理想论坛前30页帖子获得每个子贴的发帖时间,总计83767条数据进行统计,生成统计图表
统计数据如下: {': 2451} 图形化后效果如下: 源码: <!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01 Transitional//E ...
- 【pyhon】理想论坛爬虫1.08
#------------------------------------------------------------------------------------ # 理想论坛爬虫1.08,用 ...
- 【Python】爬取理想论坛单帖爬虫
代码: # 单帖爬虫,用于爬取理想论坛帖子得到发帖人,发帖时间和回帖时间,url例子见main函数 from bs4 import BeautifulSoup import requests impo ...
- 【python】理想论坛爬虫长贴版1.00
理想论坛有些长贴,针对这些长贴做统计可以知道某ID什么时段更活跃. 爬虫代码为: #---------------------------------------------------------- ...
- 【python】理想论坛爬虫1.08
#------------------------------------------------------------------------------------ # 理想论坛爬虫1.08, ...
- 【python】理想论坛帖子爬虫1.06
昨天认识到在本期同时起一百个回调/线程后程序会崩溃,造成结果不可信. 于是决定用Python单线程操作,因为它理论上就用主线程跑不会有问题,只是时间长点. 写好程序后,测试了一中午,210个主贴,11 ...
- 【Python】理想论坛帖子读取爬虫1.04版
1.01-1.03版本都有多线程争抢DB的问题,线程数一多问题就严重了. 这个版本把各线程要添加数据的SQL放到数组里,等最后一次性完成,这样就好些了.但乱码问题和未全部完成即退出现象还在,而且速度上 ...
- 【Python】分析自己的博客 https://www.cnblogs.com/xiandedanteng/p/?page=XX,看每个月发帖量是多少
要执行下面程序,需要安装Beautiful Soup和requests,具体安装方法请见:https://www.cnblogs.com/xiandedanteng/p/8668492.html # ...
- 【Nodejs】理想论坛帖子爬虫1.01
用Nodejs把Python实现过的理想论坛爬虫又实现了一遍,但是怎么判断所有回调函数都结束没有好办法,目前的spiderCount==spiderFinished判断法在多页情况下还是会提前中止. ...
随机推荐
- [I/O]javaI/O工作机制
摘要:IO问题可以说是当今web应用中面临的主要问题之一.因为在这个数据爆发的时代,海量的数据在网络到处流动,而在这个过程中都会涉及IO问题,可以说IO问题已经成为web应用的瓶颈之一.如何优化?以此 ...
- python中if和elif的区别
多个if语句是每次单独判断 比如: 例子一: a = 5 if a < 6: #条件1 print(1) if a < 7: #条件2 print(2) else: print(3) 条件 ...
- linux——(7)了解shell
概念一:什么是shell 用户用来和内核交互的东西,他相当一个接口,我们通过这个接口调用别的程序,然后他调用内核来帮我们完成程序功能.shell有很多种类,他们之间有部分区别,Linux默认使用bas ...
- linux——(4)磁盘与文件系统管理
概念一:linux-ext2文件系统 ext2在分区的时候会分成多个组块(block group)和一个启动扇区(boot sector),每一个组块内又有superblock.File system ...
- 不愿看到Java开发者再做的10件事
William F. Buckley.Jr 曾经说过,“保守主义者是那些逆着历史潮流不断喊停的人,其他人都不愿意这么做或者对他们这么做显得没有耐性”.虽然我对此了解不多,但是每次看到有Java开发人员 ...
- nyoj 737 石子合并 http://blog.csdn.net/wangdan11111/article/details/45032519
http://blog.csdn.net/wangdan11111/article/details/45032519 http://acm.nyist.net/JudgeOnline/problem. ...
- 初学Hadoop:利用VMWare+CentOS7搭建Hadoop集群
一.前言 开始学习数据处理相关的知识了,第一步是搭建一个Hadoop集群.搭建一个分布式集群需要多台电脑,在此我选择采用VMWare+CentOS7搭建一个三台虚拟机组成的Hadoop集群. 注:1 ...
- bzoj 2434 ac自动机
ac自动机中,如果以trie中的节点为节点,(fail[i],i)为边,可以建立一颗树,该树有如下特点:“节点u是节点v的祖先 当且仅当 u代表的字符串是v代表的字符串的一个后缀”.(u代表的字符串是 ...
- bzoj 3223 文艺平衡树 Splay 打标志
是NOI2003Editor的一个子任务 #include <cstdio> #include <vector> #define maxn 100010 using names ...
- Linux知识(5)----LINUX下GDB调试
命令 解释 示例 file 加载被调试的可执行程序文件.因为一般都在被调试程序所在目录下执行GDB,因而文本名不需要带路径. (gdb) file gdb-sample r c Run的简 ...