
Flink读写Redis(一)-写入Redis
项目pom文件
<project xmlns="http://maven.apache.org/POM/4.0.0"

         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <groupId>com.jike.flink</groupId>

    <artifactId>flink-demo</artifactId>

    <version>1.0-SNAPSHOT</version>

    <properties>

        <maven.compiler.source>1.8</maven.compiler.source>

        <maven.compiler.target>1.8</maven.compiler.target>

        <encoding>UTF-8</encoding>

        <flink.version>1.10.0</flink.version>

    </properties>

    <dependencies>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-java</artifactId>

            <version>${flink.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-streaming-java_2.11</artifactId>

            <version>${flink.version}</version>

            <scope>provided</scope>

        </dependency>

        <!-- flink 11中需要手动添加

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-clients_2.11</artifactId>

            <version>1.11.2</version>

        </dependency>

        -->

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-connector-redis_2.11</artifactId>

            <version>1.1.5</version>

            <scope>system</scope>

            <systemPath>${basedir}/lib/flink-connector-redis_2.11-1.1.5.jar</systemPath>

        </dependency>

        <dependency>

            <groupId>redis.clients</groupId>

            <artifactId>jedis</artifactId>

            <version>2.8.0</version>

            <scope>compile</scope>

        </dependency>

    </dependencies>

</project>
实现flink写入redis
实现wordcount功能,并将结果实时写入redis,这里使用了第三方依赖flink-connector-redis_2.11,该依赖提供了RedisSink可以直接使用,具体代码如下:
代码
首先定义数据源处理实现类LineSplitter,该类将一行数据分词,输出<单词,1>元祖
package com.jike.flink.examples.redis;

import org.apache.flink.api.common.functions.FlatMapFunction;

import org.apache.flink.api.java.tuple.Tuple2;

import org.apache.flink.util.Collector;

public class LineSplitter implements FlatMapFunction<String, Tuple2<String,Integer>> {

    public void flatMap(String s, Collector<Tuple2<String, Integer>> collector) throws Exception {

        String[] tokens = s.toLowerCase().split("\\W+");

        for(String token : tokens){

            if(token.length() > 0){

                collector.collect(new Tuple2<String,Integer>(token,1));

            }

        }

    }

}
然后定义数据写入Redis的配置类,这里面将统计后的所有信息词频写入一个哈希表,哈希表的key为"flink",作为测试使用,哈希表中每个元素key为单词,value为词频
package com.jike.flink.examples.redis;

import org.apache.flink.api.java.tuple.Tuple2;

import org.apache.flink.streaming.connectors.redis.common.mapper.RedisCommand;

import org.apache.flink.streaming.connectors.redis.common.mapper.RedisCommandDescription;

import org.apache.flink.streaming.connectors.redis.common.mapper.RedisMapper;

public class SinkRedisMapper implements RedisMapper<Tuple2<String,Integer>> {

    @Override

    public RedisCommandDescription getCommandDescription() {

        //hset

        return new RedisCommandDescription(RedisCommand.HSET,"flink");

    }

    @Override

    public String getKeyFromData(Tuple2<String, Integer> stringIntegerTuple2) {

        return stringIntegerTuple2.f0;

    }

    @Override

    public String getValueFromData(Tuple2<String, Integer> stringIntegerTuple2) {

        return stringIntegerTuple2.f1.toString();

    }

}
最后编写主程序类,该类中使用了socketTextStream数据源,通过前面定义LineSplitter完成解析,然后根据单词进行分组统计,最后写入redis
package com.jike.flink.examples.redis;

import org.apache.flink.api.java.functions.KeySelector;

import org.apache.flink.api.java.tuple.Tuple2;

import org.apache.flink.streaming.api.datastream.DataStream;

import org.apache.flink.streaming.api.datastream.DataStreamSource;

import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

import org.apache.flink.streaming.connectors.redis.RedisSink;

import org.apache.flink.streaming.connectors.redis.common.config.FlinkJedisPoolConfig;

public class Sink2Redis {

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment executionEnvironment = StreamExecutionEnvironment.getExecutionEnvironment();

        DataStreamSource<String> dataStreamSource = executionEnvironment.socketTextStream("实际IP",12345);

        DataStream<Tuple2<String,Integer>> counts = dataStreamSource.flatMap(new LineSplitter()).keyBy(new KeySelector<Tuple2<String, Integer>, String>() {

            public String getKey(Tuple2<String, Integer> stringIntegerTuple2) throws Exception {

                return stringIntegerTuple2.f0;

            }

        }).sum(1);

         //控制台打印

        counts.print().setParallelism(1);

        //定义redis服务器信息

        FlinkJedisPoolConfig conf = new FlinkJedisPoolConfig.Builder().setHost("redis服务器ip").setPort(redis服务端口).setPassword("redis服务密码").build();

        counts.addSink(new RedisSink<>(conf,new SinkRedisMapper()));

        executionEnvironment.execute();

    }

}
运行效果
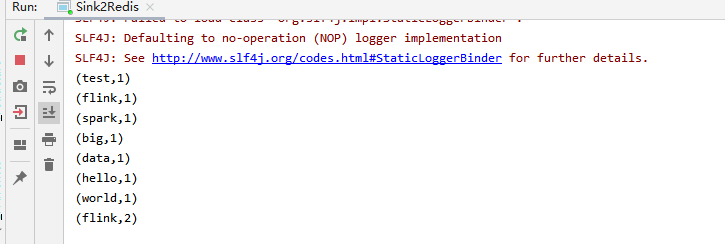
通过nc -l 12345,命令模拟数据源,并输入一些数据

IDEA中查看打印记录
查看redis
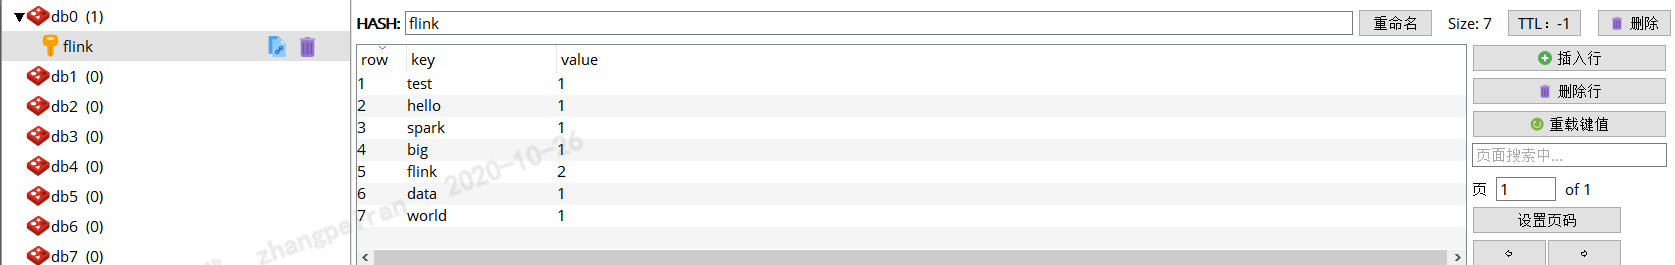
可以发现数据已写入redis
总结
flink-connector-redis_2.11中提供了RedisSink类,该类实现了RichSinkFunction,可以直接使用,如果有特殊需求,可以自定义Sink类,继承RichSinkFunction,实现特殊处理。flink-connector-redis_2.11的源码比较简洁,下一篇打算分析学习下。
Flink读写Redis(一)-写入Redis的更多相关文章
- Flink读写Redis(三)-读取redis数据
自定义flink的RedisSource,实现从redis中读取数据,这里借鉴了flink-connector-redis_2.11的实现逻辑,实现对redis读取的逻辑封装,flink-connec ...
- Flink读写Redis(二)-flink-redis-connector代码学习
源码结构 RedisSink package org.apache.flink.streaming.connectors.redis; import org.apache.flink.configur ...
- Redis学习笔记~Redis主从服务器,读写分离
回到目录 Redis这个Nosql的存储系统一般会被部署到linux系统中,我们可以把它当成是一个数据服务器,对于并发理大时,我们会使用多台服务器充当Redis服务器,这时,各个Redis之间也是分布 ...
- redis作为缓存场景使用,内存耗尽时,突然出现大量的逐出,在这个逐出的过程中阻塞正常的读写请求,导致 redis 短时间不可用
redis 突然大量逐出导致读写请求block 内容目录: 现象 背景 原因 解决方案 ref 现象 redis作为缓存场景使用,内存耗尽时,突然出现大量的逐出,在这个逐出的过程中阻塞正常的读写请 ...
- flink04 -----1 kafkaSource 2. kafkaSource的偏移量的存储位置 3 将kafka中的数据写入redis中去 4 将kafka中的数据写入mysql中去
1. kafkaSource 见官方文档 2. kafkaSource的偏移量的存储位置 默认存在kafka的特殊topic中,但也可以设置参数让其不存在kafka的特殊topic中 3 将k ...
- 批量写入redis
批量写入redis key := GetSeriesKey(series.Id) idNames = append(idNames, key, series.Name) == { err = Mset ...
- ELKStack入门篇(三)之logstash收集日志写入redis
1.部署Redis 1.1.下载redis [root@linux-node2 ~]# wget http://download.redis.io/releases/redis-4.0.6.tar.g ...
- ELK之logstash收集日志写入redis及读取redis
logstash->redis->logstash->elasticsearch 1.安装部署redis cd /usr/local/src wget http://download ...
- Redis原子性写入HASH结构数据并设置过期时间
Redis中提供了原子性命令SETEX或SET来写入STRING类型数据并设置Key的过期时间: > SET key value EX NX ok > SETEX key value ok ...
随机推荐
- 如何将IDM中的进程设置进行备份
有时候我们想用浏览器自带的下载管理器进行下载,但是一点下载却被IDM(Internet Download Manager)自动嗅探捕获并下载,还有人因为重装系统使得之前更改IDM的设置都失效,只得重新 ...
- python3时间函数
上一篇是生成测试报告的代码,如果重复运行测试报告名称相同会不停的覆盖,之前的测试报告也会丢失,无法追溯之前的问题.那么如何解决这个问题了呢? 首先想到的是用随机函数取随机名称,一旦生成的报告较多时,无 ...
- C Looooops POJ - 2115
数论好题.. 香! 首先我们看到这一题, 题意是 \[a + c * x \equiv b (mod \ \ 2 ^ k) \] 对此式移一下项, 得 \[c * x \equiv b - a (mo ...
- 【ACwing 93】【模版】非递归实现组合型枚举——模拟递归
(题面来自ACwing) 从 1~n 这 n 个整数中随机选出 m 个,输出所有可能的选择方案. 输入格式 两个整数 n,m ,在同一行用空格隔开. 输出格式 按照从小到大的顺序输出所有方案,每行1个 ...
- Java基础教程——解析注解
解析注解 Java 5开始,java.lang.reflect包下的反射API可以在运行时读取Annotation. 应用:定义一个自动执行方法的注解,解析注解.通过反射执行方法,替代配置文件. pa ...
- 2020.11.26 IntellJ idea激活码失效解决方法(最新idea激活码及安装参数!)
今天是2020年11月26号,小伙伴们是不是有发现自己的idea激活码失效了,不瞒大家,小编也是一个JAVA开发者,到了公司打开idea,然后就发现事情不妙,经过1个多小时的摸索,终于把最近的安装参数 ...
- spring与分布式事务
转载:https://www.cnblogs.com/qianjun2017/p/8349829.html 转载:https://blog.csdn.net/jaryle/article/detail ...
- flink:StreamExecutionEnvironment、DataStream和Transformation与StreamOperator
1.StreamExecutionEnvironment: StreamExecutionEnvironment是构建执行任务环境以及任务的启动的入口,主要具备以下几方面的职责: a.存储全局相关的参 ...
- 我与oracle的爱恨情仇(第一章)
关于配置 问题一 可能是虚拟机桥接问题 问题解决的链接:[如何更改虚拟机桥接](https://jingyan.baidu.com/article/9113f81b7cfbd22b3214c790.h ...
- Python爬虫实战案例:取喜马拉雅音频数据详解
前言 喜马拉雅是专业的音频分享平台,汇集了有声小说,有声读物,有声书,FM电台,儿童睡前故事,相声小品,鬼故事等数亿条音频,我最喜欢听民间故事和德云社相声集,你呢? 今天带大家爬取喜马拉雅音频数据,一 ...