
scrapy项目4:爬取当当网中机器学习的数据及价格(CrawlSpider类)
scrapy项目3中已经对网页规律作出解析,这里用crawlspider类对其内容进行爬取;
项目结构与项目3中相同如下图,唯一不同的为book.py文件
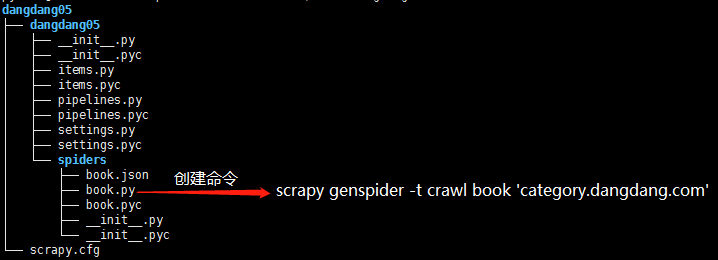
crawlspider类的爬虫文件book的生成命令为:scrapy genspider -t crawl book 'category.dangdang.com'
book.py代码如下:
# -*- coding: utf-8 -*-

import scrapy

# 创建用于提取响应中连接的对象

from scrapy.linkextractors import LinkExtractor

# Rule 用于发送从 LinkExtractor 中提取的连接

from scrapy.spiders import CrawlSpider, Rule

from dangdang05.items import Dangdang05Item

class BookSpider(CrawlSpider):

    name = 'book'

    allowed_domains = ['category.dangdang.com']

    start_urls = ['http://category.dangdang.com/cp01.54.12.00.00.00.html']

    # 提取连接信息,并将提取到的向提取到的url发送请求,调用回调函数处理请求

    # 注意follow表示是否继续对response中的连接进行提取,True表示提取,False表示不再提取

    # 当未指定回调函数时,follow的默认值为True,当指定回调函数时follow的默认值为False

    rules = [Rule(LinkExtractor(allow=r'/pg\d+-cp01.54.12.00.00.00.html'),callback='parse_item',follow=True)]

    def parse_item(self, response):

        # 实例化items中的类

        item = Dangdang05Item()

        # 网页解析第一步,返回selector对对象

        book_list = response.xpath('//ul[@class="bigimg"]/li')

        for book_info in book_list:

            # 书籍名称

            item['name'] = book_info.xpath('./p[@class="name"]/a/@title').extract()[0]

            # 书籍价格

            item['price'] = book_info.xpath('./p[@class="price"]/span[1]/text()').extract()[0]

            yield item
scrapy项目4:爬取当当网中机器学习的数据及价格(CrawlSpider类)的更多相关文章
- scrapy项目3:爬取当当网中机器学习的数据及价格(spider类)
1.网页解析 当当网中,人工智能数据的首页url如下为http://category.dangdang.com/cp01.54.12.00.00.00.html 点击下方的链接,一次观察各个页面的ur ...
- Scrapy爬虫(5)爬取当当网图书畅销榜
本次将会使用Scrapy来爬取当当网的图书畅销榜,其网页截图如下: 我们的爬虫将会把每本书的排名,书名,作者,出版社,价格以及评论数爬取出来,并保存为csv格式的文件.项目的具体创建就不再多讲 ...
- python爬虫06 | 你的第一个爬虫,爬取当当网 Top 500 本五星好评书籍
来啦,老弟 我们已经知道怎么使用 Requests 进行各种请求骚操作 也知道了对服务器返回的数据如何使用 正则表达式 来过滤我们想要的内容 ... 那么接下来 我们就使用 requests 和 re ...
- 网络爬虫之定向爬虫:爬取当当网2015年图书销售排行榜信息(Crawler)
做了个爬虫,爬取当当网--2015年图书销售排行榜 TOP500 爬取的基本思想是:通过浏览网页,列出你所想要获取的信息,然后通过浏览网页的源码和检查(这里用的是chrome)来获相关信息的节点,最后 ...
- python爬取当当网的书籍信息并保存到csv文件
python爬取当当网的书籍信息并保存到csv文件 依赖的库: requests #用来获取页面内容 BeautifulSoup #opython3不能安装BeautifulSoup,但可以安装Bea ...
- python爬取返利网中值得买中的数据
先使用以前的方法将返利网的数据爬取下来,scrapy框架还不熟练,明日再战scrapy 查找目标数据使用的是beautifulsoup模块. 1.观察网页,寻找规律 打开值得买这块内容 1>分析 ...
- java爬虫,爬取当当网数据
背景:女票快毕业了(没错!我是有女票的!!!),写论文,主题是儿童性教育,查看儿童性教育绘本数据死活找不到,没办法,就去当当网查询下数据,但是数据怎么弄下来呢,首先想到用Python,但是不会!!百 ...
- 【转】java爬虫,爬取当当网数据
背景:女票快毕业了(没错!我是有女票的!!!),写论文,主题是儿童性教育,查看儿童性教育绘本数据死活找不到,没办法,就去当当网查询下数据,但是数据怎么弄下来呢,首先想到用Python,但是不会!!百 ...
- selenium自动化测试工具模拟登陆爬取当当网top500畅销书单
selenium自动化测试工具可谓是爬虫的利器,基本动态加载的网页都能抓取,当然随着大型网站的更新,也出现针对selenium的反爬,有些网站可以识别你是否用的是selenium访问,然后对你加以限制 ...
随机推荐
- javaScript中==和===对数组、对象的判断是它们是否同一个实例对象
问题描述 在实现业务时,大量用到了 if(a === b)这样的判断,但有一个类似判断一直进不去这个if条件, a === b 返回的一直是false,但是其他几个类似判断,都正常触发条件. 原因 ...
- node项目自动化部署--基于Jenkins,Docker,Github(2)配置节点
上一篇文章中准备工作已经完成的差不多了 这一篇主要讲解 Jenkins 上面的相关配置 为了让代码部署到所有的子节点上 所以我们首先需要在 Jenkins 中添加我们希望代码部署到的节点 配置节点 首 ...
- 02:Redis常见面试题
1.1 redis基础面试题 1.什么是Redis?简述它的优缺点? 1. Redis本质上是一个Key-Value类型的内存数据库,很像memcached. 2. 整个数据库统统加载在内存当中进行操 ...
- Jquery复习(二)之stop()易忘点
jQuery stop() 方法 jQuery stop() 方法用于停止动画或效果,在它们完成之前. stop() 方法适用于所有 jQuery 效果函数,包括滑动.淡入淡出和自定义动画. 语法:$ ...
- day04-jQuery
jQ宗旨:write less do more jq是js的框架,底层封装了js代码. jq引入: <script type="text/javascript" src=&q ...
- Android 组件化之路 资源冲突问题
比如我现在有3个模块:app模块,user模块,me模块,其中app模块依赖user模块和me模块. 然后我在user模块和me模块的strings.xml中都定义了greet字符串: // user ...
- KVM安装配置笔记
系统环境centos6.6 一.KVM安装前系统相关操作: (1)修改内核模式为兼容内核启动 # grep -v "#" /etc/grub.confdevice (hd0) HD ...
- WebApi 生成帮助文档及顺便创建简单的测试工具
http://www.2cto.com/kf/201607/522971.html ==========最终的效果图========== ==========下面开始干活========== 一.创建 ...
- UIWebView与JS的交互
IOS-的UIWebView UIWebVew是ios开发中较为常用的一个控件.其可以打开网页,加载html,打开文档等.当我们在开发中需要用到一些显示页面时,UIWebView是一个很好的选择. 创 ...
- bcdedit删除uefi多余项
1.检查是否有多余的启动项:用管理员权限的cmd运行Bcdedit /enum firmware 2.保存现在的所有引导项Bcdedit /export savebcdsavebcd是导出的文件名 3 ...