
scrapy项目3:爬取当当网中机器学习的数据及价格(spider类)
1.网页解析
当当网中,人工智能数据的首页url如下为http://category.dangdang.com/cp01.54.12.00.00.00.html

点击下方的链接,一次观察各个页面的url变化,发现每一页的url规律如下:在进行页面切换时除第一页外,其他页面的url变化规律为只有pg后的数字会随着页面的不同而变化,并且和页面数相同,我们就可以利用此规律,运用spider类来对每一个这样的页面信息进行爬取,并且符合此种规律的页面均可以按照同样的方式来爬取;
第1页:http://category.dangdang.com/cp01.54.12.00.00.00.html
第2页:http://category.dangdang.com/pg2-cp01.54.12.00.00.00.html
第3页:http://category.dangdang.com/pg3-cp01.54.12.00.00.00.html
第4页:http://category.dangdang.com/pg4-cp01.54.12.00.00.00.html
2. scrapy 具体实现代码
目标:爬取当当网上人工智能类数据的名称和价格,如下图:

2.1)项目结构:
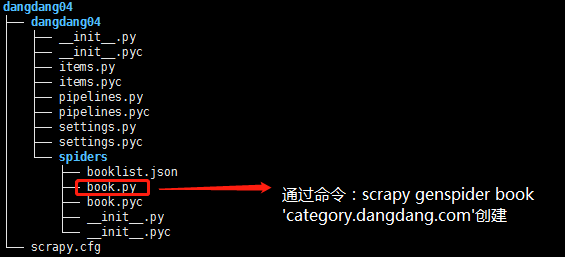
2.2)book.py代码
# -*- coding: utf-8 -*-

import scrapy

# 导入items中的类

from dangdang04.items import Dangdang04Item

class BookSpider(scrapy.Spider):

    name = "book"

    allowed_domains = ["category.dangdang.com"]

    url = 'http://category.dangdang.com/'

    offset = 1

    start_urls = [url + 'cp01.54.12.00.00.00.html']

    def parse(self, response):

        # 实例化类

        item = Dangdang04Item()

        # 定义提取规则,返回selector对象

        book_list = response.xpath('//ul[@class="bigimg"]/li')

        for book_info in book_list:

            # 书的名称

            item['name'] = book_info.xpath('./p[@class="name"]/a/@title').extract()[0]

            # 书的价格

            item['price'] = book_info.xpath('./p[@class="price"]/span[1]/text()').extract()[0]

            yield item

        if self.offset < 80:

            # 构建新的url再次发送请求

            self.offset += 1

            url = self.url + 'pg' + str(self.offset) + '-cp01.54.12.00.00.00.html'

            yield scrapy.Request(url,callback=self.parse)
2.3)items.py代码
# -*- coding: utf-8 -*-

# Define here the models for your scraped items

#

# See documentation in:

# http://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class Dangdang04Item(scrapy.Item):

    # 图书名称

    name = scrapy.Field()

    # 价格

    price = scrapy.Field()
2.4)pipelines.py代码
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html

import json

class Dangdang04Pipeline(object):

    def __init__(self):

        # 定义json文件,用于写入爬取的目标信息

        self.filename = open('booklist.json','w')

    def process_item(self, item, spider):

        # 将item数据转换乘json格式数据

        text = json.dumps(dict(item),ensure_ascii = False) + '\n'

        # 将text数据写入本地文件中

        self.filename.write(text.encode('utf-8'))

        return item

    def close_spider(self,spider):

        # 爬虫结束,关闭本地文件

        self.filename.close()
2.5).settings.py文件对应设置
# user-agent设置

USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0'

# 下载延迟设置

DOWNLOAD_DELAY = 2.5

# 关键文件配置

ITEM_PIPELINES = {

    'dangdang04.pipelines.Dangdang04Pipeline': 300,

}
scrapy项目3:爬取当当网中机器学习的数据及价格(spider类)的更多相关文章
- scrapy项目4:爬取当当网中机器学习的数据及价格(CrawlSpider类)
scrapy项目3中已经对网页规律作出解析,这里用crawlspider类对其内容进行爬取: 项目结构与项目3中相同如下图,唯一不同的为book.py文件 crawlspider类的爬虫文件book的 ...
- Scrapy爬虫(5)爬取当当网图书畅销榜
本次将会使用Scrapy来爬取当当网的图书畅销榜,其网页截图如下: 我们的爬虫将会把每本书的排名,书名,作者,出版社,价格以及评论数爬取出来,并保存为csv格式的文件.项目的具体创建就不再多讲 ...
- python爬虫06 | 你的第一个爬虫,爬取当当网 Top 500 本五星好评书籍
来啦,老弟 我们已经知道怎么使用 Requests 进行各种请求骚操作 也知道了对服务器返回的数据如何使用 正则表达式 来过滤我们想要的内容 ... 那么接下来 我们就使用 requests 和 re ...
- 网络爬虫之定向爬虫:爬取当当网2015年图书销售排行榜信息(Crawler)
做了个爬虫,爬取当当网--2015年图书销售排行榜 TOP500 爬取的基本思想是:通过浏览网页,列出你所想要获取的信息,然后通过浏览网页的源码和检查(这里用的是chrome)来获相关信息的节点,最后 ...
- python爬取当当网的书籍信息并保存到csv文件
python爬取当当网的书籍信息并保存到csv文件 依赖的库: requests #用来获取页面内容 BeautifulSoup #opython3不能安装BeautifulSoup,但可以安装Bea ...
- python爬取返利网中值得买中的数据
先使用以前的方法将返利网的数据爬取下来,scrapy框架还不熟练,明日再战scrapy 查找目标数据使用的是beautifulsoup模块. 1.观察网页,寻找规律 打开值得买这块内容 1>分析 ...
- java爬虫,爬取当当网数据
背景:女票快毕业了(没错!我是有女票的!!!),写论文,主题是儿童性教育,查看儿童性教育绘本数据死活找不到,没办法,就去当当网查询下数据,但是数据怎么弄下来呢,首先想到用Python,但是不会!!百 ...
- 【转】java爬虫,爬取当当网数据
背景:女票快毕业了(没错!我是有女票的!!!),写论文,主题是儿童性教育,查看儿童性教育绘本数据死活找不到,没办法,就去当当网查询下数据,但是数据怎么弄下来呢,首先想到用Python,但是不会!!百 ...
- selenium自动化测试工具模拟登陆爬取当当网top500畅销书单
selenium自动化测试工具可谓是爬虫的利器,基本动态加载的网页都能抓取,当然随着大型网站的更新,也出现针对selenium的反爬,有些网站可以识别你是否用的是selenium访问,然后对你加以限制 ...
随机推荐
- [转帖]Spring Cloud底层原理
拜托!面试不要再问我Spring Cloud底层原理 https://mp.weixin.qq.com/s/ZH-3JK90mhnJPfdsYH2yDA 毫无疑问,Spring Cloud 是目前微服 ...
- Java Content Repository API 简介 转自(https://www.ibm.com/developerworks/cn/java/j-jcr/)
Java Content Repository API 简介 1 如果曾经试过开发内容管理应用程序,那么您应当非常清楚在实现内容系统时所遇到的固有难题.这个领地有点支离破碎,许多供应商都有自己的私有仓 ...
- 360度3D 旋转插件
Circlr插件是一款基于jQuery的可以对图片进行360度全方位旋转展示的插件.Circlr通过按一定角度规律拍摄的产品图片,制作出可以使用鼠标拖动.鼠标滚轮和移动触摸来进行图片逐帧旋转的效果.比 ...
- 初识JavaScript(二)
初识JavaScript(二) 我从上一篇<初识JavaScript(一)>知道和认识JavaScript的词法结构,也开始慢慢接触到了JavaScript的使用方法,是必须按照JavaS ...
- 模板 - 强连通分量/割点/桥 - Tarjan
int dfn[N], low[N], dfncnt, s[N], tp; int scc[N], sc; // 结点 i 所在 scc 的编号 int sz[N]; // 强连通 i 的大小 voi ...
- sql认识
DDL – Data Definition Language数据定义语言DML – Data Manipulation Language数据操作语言DCL – Data Control Languag ...
- c#委托(Delegates)--基本概念及使用
在我这菜鸟理解上,委托就是可以用方法名调用另一方法的便捷方法,可以简化switch等语句的重复.最近做项目的时候恰好需要用到委托,便来复习及学习委托的使用.嗯...本人以前并没有用过,只是稍微知道而已 ...
- vue中如何引入css文件
两种方式引入css文件,一种是直接在main.js中引入(也可以在其他的.vue文件中的<script></script>标签中),即下面这种写法: import 'eleme ...
- 一、bif
缩进是python的灵魂,缩进可以使python的代码整洁,有层次. python是脚本语言,就是为了简单方便以辅助科学运算,因此python有许多bif,build in function 全部都是 ...
- Spring-data-jpa n+1问题
Spring-data-jpa的n+1问题 当我们使用JPA提供给我们的find方法时,如果查询出来的对象关联着另外10个对象,那么JPA将会发送1+10次查询(这个对象本身要查询一次,然后每个关联对 ...