
HDP Spark2 HIVE3.1 的问题
HDP 上安装了 Hive3.1 和 Spark2, 提交 Spark 作业时,报找不到 Hive 中表的问题
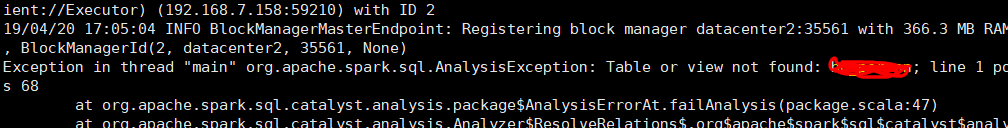
但是查一了下 hive 表,明明是存在这个表的。查看日志,注意到如下的一段日志。
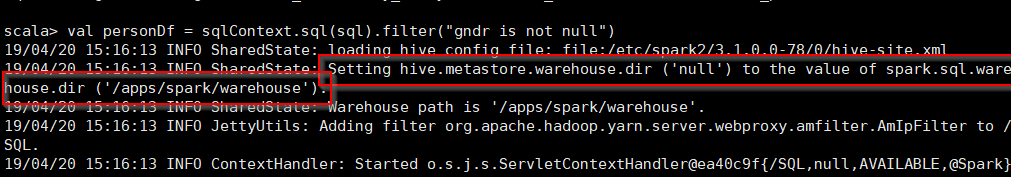
没修改值之前,我在 Spark-shell 里创建了一张 hive 表,发现其创建的位置是 spark.sql.warehouse.dir 指向的目录,不在 hive.metastore.warehouse.dir 目录里 (其实这个值在 hive 中的配置,但是 spark 的 conf 下的目录里没有配置)。我在 spark 的 conf 目录里增加了 hive.metastore.warehouse.dir 的值,使其与 hive 中配置的值一样。可是我修改后,在 spark-shell 里查寻表时,依然显示是刚才创建的表。我把 spark.sql.warehouse.dir 的值也改成 hive.metastore.warehouse.dir 的值,仍然如此。
网上的另外几种方法:
1. 把 hive-site.xml 复制到 Spark 的 conf 目录下。
我看了一下 spark 的 conf 目录,有 hive-site.xml 这个表的,而且从日志中也可以看到 spark 能找到 hive 的 thrift://datacenter2:9083 这个地址,说明没问题。
2. 创建 spark session 的时候要启用 hive。
val ss = SparkSession.builder().appName("统计").enableHiveSupport().getOrCreate()
我的程序里有启用的,所以也不是原因。
3. 关闭 Hive 3 中的默认的 ACID 功能,修改如下几个参数
hive.strict.managed.tables=false

hive.create.as.insert.only=false

metastore.create.as.acid=false
试过之后,问题依旧。
崩溃了,找不到其它解决方法了。先记录一下。
================================================
有别的事,先做别的了。过了2天,抱着试试看的态度,在 /etc/spark2/3.1.0.0-78/0 下建了个软链接到 /etc/hive/conf 下的 hive-site.xml ,竟然找得到表了。通过比较,发现原 spark 下的 hive-site.xml 里多了一个 metastore.catalog.default 的配置,值是 spark。在网上搜了一下,才知道要改成 hive 才可以读 hive 下创建的表。这个值我理解的是表示hive仓库的命名空间。为什么 Spark 没有默认设置成 hive 的 catalog 的呢? 因为 HDP 3.1 中的 hive 会默认开启 ACID,spark 读取 ACID 的 表时,会出错,所以设置了一个 spark 的 catalog。
HDP Spark2 HIVE3.1 的问题的更多相关文章
- Ambari HDP 下 SPARK2 与 Phoenix 整合
1.环境说明 操作系统 CentOS Linux release 7.4.1708 (Core) Ambari 2.6.x HDP 2.6.3.0 Spark 2.x Phoenix 4.10.0-H ...
- spark2.4.0+hadoop2.8.3全分布式集群搭建
集群环境 hadoop-2.8.3搭建详细请查看hadoop系列文章 scala-2.11.12环境请查看scala系列文章 jdk1.8.0_161 spark-2.4.0-bin-hadoop2. ...
- Ubuntu 16.04.4 LTS + Ambari 2.6.1.5 + HDP 2.6.4.0 安装部署
服务器 主机名 master slave1 slave2 slave3 IP 192.168.1.40 192.168.1.41 192.168.1.42 192.168.1.43 离线包服务器: 1 ...
- ambari 2.6.2 安装 hdp 2.6.5.0 遇到的问题
1.hive-client 无法安装 一直报错(symlink target already exists and it is not a symlink.),hive-client 已经存在且不是 ...
- Spark-2.3.2【SparkStreaming+SparkSQL-实时仪表盘应用】
应用场景:实时仪表盘(即大屏),每个集团下有多个mall,每个mall下包含多家shop,需实时计算集团下各mall及其shop的实时销售分析(区域.业态.店铺TOP.总销售额等指标)并提供可视化展现 ...
- HDP 企业级大数据平台
一 前言 阅读本文前需要掌握的知识: Linux基本原理和命令 Hadoop生态系统(包括HDFS,Spark的原理和安装命令) 由于Hadoop生态系统组件众多,导致大数据平台多节点的部署,监控极其 ...
- geotrellis使用(二十五)将Geotrellis移植到spark2.0
目录 前言 升级spark到2.0 将geotrellis最新版部署到spark2.0(CDH) 总结 一.前言 事情总是变化这么快,前面刚写了一篇博客介绍如何将geotrellis移植 ...
- Ubuntu14.04或16.04下安装JDK1.8+Scala+Hadoop2.7.3+Spark2.0.2
为了将Hadoop和Spark的安装简单化,今日写下此帖. 首先,要看手头有多少机器,要安装伪分布式的Hadoop+Spark还是完全分布式的,这里分别记录. 1. 伪分布式安装 伪分布式的Hadoo ...
- maven+spark2.0.0最大连通分量
运用到了spark2.0.0的grarhx包,要手动的在pom.xml里面添加依赖包,要什么就在里面添加依赖,然后在run->maven install
随机推荐
- LInux Centos7 重装yum
Linux yum默认安装python2.7,犹豫2020年之后不更新, 安装python3.6,出现了yum运行失败, 因为yum是依赖python的 1:先删除原有YUM rpm -aq|grep ...
- ManagedProperty not injected in @FacesConverter
I'm trying to inject a ManagedBean in my FacesConverted the following way: @ManagedBean @RequestScop ...
- 【325】python**:selenium
参考:selenium安装方式 参考:Selenium2(Webdriver)+Python处理浏览器弹窗
- aws代理
ssh -i ~/.ssh/seoul-notification-dev.pem ec2-user@52.79.58.125ssh -CqTnN -D localhost:7080 -i ~/. ...
- python实现测试报告的bug统计
背景:组内要针对每个项目生成测试报告,要对当前项目的一些bug进行统计.考虑到人工统计比较繁琐,而且是个长期的工作,所以写个脚本对bug进行自动统计.(我们用的bug平台是bugfree,直接可以导出 ...
- 05-了解activiti目录结构
数据库底层支持的23张表的增删改查 如果你不会用activiti的API,可以看一下开发文档 流程引擎ProcessEngines,最重要是这个玩意. libs就更重要了,我们使用一个框架主要是使用它 ...
- Python_03-数据类型
1.1 数据类型 基本数据类型:字符串,整数,浮点数,布尔型 集合类型:列表(list), 元组(tuple), 字典(dictionary或hash) 列表(list)的定义: aList = ...
- 阿里云EIP按流量计费
https://help.aliyun.com/document_detail/27767.html 计费周期为1小时,账单周期也为1小时.在一个计费周期内,如果您使用的时间不足一小时,按一小时收费. ...
- DataTable记录
DataTable dt2 = dt.Copy();//复制结构和数据 //复制结构,不要数据 DataTable dt2 = new DataTable(); for (int i = 0; i & ...
- 理解数据库中的undo日志、redo日志、检查点
数据库存放数据的文件,本文称其为data file. 数据库的内容在内存里是有缓存的,这里命名为db buffer.某次操作,我们取了数据库某表格中的数据,这个数据会在内存中缓存一些时间.对这个数据的 ...