
Elasticsearch聚合 之 Histogram 直方图聚合
Elasticsearch支持最直方图聚合,它在数字字段自动创建桶,并会扫描全部文档,把文档放入相应的桶中。这个数字字段既可以是文档中的某个字段,也可以通过脚本创建得出的。
桶的筛选规则
举个例子,有一个price字段,这个字段描述了商品的价格,现在想每隔5就创建一个桶,统计每隔区间都有多少个文档(商品)。
如果有一个商品的价格为32,那么它会被放入30的桶中,计算的公式如下:
rem = value % interval

if (rem < 0) {

    rem += interval

}

bucket_key = value - rem
通过上面的方法,就可以确定文档属于哪一个桶。
不过也有一些问题存在,由于上面的方法是针对于整型数据的,因此如果字段是浮点数,那么需要先转换成整型,再调用上面的方法计算。问题来了,正数还好,如果该值是负数,就会出现计算出错。比如,一个字段的值为-4.5,在进行转换整型时,转换成了-4。那么按照上面的计算,它就会放入-4的桶中,但是其实-4.5应该放入-6的桶中。
min_doc_count过滤
聚合的dsl如下:
{

    "aggs" : {

        "prices" : {

            "histogram" : {

                "field" : "price",

                "interval" : 50

            }

        }

    }

}
得到的数据为:
{

    "aggregations": {

        "prices" : {

            "buckets": [

                {

                    "key": 0,

                    "doc_count": 2

                },

                {

                    "key": 50,

                    "doc_count": 4

                },

                {

                    "key": 100,

                    "doc_count": 0

                },

                {

                    "key": 150,

                    "doc_count": 3

                }

            ]

        }

    }

}
上面的数据中,100-150是没有文档的,但是却显示为0.如果不想要显示count为0的桶,可以通过min_doc_count来设置。
{

    "aggs" : {

        "prices" : {

            "histogram" : {

                "field" : "price",

                "interval" : 50,

                "min_doc_count" : 1

            }

        }

    }

}
这样返回的数据,就不会出现为0的了。
{

    "aggregations": {

        "prices" : {

            "buckets": [

                {

                    "key": 0,

                    "doc_count": 2

                },

                {

                    "key": 50,

                    "doc_count": 4

                },

                {

                    "key": 150,

                    "doc_count": 3

                }

            ]

        }

    }

}
extend_bounds,指定最小值和最大值边界
默认情况下,ES中的histogram聚合起始都是自动的,比如price字段,如果没有商品的价钱在0-5之间,0这个桶就不会显示。如果最便宜的商品是11,那么第一个桶就是10.
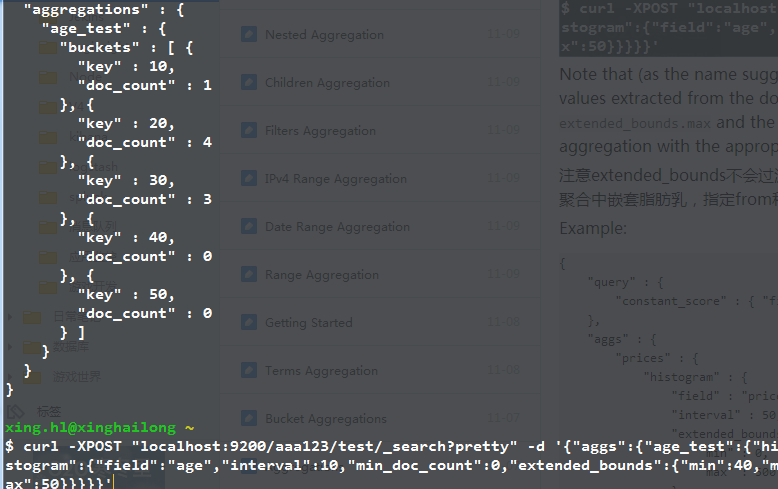
可以通过设置extend_bounds强制规定最小值和最大值,但是要求必须min_doc_count不能大于0,不然即便是规定了边界,也不会返回。

另外需要注意的是,如果规定的extend_bounds.min要大于文档中的最小值,那么就会按照文档中的最小值来(extend_bounds.max也是如此)。
比如下面的这个例子,规定的extend_bounds.min和max分别是40和50,但是文档中含有比40还要小的数据,因此桶的定义仍然是按照文档中的数据来。
order排序
排序大同小异,可以按照_key的名字排序:
{

    "aggs" : {

        "prices" : {

            "histogram" : {

                "field" : "price",

                "interval" : 50,

                "order" : { "_key" : "desc" }

            }

        }

    }

}
也可以按照文档的数目:
{

    "aggs" : {

        "prices" : {

            "histogram" : {

                "field" : "price",

                "interval" : 50,

                "order" : { "_count" : "asc" }

            }

        }

    }

}
或者指定排序的聚合:
{

    "aggs" : {

        "prices" : {

            "histogram" : {

                "field" : "price",

                "interval" : 50,

                "order" : { "price_stats.min" : "asc" }

            },

            "aggs" : {

                "price_stats" : { "stats" : {} }

            }

        }

    }

}
keyed设置返回的方式
正常返回的数据如上面所示,是按照数组的方式返回。如果要按照名字返回,可以设置keyed为true
{

    "aggs" : {

        "prices" : {

            "histogram" : {

                "field" : "price",

                "interval" : 50,

                "keyed" : true

            }

        }

    }

}
那么返回的数据就为:
{

    "aggregations": {

        "prices": {

            "buckets": {

                "0": {

                    "key": 0,

                    "doc_count": 2

                },

                "50": {

                    "key": 50,

                    "doc_count": 4

                },

                "150": {

                    "key": 150,

                    "doc_count": 3

                }

            }

        }

    }

}
缺省的值
缺省值通过MissingValue设置:
{

    "aggs" : {

        "quantity" : {

             "histogram" : {

                 "field" : "quantity",

                 "interval": 10,

                 "missing": 0

             }

         }

    }

}
Elasticsearch聚合 之 Histogram 直方图聚合的更多相关文章
- Elasticsearch聚合 Date Histogram聚合
转 http://www.cnblogs.com/xing901022/p/4951603.html Elasticsearch的聚合主要分成两大类:metric和bucket,2.0中新增了pipe ...
- Elasticsearch聚合 之 Range区间聚合
Elasticsearch提供了多种聚合方式,能帮助用户快速的进行信息统计与分类,本篇主要讲解下如何使用Range区间聚合. 最简单的例子,想要统计一个班级考试60分以下.60到80分.80到100分 ...
- ElasticSearch 2 (35) - 信息聚合系列之近似聚合
ElasticSearch 2 (35) - 信息聚合系列之近似聚合 摘要 如果所有的数据都在一台机器上,那么生活会容易许多,CS201 课商教的经典算法就足够应付这些问题.但如果所有的数据都在一台机 ...
- elasticsearch聚合之bucket terms聚合
目录 1. 背景 2. 前置条件 2.1 创建索引 2.2 准备数据 3. 各种聚合 3.1 统计人数最多的2个省 3.1.1 dsl 3.1.2 运行结果 3.2 统计人数最少的2个省 3.2.1 ...
- Elasticsearch学习系列四(聚合搜索)
聚合分析 聚合分析是数据库中重要的功能特性,完成对一个查询的集中数据的聚合计算.如:最大值.最小值.求和.平均值等等.对一个数据集求和,算最大最小值等等,在ES中称为指标聚合,而对数据做类似关系型数据 ...
- Flask聚合函数(基本聚合函数、分组聚合函数、去重聚合函数))
Flask聚合函数 1.基本聚合函数(sun/count/max/min/avg) 使用聚合函数先导入:from sqlalchemy import func 使用方法: sun():func.sum ...
- 把 Elasticsearch 当数据库使:聚合后排序
使用 https://github.com/taowen/es-monitor 可以用 SQL 进行 elasticsearch 的查询.有的时候分桶聚合之后会产生很多的桶,我们只对其中部分的桶关心. ...
- Elasticsearch 聚合统计与SQL聚合统计语法对比(一)
Es相比关系型数据库在数据检索方面有着极大的优势,在处理亿级数据时,可谓是毫秒级响应,我们在使用Es时不仅仅进行简单的查询,有时候会做一些数据统计与分析,如果你以前是使用的关系型数据库,那么Es的数据 ...
- Elasticsearch 第六篇:聚合统计查询
h2.post_title { background-color: rgba(43, 102, 149, 1); color: rgba(255, 255, 255, 1); font-size: 1 ...
随机推荐
- 七牛php sdk 生成上传凭证时出现 undefined function Qiniu_SetKeys()
将qiniu/http.php文件改名即可,原因是xampp等集成环境会安装pear存在了http.php
- [转载]并发编程之Operation Queue和GCD
并发编程之Operation Queue http://www.cocoachina.com/applenews/devnews/2013/1210/7506.html 随着移动设备的更新换代,移动设 ...
- UWP开发随笔——使用SQLite数据库
摘要 大多数的app都需要数据存储,在数据存储这方面,强大的windows把app数据分为两种:settings和files,并提供了十分简洁的api,让开发者能够轻松使用.但是在有些场景下,app的 ...
- MySQL2:四种MySQL存储引擎
前言 数据库存储引擎是数据库底层软件组织,数据库管理系统(DBMS)使用数据引擎进行创建.查询.更新和删除数据.不同的存储引擎提供不同的存储机制.索引技巧.锁定水平等功能,使用不同的存储引擎,还可以 ...
- 《你必须知道的.NET》读书笔记一:小OO有大智慧
此篇已收录至<你必须知道的.Net>读书笔记目录贴,点击访问该目录可以获取更多内容. 一.对象 (1)出生:系统首先会在内存中分配一定的存储空间,然后初始化其附加成员,调用构造函数执行初 ...
- 一句话解释c#中的特性,你了解多少
自己闲着无聊写的,当然有些描述不是十分准确,毕竟一句话不能表达太多意思. 委托:把方法当做参数进行传递. 泛型:在类.方法中对使用的类型参数化. 匿名方法:委托及调用委托的简化版. Lambda表达式 ...
- <HTML5和CSS3响应式WEB设计指南>译者序
"不是我不明白,这世界变化快."崔健的这首歌使用在互联网领域最合适不过.只短短数年的功夫,互联网的浪潮还没过去,移动互联网的时代已经来临.人们已经习惯将越来越多的时间花在各种移动设 ...
- 跟我一起云计算(1)——storm
概述 最近要做一个实时分析的项目,所以需要深入一下storm. 为什么storm 综合下来,有以下几点: 1. 生逢其时 MapReduce 计算模型打开了分布式计算的另一扇大门,极大的降低了实现分布 ...
- java arraylist的问题
不得不说,我犯了错,很基础的.. 遍历list的时候可以删除数组元素吗? 答案是:简单/增强for循环不可以,list.iterator()这样的方式就可以. 我之前做过类似面试题的,不过忘记了, 不 ...
- iOS给图片添加滤镜&使用openGLES动态渲染图片
给图片增加滤镜有这两种方式: CoreImage / openGLES 下面先说明如何使用CoreImage给图片添加滤镜, 主要为以下步骤: #1.导入CIImage格式的原始图片 #2.创建CIF ...