
中文维基百科分类提取(jwpl)--构建知识图谱数据获取
首先感谢 :
1.https://blog.csdn.net/qq_39023569/article/details/88556301
2.https://www.cnblogs.com/CherishFX/p/5280259.html
3.https://www.cs.bgu.ac.il/~elhadad/nlp12/jwpl/wikification.html
4.https://blog.csdn.net/Icy233333/article/details/80383336
一。中文维基数据准备。
https://dumps.wikimedia.org/zhwiki/latest/
选择:
LANGCODE]wiki-[DATE]-pages-articles.xml.bz2
[LANGCODE]wiki-[DATE]-pagelinks.sql.gz
[LANGCODE]wiki-[DATE]-categorylinks.sql.gz
注:维基服务器限流,并且时不时会中断。可以直接使用linux 的 wget -c https://xxxxxxxxxxxxxxxxxxxx 方式实现可断点续接的下载。
下载完后放在一个文件夹下。 我放在 F:\zhwiki2019\~ 下。
二。下载JWPL DataMachine jar包解析数据文件
直接去maven库中下载整个jar-with-dependencies.jar。下载地址:http://search.maven.org/#search|ga|1|tudarmstadt.ukp
搜索de.tudarmstadt.ukp.wikipedia.datamachine对应的jar-with-dependencies.jar 文件下载。
下载后和数据放在同一目录下。
三。打开cmd,cd到zhwiki2019目录下,输入以下命令解析。
java -cp jar-with-dependencies.jar de.tudarmstadt.ukp.wikipedia.datamachine.domain.JWPLDataMachine [LANGUAGE] [MAIN_CATEGORY_NAME] [DISAMBIGUATION_CATEGORY_NAME] [SOURCE_DIRECTORY]
其中,
LANGUAGE: 指jwpl支持的语言,选择一个你下载的wikipedia语言,比如english, chinese
MAIN_CATEGORY_NAME: 填写一个Wikipedia类别层次上属于顶层的类别,比如:Contents
DISAMBIGUATION_CATEGORY_NAME: 填写一个有消歧类别的类别名,比如:Disambiguation_pages
SOURCE_DIRECTORY: 上面三个wikipedia文件的目录,比如: ~/En2019
我的命令:
java -Dfile.encoding=utf8 -cp de.tudarmstadt.ukp.wikipedia.datamachine-0.9.1-jar-with-dependencies.jar de.tudarmstadt.ukp.wikipedia.datamachine.domain.JWPLDataMachine chinese Contents Disambiguation_pages ~/zhwiki2019
如果你的系统默认编码不是utf-8(比如windows), 可能需要再加一个参数:-Dfile.encoding=utf8;
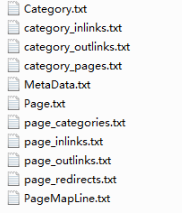
解析的时间看数据量的大小和你的cpu。之后会在output下生成11个txt.这11个txt就是之后要导入mysql的11个表。
这些文件的解释:
 category --> 类别信息

      pageId:类别ID,唯一

      name:类别名

 category_inlinks --> 指向类别的链接信息

      id:类别ID,不唯一

      inLinks:该类别父类ID,也就是指向该类别的类别ID

 category_outlinks --> 类别指向的链接信息

      id:类别ID,不唯一

      outLinks:该类别子类ID,也就是该类别指向的那些类别的ID

 category_pages --> 页面与类别的关系表

      id:类别ID,不唯一

      pages:属于该类别ID的页面ID

 metadata --> 该wikipedia的一些元信息,只有一条记录

      language:语言

      disambiguationCategory:运行DataMachine填写的消歧类别

      mainCategory:运行DataMachine填写的顶层类别

      nrofPages:页面个数

      nrofRedirects:重定向个数

      nrofDisambiguationPages:消歧页面个数

      nrofCategories:类别个数

      version

 page --> 页面信息

      pageId:页面ID

      name:名字

      text:全文,包含wikimeida的标记信息

      isDisambiguation:是否是消岐页面

 page_categories -->  页面与类别的关系表与category_pages信息重复

 page_inlinks --> 指向页面的页面信息

      id:页面ID,不唯一

      inLinks:指向该页面ID的页面ID

 page_outlinks

      id:页面ID,不唯一

      outlinks:该页面ID指向的页面ID

 page_redirects

      id:页面ID,不唯一

      redirects:重定向到该页面ID的所有页面ID

 pagemapline --> 所有页面的title信息,处理重定向等有用处

      id:该页面ID

      name:页面title名字

      pageID:页面ID,如果该页面是重定向页面,该pageID是其指向的那个包含信息的页面ID

      stem:***暂无信息

      lemma:***暂无信息
四。mysql 创建 库。(必须要mysql5.x版本。。我就是8.0.12失败找了原因重新下载了5.7.27版本的(错误:java.sql.SQLException: java.lang.ClassCastException: class java.math.BigInteger cannot be cast to ....)。jwpl通过C3P0来获得datasource.是获取datasource的阶段失败。)
1. 创建数据库命令(数据库名DB_NAME可以自行设定):注意要保证创建的数据库的编码是utf-8
CREATE DATABASE [DB_NAME] DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;
我的DB_NAME是zhwiki.
2.创建所有的表,下载包含所有表结构的sql脚本:jwpl_tables.sql脚本,在mysql命令下执行改脚本:
mysql> use [DB_NAME];

mysql> source jwpl_tables.sql;  #注意jwpl_tables.sql所在的路径(可以cd 到jwpl_tables.sql的目录下直接输入这个命令。)
3.因为我们的数据上传到数据库是存在mysql data目录下的,可以通过命令
mysql>show global variables like "%datadir%"
来查看你的数据库文件存放目录,我这里是在C盘,空间不够,所以需要修改data路径,将数据库data移到其他空间足够的盘,具体可以参考https://blog.csdn.net/wangyan_z/article/details/81089211
,来修改你的data路径,这里不过多说明。
4,导入数据到mysql中
一个表一个表的导入,进入之前创建的用户的数据库
load data infile 'F:/zhwiki2019/output/Category.txt' into table category;
 load data infile 'F:/zhwiki2019/output/Category.txt' into table category;

 load data infile 'F:/zhwiki2019/output/category_inlinks.txt' into table category_inlinks;

 load data infile 'F:/zhwiki2019/output/category_outlinks.txt' into table category_outlinks;

 load data infile 'F:/zhwiki2019/output/category_pages.txt' into table category_pages;

 load data infile 'F:/zhwiki2019/output/MetaData.txt' into table MetaData;

 load data infile 'F:/zhwiki2019/output/Page.txt' into table Page;

 load data infile 'F:/zhwiki2019/output/page_categories.txt' into table page_categories;

 load data infile 'F:/zhwiki2019/output/page_inlinks.txt' into table page_inlinks;

 load data infile 'F:/zhwiki2019/output/page_outlinks.txt' into table page_outlinks;

 load data infile 'F:/zhwiki2019/output/page_redirects.txt' into table page_redirects;

 load data infile 'F:/zhwiki2019/output/PageMapLine.txt' into table PageMapLine;
这里可能遇到mysql secure_file_priv问题。参考 https://blog.csdn.net/qq_35246620/article/details/78148505
解决完后,因为我处理的是中文维基的数据。mysql会报错utf8转义的问题。我查了我的系统编码和mysql的编码(参考https://bbs.csdn.net/topics/392478961),没有问题,只可能是数据的问题。打开后发现存在这样的数据: B\'z ,因为B‘z是一个组合。所以去掉 \ 就没问题了。自己可以写个小程序去掉。(或者去修改数据库的编码,通过navicat去编辑zhwiki的属性,然后选择utfmmd64)
五。使用JWPL jar包去访问维基百科数据
1.直接去maven库中下载整个jar-with-dependencies.jar。下载地址:http://search.maven.org/#search|ga|1|tudarmstadt.ukp
搜索de.tudarmstadt.ukp.wikipedia.api对应的 jar-with-dependencies.jar 文件,下载。
2.之后就是编码了。( jwpl论文:https://www.researchgate.net/publication/220745815_Extracting_Lexical_Semantic_Knowledge_from_Wikipedia_and_Wiktionary?ev=auth_pub)
论文中,说了工具主要以三个对象展开。直接给出代码。就可以看懂。
page对象:
 import de.tudarmstadt.ukp.wikipedia.api.Category;

 import de.tudarmstadt.ukp.wikipedia.api.DatabaseConfiguration;

 import de.tudarmstadt.ukp.wikipedia.api.Page;

 import de.tudarmstadt.ukp.wikipedia.api.Title;

 import de.tudarmstadt.ukp.wikipedia.api.WikiConstants.Language;

 import de.tudarmstadt.ukp.wikipedia.api.Wikipedia;

 import static de.tudarmstadt.ukp.wikipedia.api.WikiConstants.LF;

 public class ShowPageInfo {

     public static void main(String[] args) throws Exception {

         // 数据库连接参数配置

         DatabaseConfiguration dbConfig = new DatabaseConfiguration();

         dbConfig.setHost("localhost");   //主机名

         dbConfig.setDatabase("wikidb");  //数据库名

         dbConfig.setUser("root");        //访问数据库的用户名

         dbConfig.setPassword("root");    //访问数据库的密码

         dbConfig.setLanguage(Language.english);

         // 创建Wikipedia处理对象

         Wikipedia wiki = new Wikipedia(dbConfig);

         String title = "Fruit";

         Page page = wiki.getPage(title);

         // wikipedia页面的title

         System.out.println("Queried string       : " + title);

         System.out.println("Title                : " + page.getTitle());

         // 是否是消歧页面

         System.out.println("IsDisambiguationPage : " + page.isDisambiguation());

         // 是否是重定向页面

         System.out.println("redirect page query  : " + page.isRedirect());

         // 有多少个页面指向该页面

         System.out.println("# of ingoing links   : " + page.getNumberOfInlinks());

         // 该页面指向了多少个页面

         System.out.println("# of outgoing links  : " + page.getNumberOfOutlinks());

         // 该页面属于多少个类别

         System.out.println("# of categories      : " + page.getNumberOfCategories());

         StringBuilder sb = new StringBuilder();

         // 页面的所有重定向页面

         sb.append("Redirects" + LF);

         for (String redirect : page.getRedirects()) {

             sb.append("  " + new Title(redirect).getPlainTitle() + LF);

         }

         sb.append(LF);

         // 页面的所述的所有类别

         sb.append("Categories" + LF);

         for (Category category : page.getCategories()) {

             sb.append("  " + category.getTitle() + LF);

         }

         sb.append(LF);

         // 指向该页面的所有页面

         sb.append("In-Links" + LF);

         for (Page inLinkPage : page.getInlinks()) {

             sb.append("  " + inLinkPage.getTitle() + LF);

         }

         sb.append(LF);

         // 该页面指向的所有页面

         sb.append("Out-Links" + LF);

         for (Page outLinkPage : page.getOutlinks()) {

             sb.append("  " + outLinkPage.getTitle() + LF);

         }

         System.out.println(sb);

     }

 }
运行的部分结果:
 Queried string       : Fruit

 Title                : Fruit

 IsDisambiguationPage : false

 redirect page query  : false

 # of ingoing links   : 4454

 # of outgoing links  : 811

 # of categories      : 10
category对象:
 import de.tudarmstadt.ukp.wikipedia.api.Category;

 import de.tudarmstadt.ukp.wikipedia.api.DatabaseConfiguration;

 import de.tudarmstadt.ukp.wikipedia.api.Page;

 import de.tudarmstadt.ukp.wikipedia.api.WikiConstants.Language;

 import de.tudarmstadt.ukp.wikipedia.api.Wikipedia;

 import static de.tudarmstadt.ukp.wikipedia.api.WikiConstants.LF;

 public class ShowCategoryInfo {

     public static void main(String[] args) throws Exception {

         //连接数据库的配置

         DatabaseConfiguration dbConfig = new DatabaseConfiguration();

         dbConfig.setHost("localhost");

         dbConfig.setDatabase("wikidb");

         dbConfig.setUser("root");

         dbConfig.setPassword("root");

         dbConfig.setLanguage(Language.english);

         // 创建Wikipedia处理对象

         Wikipedia wiki = new Wikipedia(dbConfig);

         String title = "Towns in Germany";

         // 创建类对象

         Category cat = wiki.getCategory(title);

         StringBuilder sb = new StringBuilder();

         // 类别名

         sb.append("Title : " + cat.getTitle() + LF);

         sb.append(LF);

         // 类别的父类信息

         sb.append("# super categories : " + cat.getParents().size() + LF);

         for (Category parent : cat.getParents()) {

             sb.append("  " + parent.getTitle() + LF);

         }

         sb.append(LF);

         // 类别的子类信息

         sb.append("# sub categories : " + cat.getChildren().size() + LF);

         for (Category child : cat.getChildren()) {

             sb.append("  " + child.getTitle() + LF);

         }

         sb.append(LF);

         // 类别下的所有页面

         sb.append("# pages : " + cat.getArticles().size() + LF);

         for (Page page : cat.getArticles()) {

             sb.append("  " + page.getTitle() + LF);

         }

         System.out.println(sb);

     }

 }
 Title : Towns in Germany

 # super categories : 4

   Towns by country

   Commons category with local link same as on Wikidata

   Populated places in Germany

   Municipalities of Germany

 # sub categories : 16

   Towns in Rhineland-Palatinate

   Towns in Lower Saxony

   Towns in Saxony

   Towns in Mecklenburg-Vorpommern

   Towns in Saxony-Anhalt

   University towns in Germany

   Towns in Schleswig-Holstein

   Seaside resorts in Germany

   Towns in Baden-Württemberg

   Towns in Thuringia

   Towns in Hesse

   Towns in Saarland

   Towns in North Rhine-Westphalia

   Towns in Brandenburg

   Spa towns in Germany

   Towns in Bavaria

 # pages : 2

   Oberreichenbach

   Urfeld am Walchensee
其中,
Wikipedia 对象就是另一个主要的对象。page和categorty都要对这个对象进行访问,可以通过“单例模式”进行wikipedia的实例化。来节约资源,避免重复造轮子。
代码给出:
 public class WikipediaUtil {

     private static Wikipedia wiki = null;

     public static Wikipedia getWikipedia() {

         if (wiki == null) {

             synchronized (wiki) {

                 if (wiki == null) {

                     try {

                         DatabaseConfiguration dbconfig = new DatabaseConfiguration();

                         URL resource = WikipediaUtil.class.getClassLoader().getResource("zhwiki.properties");

                         String file = resource.getFile();

                         InputStream fileInputStream = new FileInputStream(file);

                         Properties properties = new Properties();

                         properties.load(fileInputStream);

                         dbconfig.setHost(properties.getProperty("host"));

                         dbconfig.setDatabase(properties.getProperty("db"));

                         dbconfig.setUser(properties.getProperty("user"));

                         dbconfig.setPassword(properties.getProperty("password"));

                         dbconfig.setLanguage(WikiConstants.Language.chinese);

                         wiki = new Wikipedia(dbconfig);

                     } catch (Exception e) {

                         e.printStackTrace();

                     }

                 }

             }

         }

         return wiki;

     }

 }
剩下的探索吧...欢迎评论一起进步。
中文维基百科分类提取(jwpl)--构建知识图谱数据获取的更多相关文章
- Windows下基于python3使用word2vec训练中文维基百科语料(二)
在上一篇对中文维基百科语料处理将其转换成.txt的文本文档的基础上,我们要将为文本转换成向量,首先都要对文本进行预处理 步骤四:由于得到的中文维基百科中有许多繁体字,所以我们现在就是将繁体字转换成简体 ...
- 使用word2vec对中文维基百科数据进行处理
一.下载中文维基百科数据https://dumps.wikimedia.org/zhwiki/并使用gensim中的wikicorpus解析提取xml中的内容 二.利用opencc繁体转简体 三.利用 ...
- Windows下基于python3使用word2vec训练中文维基百科语料(一)
在进行自然语言处理之前,首先需要一个语料,这里选择维基百科中文语料,由于维基百科是 .xml.bz2文件,所以要将其转换成.txt文件,下面就是相关步骤: 步骤一:下载维基百科中文语料 https:/ ...
- springboot2.0+Neo4j+d3.js构建知识图谱
Welcome to the Neo4j wiki! 初衷这是一个知识图谱构建工具,最开始是对产品和领导为了做ppt临时要求配合做图谱展示的不厌其烦,做着做着就抽出一个目前看着还算通用的小工具 技术栈 ...
- Redis闲谈(1):构建知识图谱
场景:Redis面试 (图片来源于网络) 面试官: 我看到你的简历上说你熟练使用Redis,那么你讲一下Redis是干嘛用的? 小明: (心中窃喜,Redis不就是缓存吗?)Redis主要用作缓存,通 ...
- Windows下基于python3使用word2vec训练中文维基百科语料(三)
对前两篇获取到的词向量模型进行使用: 代码如下: import gensim model = gensim.models.Word2Vec.load('wiki.zh.text.model') fla ...
- JWPL工具处理维基百科wikipedia数据用于NLP
JWPL处理维基百科数据用于NLP 处理zhwiki JWPL是一个Wikipedia处理工具,主要功能是将Wikipedia dump的文件经过处理.优化导入mysql数据库,用于NLP过程.以下以 ...
- wikipedia 维基百科 语料 获取 与 提取 处理 by python3.5
英文维基百科 https://dumps.wikimedia.org/enwiki/ 中文维基百科 https://dumps.wikimedia.org/zhwiki/ 全部语言的列表 https: ...
- 使用JWPL (Java Wikipedia Library)操作维基百科数据
使用JWPL (Java Wikipedia Library)操作维基百科数据 1. JWPL介绍 JWPL(Java Wikipedia Library)是一个开源的访问wikipeida数据的Ja ...
随机推荐
- 从头学pytorch(十九):批量归一化batch normalization
批量归一化 论文地址:https://arxiv.org/abs/1502.03167 批量归一化基本上是现在模型的标配了. 说实在的,到今天我也没搞明白batch normalize能够使得模型训练 ...
- oracle的一些简单语法
1.创建主键自增: --创建序列 create sequence seq_tb_user minvalue nomaxvalue start with increment by nocycle --一 ...
- 数学基础系列(六)----特征值分解和奇异值分解(SVD)
一.介绍 特征值和奇异值在大部分人的印象中,往往是停留在纯粹的数学计算中.而且线性代数或者矩阵论里面,也很少讲任何跟特征值与奇异值有关的应用背景. 奇异值分解是一个有着很明显的物理意义的一种方法,它可 ...
- Java入门 - 语言基础 - 21.Scanner类
原文地址:http://www.work100.net/training/java-scanner.html 更多教程:光束云 - 免费课程 Scanner类 序号 文内章节 视频 1 概述 2 使用 ...
- 利用Springmvc的AbstractXlsxView下载Excel文件
设计一个模型,在针对多中数据类型进行拓展 public abstract class ExcelView extends AbstractXlsxView { public CellStyle cel ...
- Spring(三)核心容器 - ApplicationContext 上下文启动准备
目录 前言 正文 第一步:prepareRefresh 第二步:obtainFreshBeanFactory 第三步:prepareBeanFactory 第四步:postProcessBeanFac ...
- 机器学习-Tensorflow之Tensor和Dataset学习
好了,咱们今天终于进入了现阶段机器学习领域内最流行的一个框架啦——TensorFlow.对的,这款由谷歌开发的机器学习框架非常的简单易用并且得到了几乎所有主流的认可,谷歌为了推广它的这个框架甚至单独开 ...
- Ubuntu16手动安装OpenStack
记录大佬的博客全文转载于https://www.voidking.com/dev-ubuntu16-manual-openstack-env/ 前言 <Ubuntu16安装OpenStack&g ...
- Maven的学习之路1
对于下列这段Maven的命令行有不懂之处,在zgmzyr的博客上得到了解释.非常感谢这位博友,写在自己的随笔上以便查看和修改. 1. 创建项目 $ mvn archetype:generate -Dg ...
- 深入理解Java 中SPI 制
深入理解Java 中SPI 制 概述 SPI(Service Provider Interface),是JDK内置的一种服务提供发现机制,可以用来启用框架扩展和替换组件,主要是被框架的开发人员使用,比 ...