
Spark学习之路(七)—— 基于ZooKeeper搭建Spark高可用集群
一、集群规划
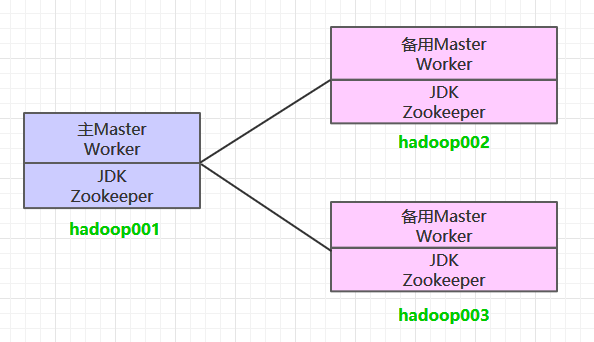
这里搭建一个3节点的Spark集群,其中三台主机上均部署Worker服务。同时为了保证高可用,除了在hadoop001上部署主Master服务外,还在hadoop002和hadoop003上分别部署备用的Master服务,Master服务由Zookeeper集群进行协调管理,如果主Master不可用,则备用Master会成为新的主Master。
二、前置条件
搭建Spark集群前,需要保证JDK环境、Zookeeper集群和Hadoop集群已经搭建,相关步骤可以参阅:
三、Spark集群搭建
3.1 下载解压
下载所需版本的Spark,官网下载地址:http://spark.apache.org/downloads.html
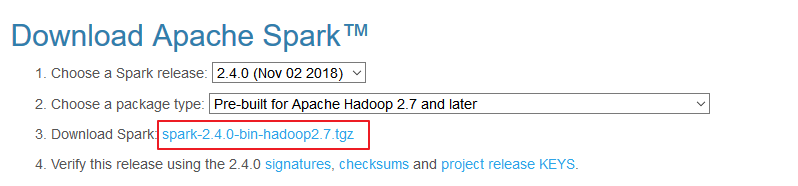
下载后进行解压:
# tar -zxvf spark-2.2.3-bin-hadoop2.6.tgz
3.2 配置环境变量
# vim /etc/profile
添加环境变量:
export SPARK_HOME=/usr/app/spark-2.2.3-bin-hadoop2.6
export  PATH=${SPARK_HOME}/bin:$PATH
使得配置的环境变量立即生效:
# source /etc/profile
3.3 集群配置
进入${SPARK_HOME}/conf目录,拷贝配置样本进行修改:
1. spark-env.sh
cp spark-env.sh.template spark-env.sh
# 配置JDK安装位置
JAVA_HOME=/usr/java/jdk1.8.0_201
# 配置hadoop配置文件的位置
HADOOP_CONF_DIR=/usr/app/hadoop-2.6.0-cdh5.15.2/etc/hadoop
# 配置zookeeper地址
SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=hadoop001:2181,hadoop002:2181,hadoop003:2181 -Dspark.deploy.zookeeper.dir=/spark"
2. slaves
cp slaves.template slaves
配置所有Woker节点的位置:
hadoop001
hadoop002
hadoop003
3.4 安装包分发
将Spark的安装包分发到其他服务器,分发后建议在这两台服务器上也配置一下Spark的环境变量。
scp -r /usr/app/spark-2.4.0-bin-hadoop2.6/   hadoop002:usr/app/
scp -r /usr/app/spark-2.4.0-bin-hadoop2.6/   hadoop003:usr/app/
四、启动集群
4.1 启动ZooKeeper集群
分别到三台服务器上启动ZooKeeper服务:
zkServer.sh start
4.2 启动Hadoop集群
# 启动dfs服务
start-dfs.sh
# 启动yarn服务
start-yarn.sh
4.3 启动Spark集群
进入hadoop001的${SPARK_HOME}/sbin目录下,执行下面命令启动集群。执行命令后,会在hadoop001上启动Maser服务,会在slaves配置文件中配置的所有节点上启动Worker服务。
start-all.sh
分别在hadoop002和hadoop003上执行下面的命令,启动备用的Master服务:
# ${SPARK_HOME}/sbin 下执行
start-master.sh
4.4 查看服务
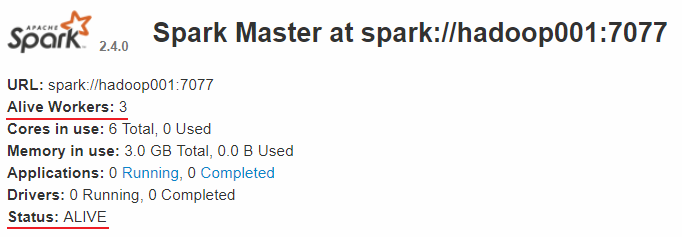
查看Spark的Web-UI页面,端口为8080。此时可以看到hadoop001上的Master节点处于ALIVE状态,并有3个可用的Worker节点。
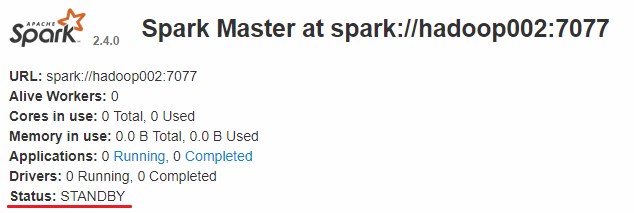
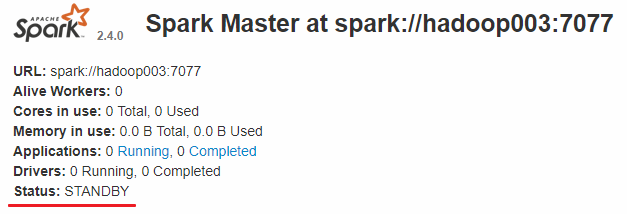
而hadoop002和hadoop003上的Master节点均处于STANDBY状态,没有可用的Worker节点。
五、验证集群高可用
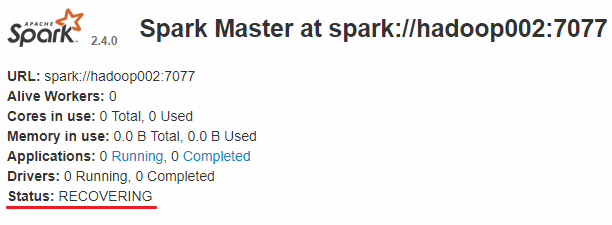
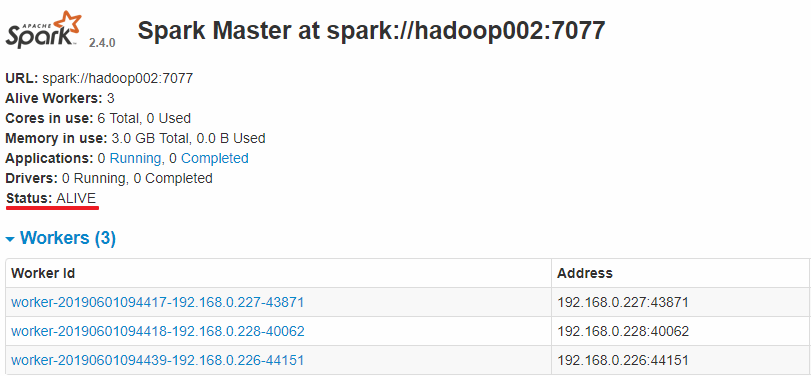
此时可以使用kill命令杀死hadoop001上的Master进程,此时备用Master会中会有一个再次成为主Master,我这里是hadoop002,可以看到hadoop2上的Master经过RECOVERING后成为了新的主Master,并且获得了全部可以用的Workers。
Hadoop002上的Master成为主Master,并获得了全部可以用的Workers。
此时如果你再在hadoop001上使用start-master.sh启动Master服务,那么其会作为备用Master存在。
六、提交作业
和单机环境下的提交到Yarn上的命令完全一致,这里以Spark内置的计算Pi的样例程序为例,提交命令如下:
spark-submit \
--class org.apache.spark.examples.SparkPi \
--master yarn \
--deploy-mode client \
--executor-memory 1G \
--num-executors 10 \
/usr/app/spark-2.4.0-bin-hadoop2.6/examples/jars/spark-examples_2.11-2.4.0.jar \
100
更多大数据系列文章可以参见个人 GitHub 开源项目: 程序员大数据入门指南
Spark学习之路(七)—— 基于ZooKeeper搭建Spark高可用集群的更多相关文章
- Hadoop 学习之路(八)—— 基于ZooKeeper搭建Hadoop高可用集群
一.高可用简介 Hadoop 高可用 (High Availability) 分为 HDFS 高可用和 YARN 高可用,两者的实现基本类似,但 HDFS NameNode 对数据存储及其一致性的要求 ...
- Kafka 学习之路(二)—— 基于ZooKeeper搭建Kafka高可用集群
一.Zookeeper集群搭建 为保证集群高可用,Zookeeper集群的节点数最好是奇数,最少有三个节点,所以这里搭建一个三个节点的集群. 1.1 下载 & 解压 下载对应版本Zookeep ...
- 基于 ZooKeeper 搭建 Hadoop 高可用集群
一.高可用简介 二.集群规划 三.前置条件 四.集群配置 五.启动集群 六.查看集群 七.集群的二次启动 一.高可用简介 Hadoop 高可用 (High Availability) 分为 HDFS ...
- Hadoop 系列(八)—— 基于 ZooKeeper 搭建 Hadoop 高可用集群
一.高可用简介 Hadoop 高可用 (High Availability) 分为 HDFS 高可用和 YARN 高可用,两者的实现基本类似,但 HDFS NameNode 对数据存储及其一致性的要求 ...
- Kafka —— 基于 ZooKeeper 搭建 Kafka 高可用集群
一.Zookeeper集群搭建 为保证集群高可用,Zookeeper集群的节点数最好是奇数,最少有三个节点,所以这里搭建一个三个节点的集群. 1.1 下载 & 解压 下载对应版本Zookeep ...
- Kafka 系列(二)—— 基于 ZooKeeper 搭建 Kafka 高可用集群
一.Zookeeper集群搭建 为保证集群高可用,Zookeeper 集群的节点数最好是奇数,最少有三个节点,所以这里搭建一个三个节点的集群. 1.1 下载 & 解压 下载对应版本 Zooke ...
- 入门大数据---基于Zookeeper搭建Kafka高可用集群
一.Zookeeper集群搭建 为保证集群高可用,Zookeeper 集群的节点数最好是奇数,最少有三个节点,所以这里搭建一个三个节点的集群. 1.1 下载 & 解压 下载对应版本 Zooke ...
- 基于keepalived搭建MySQL高可用集群
MySQL的高可用方案一般有如下几种: keepalived+双主,MHA,MMM,Heartbeat+DRBD,PXC,Galera Cluster 比较常用的是keepalived+双主,MHA和 ...
- 基于Docker-compose搭建Redis高可用集群-哨兵模式(Redis-Sentinel)
原文转载自「刘悦的技术博客」https://v3u.cn/a_id_110 我们知道,Redis的集群方案大致有三种:1)redis cluster集群方案:2)master/slave主从方案:3) ...
- 基于docker实现redis高可用集群
基于docker实现redis高可用集群 yls 2019-9-20 简介 基于docker和docker-compose 使用redis集群和sentinel集群,达到redis高可用,为缓存做铺垫 ...
随机推荐
- 在动态THML语句中调用JS函数传递带空格参数的问题
刚刚遇到一个问题,调用js函数的参数里带空格,造成调用失败的问题. 部分代码如下: html+="<div><a href=javascript:confirm(&qu ...
- .net core下,Ocelot网关与Spring Cloud Gateway网关的对比测试
有感于 myzony 发布的 针对 Ocelot 网关的性能测试 ,并且公司下一步也需要对.net和java的应用做一定的整合,于是对Ocelot网关.Spring Cloud Gateway网关做个 ...
- 简述WPF中的画刷(Brush)
原文:简述WPF中的画刷(Brush) -------------------------------------------------------------------------------- ...
- JS 实现Map
function Map() { this.arr = new Array(); var struct = function(key, value) { this.key = key; this.va ...
- matlab 基础知识class < superclass_name
matlab中的class,在matlab中也能够通过创建类的方式实现面向对象编程. 1)类定义 >> classdef (attribute1 = value,...) classnam ...
- WPF编游戏系列 之三 物品清单
原文:WPF编游戏系列 之三 物品清单 本篇将介绍如何通过C#自动生成游戏界面,主要演示点击"My Shop"后如何显示所有物品清单.其中数据源来自于Access 2 ...
- Boost的某些库还是需要生成二进制的库的,必须安装才行,以及使用库的方法
头文件就是库使用者最常问的问题就是“我该怎么安装Boost”,这个也是我一开始最关心的问题,Boost这点做的很好,将大部分实现都封装在头文件里,所以对于一些基本的Boost库,其实是不需要安装的,只 ...
- 利用winIO3.0进行windows10 64bit端口读取
一.winIO介绍 WinIO程序库允许在32位的Windows应用程序中直接对I/O端口和物理内存进行存取操作.通过使用一种内核模式的设备驱动器和其它几种底层编程技巧,它绕过了Windows系统的保 ...
- C#:foreach语句,yield语句
原文:C#:foreach语句,yield语句 1. foreach语句 C#编译器会把foreach语句转换为IEnumerable接口的方法和属性. foreach (Person p in pe ...
- 谷歌将为 Mac 和 Windows 用户推出新的备份和同步应用
据报道,谷歌将于 6 月 28 日面向 Mac 和 Windows 用户发布一款新的备份和同步应用(Backup and Sync app). Google 刚刚宣布将推出其备份和同步应用程序,该工具 ...