
Pytorch多卡训练
前一篇博客利用Pytorch手动实现了LeNet-5,因为在训练的时候,机器上的两张卡只用到了一张,所以就想怎么同时利用起两张显卡来训练我们的网络,当然LeNet这种层数比较低而且用到的数据集比较少的神经网络是没有必要两张卡来训练的,这里只是研究怎么调用两张卡。
现有方法
在网络上查找了多卡训练的方法,总结起来就是三种:
- nn.DataParallel
- pytorch-encoding
- distributedDataparallel
第一种方法是pytorch自带的多卡训练的方法,但是从方法的名字也可以看出,它并不是完全的并行计算,只是数据在两张卡上并行计算,模型的保存和Loss的计算都是集中在几张卡中的一张上面,这也导致了用这种方法两张卡的显存占用会不一致。
第二种方法是别人开发的第三方包,它解决了Loss的计算不并行的问题,除此之外还包含了很多其他好用的方法,这里放出它的GitHub链接有兴趣的同学可以去看看。
第三种方法是这几种方法最复杂的一种,对于该方法来说,每个GPU都会对自己分配到的数据进行求导计算,然后将结果传递给下一个GPU,这与DataParallel将所有数据汇聚到一个GPU求导,计算Loss和更新参数不同。
这里我先选择了第一个方法进行并行的计算
并行计算相关代码
首先需要检测机器上是否有多张显卡
USE_MULTI_GPU = True

# 检测机器是否有多张显卡

if USE_MULTI_GPU and torch.cuda.device_count() > 1:

    MULTI_GPU = True

    os.environ["CUDA_DEVICE_ORDER"] = "PCI_BUS_ID"

    os.environ["CUDA_VISIBLE_DEVICES"] = "0, 1"

    device_ids = [0, 1]

else:

    MULTI_GPU = False

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
其中os.environ["CUDA_VISIBLE_DEVICES"] = "0, 1"是将机器中的GPU进行编号
接下来就是读取模型了
net = LeNet()

if MULTI_GPU:

    net = nn.DataParallel(net,device_ids=device_ids)

net.to(device)
这里与单卡的区别就是多了nn.DataParallel这一步操作
接下来是optimizer和scheduler的定义
optimizer=optim.Adam(net.parameters(), lr=1e-3)

scheduler = StepLR(optimizer, step_size=100, gamma=0.1)

if MULTI_GPU:

    optimizer = nn.DataParallel(optimizer, device_ids=device_ids)

    scheduler = nn.DataParallel(scheduler, device_ids=device_ids)
因为optimizer和scheduler的定义发送了变化,所以在后期调用的时候也有所不同
比如读取learning rate的一段代码:
optimizer.state_dict()['param_groups'][0]['lr']
现在就变成了
optimizer.module.state_dict()['param_groups'][0]['lr']
详细的代码可以在我的GitHub仓库看到
开始训练
训练过程与单卡一样,这里就展示两张卡的占用情况
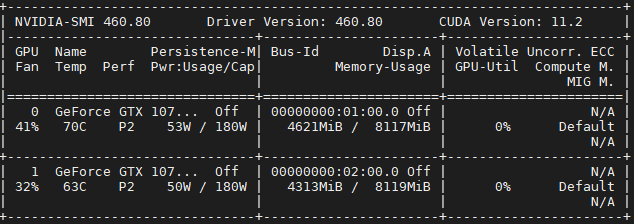
可以看到两张卡都有占用,这说明我们的代码起了作用,但是也可以看到,两张卡的占用有明显的区别,这就是前面说到的DataParallel只是在数据上并行了,在loss计算等操作上并没有并行
最后
如果文章那里有错误和建议,都可以向往指出
Pytorch多卡训练的更多相关文章
- Pytorch使用分布式训练,单机多卡
pytorch的并行分为模型并行.数据并行 左侧模型并行:是网络太大,一张卡存不了,那么拆分,然后进行模型并行训练. 右侧数据并行:多个显卡同时采用数据训练网络的副本. 一.模型并行 二.数据并行 数 ...
- 使用Pytorch进行多卡训练
当一块GPU不够用时,我们就需要使用多卡进行并行训练.其中多卡并行可分为数据并行和模型并行.具体区别如下图所示: 由于模型并行比较少用,这里只对数据并行进行记录.对于pytorch,有两种方式可以进行 ...
- Pytorch多GPU训练
Pytorch多GPU训练 临近放假, 服务器上的GPU好多空闲, 博主顺便研究了一下如何用多卡同时训练 原理 多卡训练的基本过程 首先把模型加载到一个主设备 把模型只读复制到多个设备 把大的batc ...
- 计图(Jittor) 1.1版本:新增骨干网络、JIT功能升级、支持多卡训练
计图(Jittor) 1.1版本:新增骨干网络.JIT功能升级.支持多卡训练 深度学习框架-计图(Jittor),Jittor的新版本V1.1上线了.主要变化包括: 增加了大量骨干网络的支持,增强了辅 ...
- pytorch 多GPU训练总结(DataParallel的使用)
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/weixin_40087578/artic ...
- pytorch: 准备、训练和测试自己的图片数据
大部分的pytorch入门教程,都是使用torchvision里面的数据进行训练和测试.如果我们是自己的图片数据,又该怎么做呢? 一.我的数据 我在学习的时候,使用的是fashion-mnist.这个 ...
- AMD cpu 下 Pytorch 多卡并行卡死问题解决
dataparallel not working on nvidia gpus and amd cpus https://github.com/pytorch/pytorch/issues/130 ...
- pytorch版yolov3训练自己数据集
目录 1. 环境搭建 2. 数据集构建 3. 训练模型 4. 测试模型 5. 评估模型 6. 可视化 7. 高级进阶-网络结构更改 1. 环境搭建 将github库download下来. git cl ...
- PyTorch Tutorials 4 训练一个分类器
%matplotlib inline 训练一个分类器 上一讲中已经看到如何去定义一个神经网络,计算损失值和更新网络的权重. 你现在可能在想下一步. 关于数据? 一般情况下处理图像.文本.音频和视频数据 ...
随机推荐
- effective解读-第八条 避免使用finalizer和Cleaner
java9之前finalizer,java9使用cleaner代替了finalizer.相比finalizer,cleaner(它存在于一个独立类Cleaner中,需要时候注入到对应类中即可)不会污染 ...
- java例题_21 求 1+2!+3!+...+20!的和
1 /*21 [程序 21 求阶乘] 2 题目:求 1+2!+3!+...+20!的和 3 程序分析:此程序只是把累加变成了累乘. 4 */ 5 6 /*分析 7 * 1.汲取上一题的教训,这么大的数 ...
- 计算机体系结构——CH1基本概念
CH1基本概念 右键点击查看图像,查看清晰图像 CH1基本概念 目的与内容 了解计算机系统的完整概念 学习计算机系统的分析方法与设计方法 编写程序所必需了解的计算机属性 计算机系统结构简介 为什么要研 ...
- 全网最值得推荐的ELKB日志学习博客-博客地址留存
博客地址:https://elasticstack.blog.csdn.net/article/details/102728604 博客地址留存,后续解决疑难问题
- [矩阵乘法]裴波拉契数列II
[ 矩 阵 乘 法 ] 裴 波 拉 契 数 列 I I [矩阵乘法]裴波拉契数列II [矩阵乘法]裴波拉契数列II Description 形如 1 1 2 3 5 8 13 21 34 55 89 ...
- 201871030105-陈啟程 实验三 结对项目—《D{0-1}KP 实例数据集算法实验平台》项目报告
项目 内容 课程班级博客 https://edu.cnblogs.com/campus/xbsf/2018CST 这个作业要求链接 https://www.cnblogs.com/nwnu-daizh ...
- OO第四单元——基于UML的UML解析器总结&OO课程总结
OO第四单元--基于UML的UML解析器总结&OO课程总结 前言:一学期愉快(痛苦)的OO课程学习结束了,OO几个单元作业都各有特色,实验也各有特色,仔细回味起来,不再是单纯的敲代码(但自己还 ...
- MySQL提升笔记(4)InnoDB存储结构
这一节本来计划开始索引的学习,但是在InnoDB存储引擎的索引里,存在一些数据存储结构的概念,这一节先了解一下InnodDB的逻辑存储结构,为索引的学习打好基础. 从InnoDB存储引擎的存储结构看, ...
- 1.设置和验证MySQL数据库的隔离级别
登录数据库 mysql -u root - p 新建用户,各启动一个事物,用于同时操作数据库表中数据 create user tom identified by 'tom'; 然后同时再用该用户启动M ...
- Day10_48_Map集合中的常用方法
Map集合中的常用方法 * 常用方法 - 注意 Map集合中的key是无序不可重复的set集合,如果添加数据时,key值重复了,后面添加的重复数据也是可以添加成功的,但是会覆盖前面相同的数据. 1. ...