
Reinforcement Learning: An Introduction读书笔记(4)--动态规划
> 目 录 <
- Dynamic programming
- Policy Evaluation (Prediction)
- Policy Improvement
- Policy Iteration
- Value Iteration
- Asynchronous Dynamic Programming
- Generalized Policy Iteration
> 笔 记 <
Dynamic programming(DP)
定义:a collection of algorithms that can be used to compute optimal policies given a perfect model of the environment as a Markov decision process (MDP).
经典的DP算法处理RL problem的能力有限的原因:(1) 假设a perfect model with complete knowledge;(2) 巨大的计算开销
Policy Evaluation (Prediction)
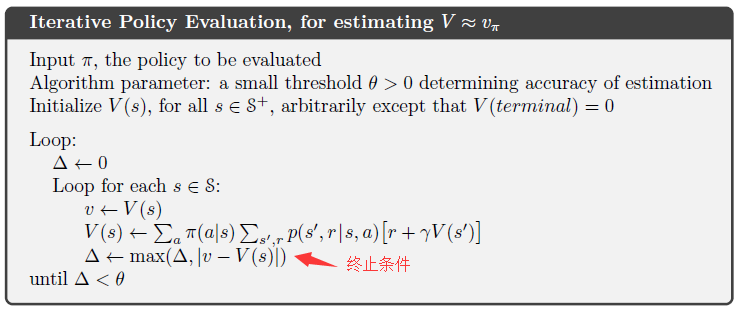
policy evaluation: the iterative computation of the state-value function $v_{\pi}$ for a given policy $\pi$.

用迭代=的方法实现评估: 旧的value = expected immediate rewards + 从后继states获得的values
这种更新操作叫做expected update,因为它基于所有可能的后继states的期望,而非单个next state sample。
存储方式:有two-array version(同时存储old和new value) 和 in-place algorithm(只存储new value)两种,通常采用后者,收敛的更快。
Policy Improvement
我们计算policy的价值函数的目的是希望能够帮助我们找到更好的policy。
Policy improvement theorem:
两个确定的策略$\pi$和$\pi'$,如果满足:
那么策略$\pi'$一定比$\pi$好or跟它一样好。因此,策略$\pi'$可以在所有state上得到更多or相等的expected return:
证明如下:
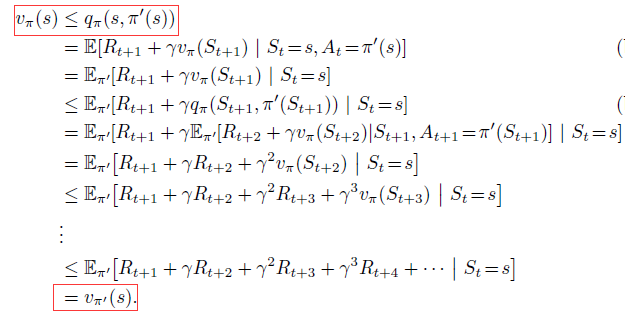
Policy improvement:
定义: Policy improvement refers to the computation of an improved policy given the value function for that policy.
相比原始策略$\pi$,如果我们在所有states上采用贪心算法来选择action,那么得到的新策略如下:
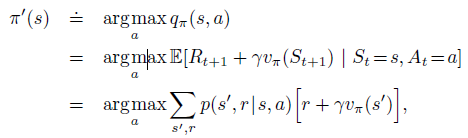
因为其满足policy improvement theorem的条件,所以新的greedy policy $\pi'$要比old policy更好。我们可以根据这一性质,不断地对policy进行改进,直到new policy和old policy一样好,即$v_{\pi}=v_{\pi'}$,此时对所有的states满足:
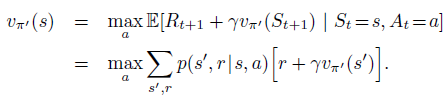
该式子正是Bellman optimality equation,因此$v_{\pi'}$一定是$\v_{*}$, 策略$\pi$和$\pi‘’$一定是最优策略。
Policy Iteration
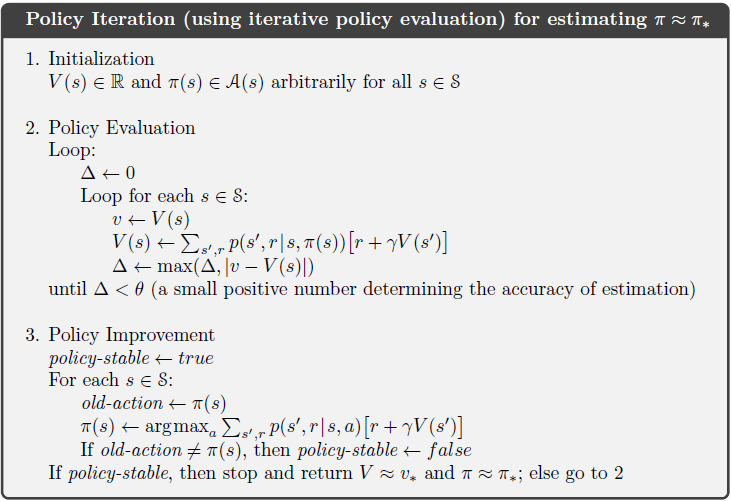
定义: 一种把policy evaluation和policy improvement结合在一起的常见的DP方法。
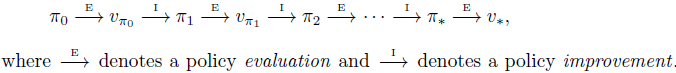
因为finite MDP只有有限数量的策略,因此最终总会在有限步数内收敛到一个optimal policy和optimal value function。
Value Iteration
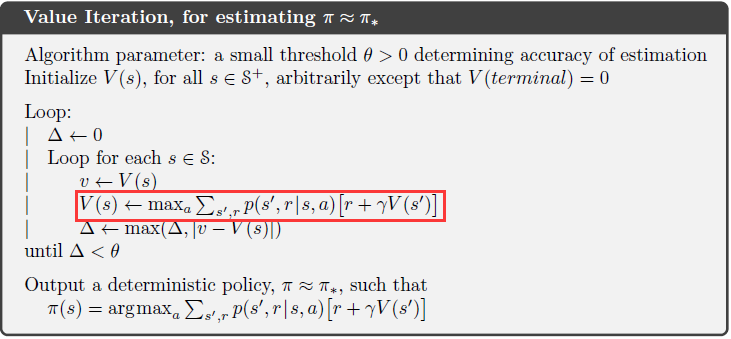
policy iteration的缺点:每一轮迭代都需要执行policy evaluation,而policy evaluation需要对state set扫描多次并且$\v_{\pi}$最终很久才能收敛。
改进方法:可否让policy evaluation早一些停止?value iteration不再等policy evaluation收敛,而是只对所有state扫描一次就停止。将policy evaluation和policy improvement的步骤同时进行:
Asynchronous Dynamic Programming
之前讨论的DP方法的缺点在于:需要对MDP中所有states进行扫描、操作,导致效率低下。
Asynchronous DP algorithms: 是in-place iterative DP algorithms,这类算法可以按照任意顺序更新state的value,并且不管其他states当前的value是何时更新的。
需要注意的是,avoiding state sweeps并不意味着我们可以减少计算量,其好处是(1) 可以让我们尽快利用更新后的value来提升policy,并且减少更新那些无用的states。(2)可以实时计算,所以可以实现iterative DP algorithm at the same time that agent is actually experiencing the MDP。agent经历可以用于决定更新那些states。
Generalized Policy Iteration
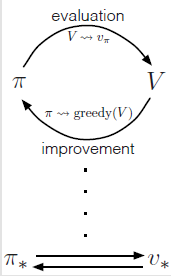
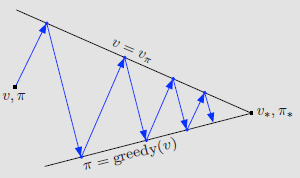
generalized policy iteration (GPI):policy-evaluation and policy-improvement processes interaction
Reinforcement Learning: An Introduction读书笔记(4)--动态规划的更多相关文章
- Reinforcement Learning: An Introduction读书笔记(3)--finite MDPs
> 目 录 < Agent–Environment Interface Goals and Rewards Returns and Episodes Policies and Val ...
- Reinforcement Learning: An Introduction读书笔记(1)--Introduction
> 目 录 < learning & intelligence 的基本思想 RL的定义.特点.四要素 与其他learning methods.evolutionary m ...
- Reinforcement Learning: An Introduction读书笔记(2)--多臂机
> 目 录 < k-armed bandit problem Incremental Implementation Tracking a Nonstationary Problem ...
- 《Machine Learning Yearing》读书笔记
——深度学习的建模.调参思路整合. 写在前面 最近偶尔从师兄那里获取到了吴恩达教授的新书<Machine Learning Yearing>(手稿),该书主要分享了神经网络建模.训练.调节 ...
- Machine Learning for hackers读书笔记(六)正则化:文本回归
data<-'F:\\learning\\ML_for_Hackers\\ML_for_Hackers-master\\06-Regularization\\data\\' ranks < ...
- 《算法导论》读书笔记之动态规划—最长公共子序列 & 最长公共子串(LCS)
From:http://my.oschina.net/leejun2005/blog/117167 1.先科普下最长公共子序列 & 最长公共子串的区别: 找两个字符串的最长公共子串,这个子串要 ...
- Machine Learning for hackers读书笔记(三)分类:垃圾邮件过滤
#定义函数,打开每一个文件,找到空行,将空行后的文本返回为一个字符串向量,该向量只有一个元素,就是空行之后的所有文本拼接之后的字符串 #很多邮件都包含了非ASCII字符,因此设为latin1就可以读取 ...
- Machine Learning for hackers读书笔记_一句很重要的话
为了培养一个机器学习领域专家那样的直觉,最好的办法就是,对你遇到的每一个机器学习问题,把所有的算法试个遍,直到有一天,你凭直觉就知道某些算法行不通.
- Machine Learning for hackers读书笔记(十二)模型比较
library('ggplot2')df <- read.csv('G:\\dataguru\\ML_for_Hackers\\ML_for_Hackers-master\\12-Model_C ...
随机推荐
- text-decoration:[ text-decoration-line ] || [ text-decoration-style ] || [ text-decoration-color ] 默认值:
css3中字体装饰,多样化的界面效果,: [ text-decoration-line ]:指定文本装饰的种类.相当于CSS2.1的 text-decoration 属性, 可取值:none | un ...
- Linux 比较判断运算(if else)
200 ? "200px" : this.width)!important;} --> 介绍 本篇文章主要是列举在shell命令中常出现的一些用来做比较的运算符,这些运算符是 ...
- [转]异常声音检测之kaldi DNN 训练
转自:http://blog.csdn.net/huchad/article/details/52092796 使用kaldi的DNN做音频分类,异常声音检测. HMM/GMM -> HMM/D ...
- Numpy学习二:数组的索引与切片
1.一维数组索引与切片#创建一维数组arr1d = np.arange(10)print(arr1d) 结果:[0 1 2 3 4 5 6 7 8 9] #数组的索引从0开始,通过索引获取第三个元素a ...
- Java思维理清思路
Java思维导图 学习方法: 针对性学习 引导式学习 对比式学习 总结式学习 Java简介: 简单性,面向对象,分布式,健壮性,安全性,平台独立与可移植性,多线程,多态性等. Java三大体系:Jav ...
- dom4j 解析XML文件
<?xml version="1.0" encoding="UTF-8"?> <!-- 手机的根节点 --> <Phones> ...
- 产品经理聊产品--mac book pro 2018 初体验
工作前几年,使用电脑,基本上都是微软的操作系统,自从从大厂出来之后,才逐渐熟悉使用linux,到现在基本上都是基本上一个月windows平台基本不需要开机就可以,可以说基本上被ubuntu的简洁和实用 ...
- 简单的ld链接脚本学习
一. 链接脚本的整体认识 什么是链接文件呢?作用是什么呢? 当编写了多个C文件时,我们将他们编译链接成一个可执行的文件,此时就需要用到链接脚本文件(ld).ld脚本主要功能就是:将多个目标文件(.o) ...
- Kubernetes 笔记 01 初识 Kubernetes 新时代的领航者
本文首发于我的公众号 Linux云计算网络(id: cloud_dev),专注于干货分享,号内有 10T 书籍和视频资源,后台回复「1024」即可领取,欢迎大家关注,二维码文末可以扫. 大明王朝时期, ...
- hbaes之createTable执行流程
hbase的客户端代码并不想hive一样用java编写,shell调用,而是使用ruby编写. 在admin.rb文件中方法create,其中接受两个参数,其中第二个参数类型为变长参数. 而在crea ...