
【Hadoop离线基础总结】Hue与Hadoop集成
目录
1.更改所有hadoop节点的core-site.xml配置
cd /export/servers/hadoop-2.6.0-cdh5.14.0/etc/hadoop/
vim core-site.xml
添加以下配置<property>
<name>hadoop.proxyuser.root.hosts</name>
<value>*</value>
</property>
<property>
<name>hadoop.proxyuser.root.groups</name>
<value>*</value>
</property>
发送到node02,node03
scp core-site.xml node02:$PWD

scp core-site.xml node03:$PWD
2.更改所有hadoop节点的hdfs-site.xml
vim hdfs-site.xml
添加以下配置<property>
<name>dfs.webhdfs.enabled</name>
<value>true</value>
</property>
发送到node02,node03
scp hdfs-site.xml node02:$PWD

scp hdfs-site.xml node03:$PWD
3.重启hadoop集群
在node01执行
cd /export/servers/hadoop-2.6.0-cdh5.14.0

sbin/stop-dfs.sh

sbin/start-dfs.sh

sbin/stop-yarn.sh

sbin/start-yarn.sh
4.停止hue的服务,并继续配置hue.ini
cd /export/servers/hue-3.9.0-cdh5.14.0/desktop/conf

vim hue.ini		最好别用vim编辑
配置hue与hdfs集成
[[hdfs_clusters]]

[[[default]]]

fs_defaultfs=hdfs://node01.hadoop.com:8020

webhdfs_url=http://node01.hadoop.com:50070/webhdfs/v1

hadoop_hdfs_home=/export/servers/hadoop-2.6.0-cdh5.14.0			(前两行是修改,后三行是添加)

hadoop_bin=/export/servers/hadoop-2.6.0-cdh5.14.0/bin

hadoop_conf_dir=/export/servers/hadoop-2.6.0-cdh5.14.0/etc/hadoop
配置hue与yarn集成
[[yarn_clusters]]

[[[default]]]

resourcemanager_host=node01

resourcemanager_port=8032

submit_to=True

resourcemanager_api_url=http://node01:8088

history_server_api_url=http://node01:19888
启动hue进程,查看hadoop是否与Hue集成成功
cd /export/servers/hue-3.9.0-cdh5.14.0/

build/env/bin/supervisor
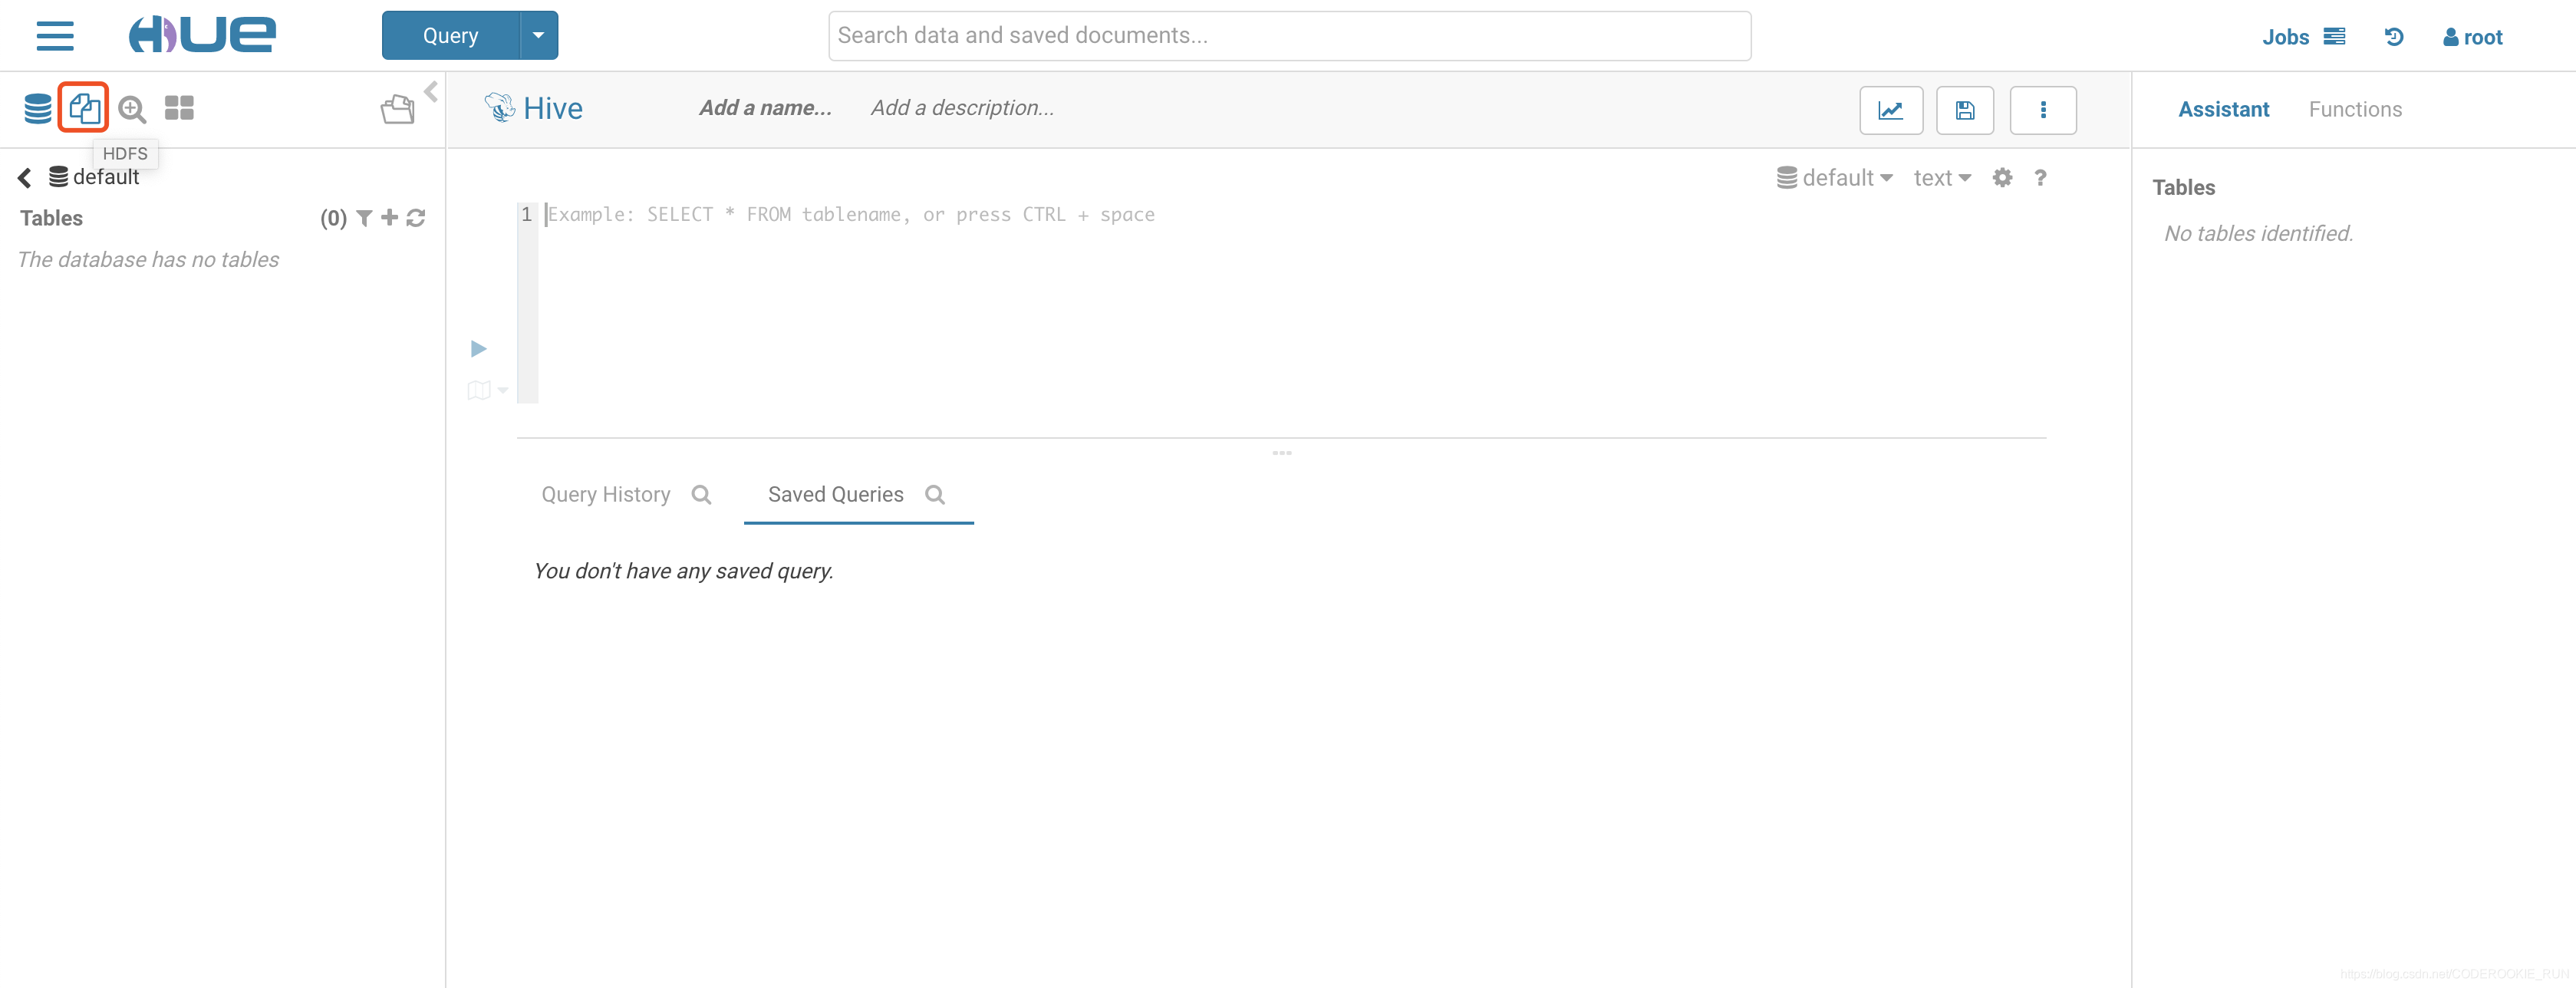
连接到web页面,显示如下图表示配置成功
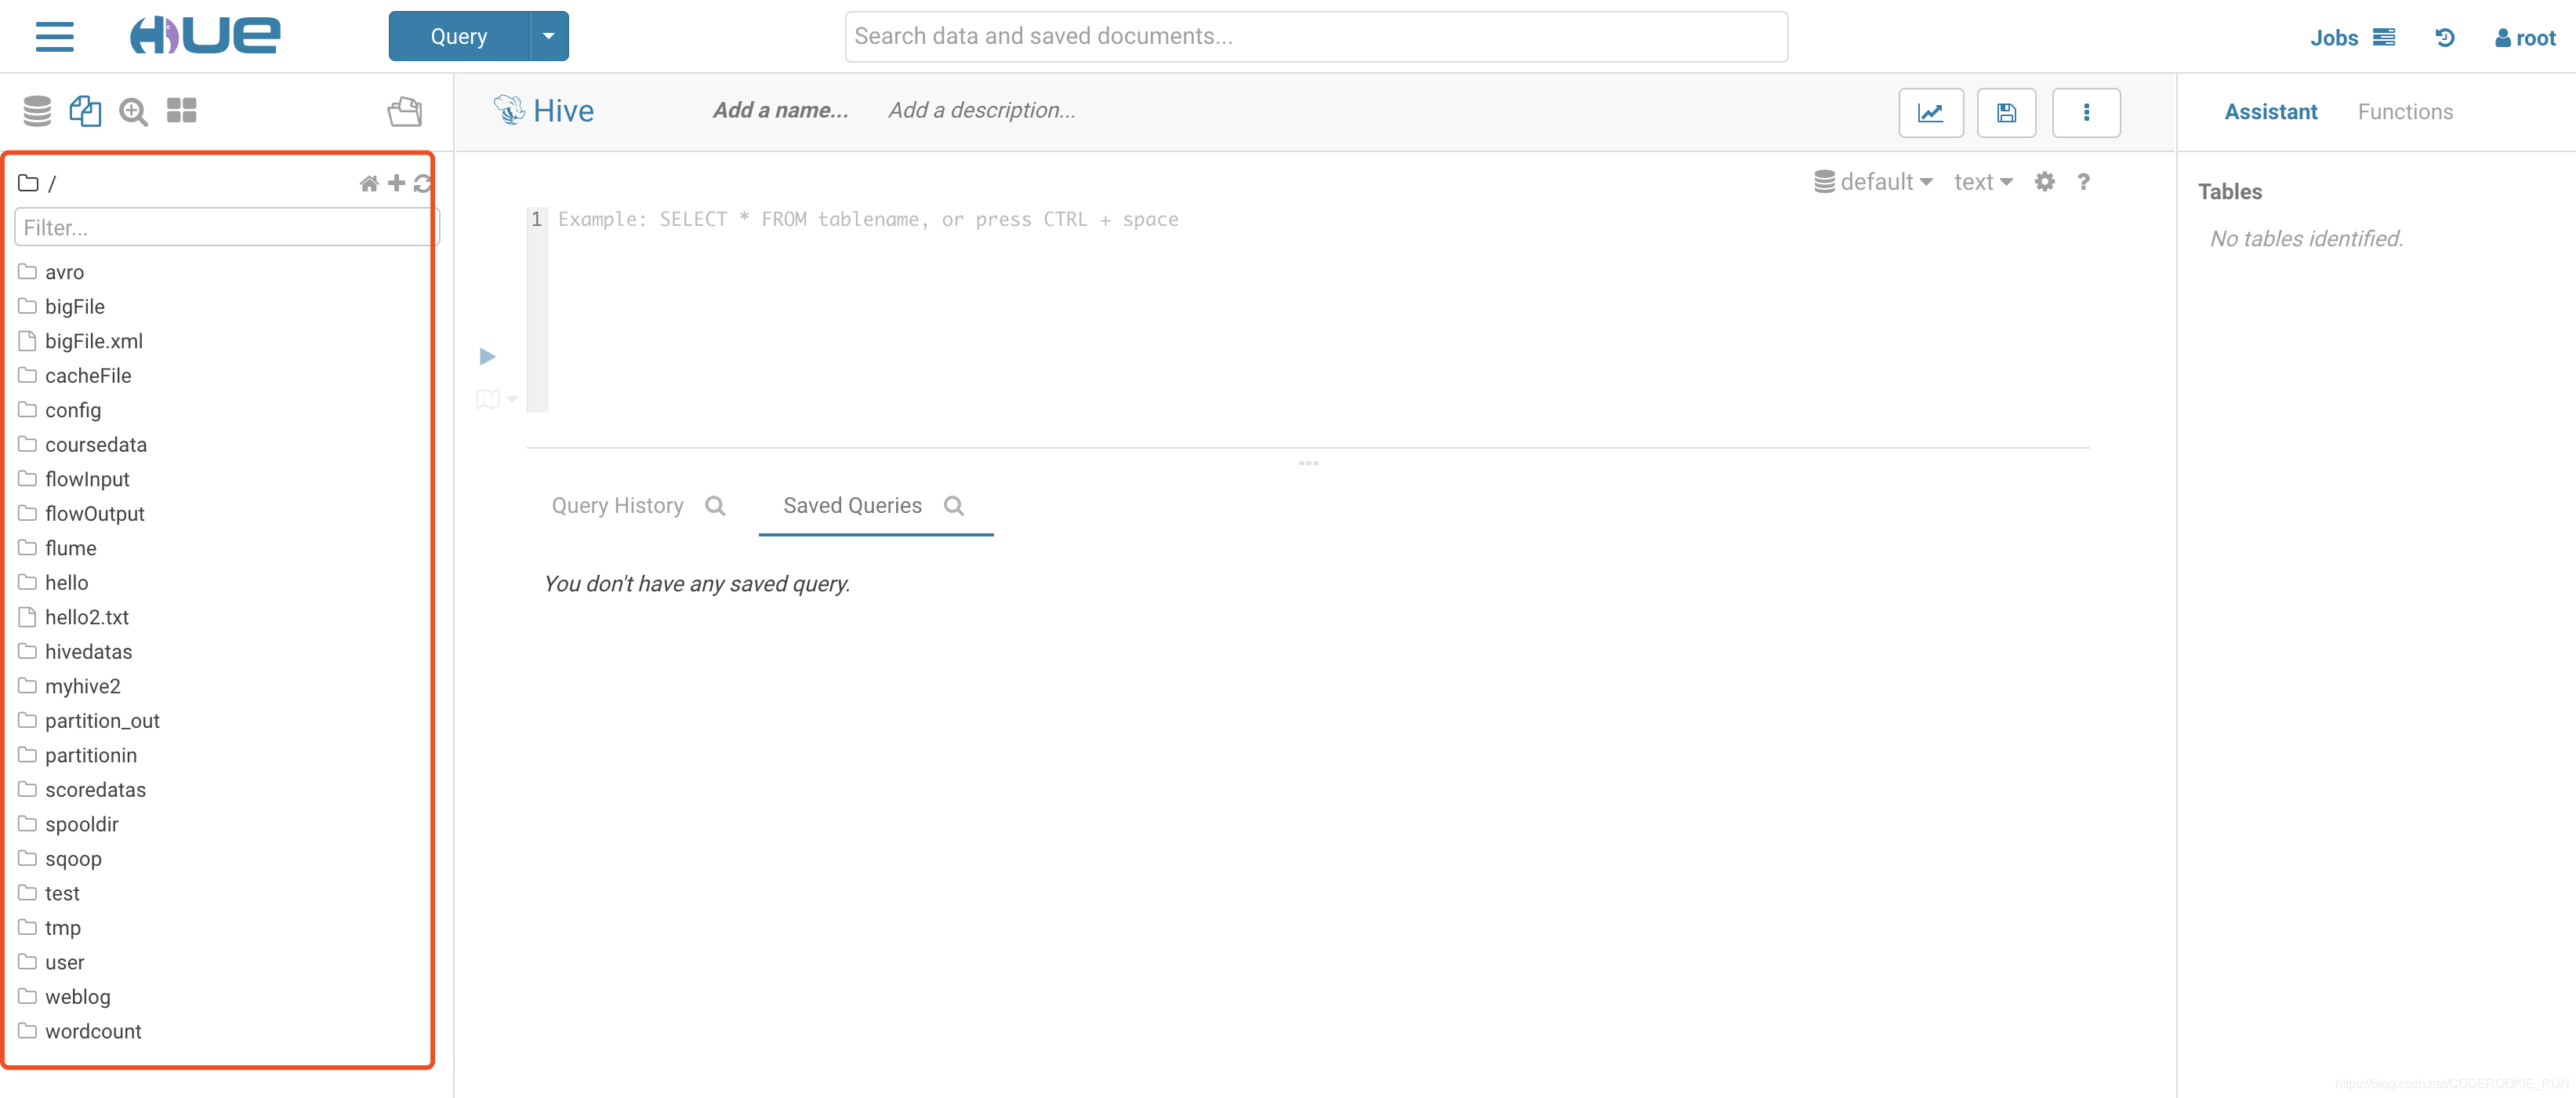
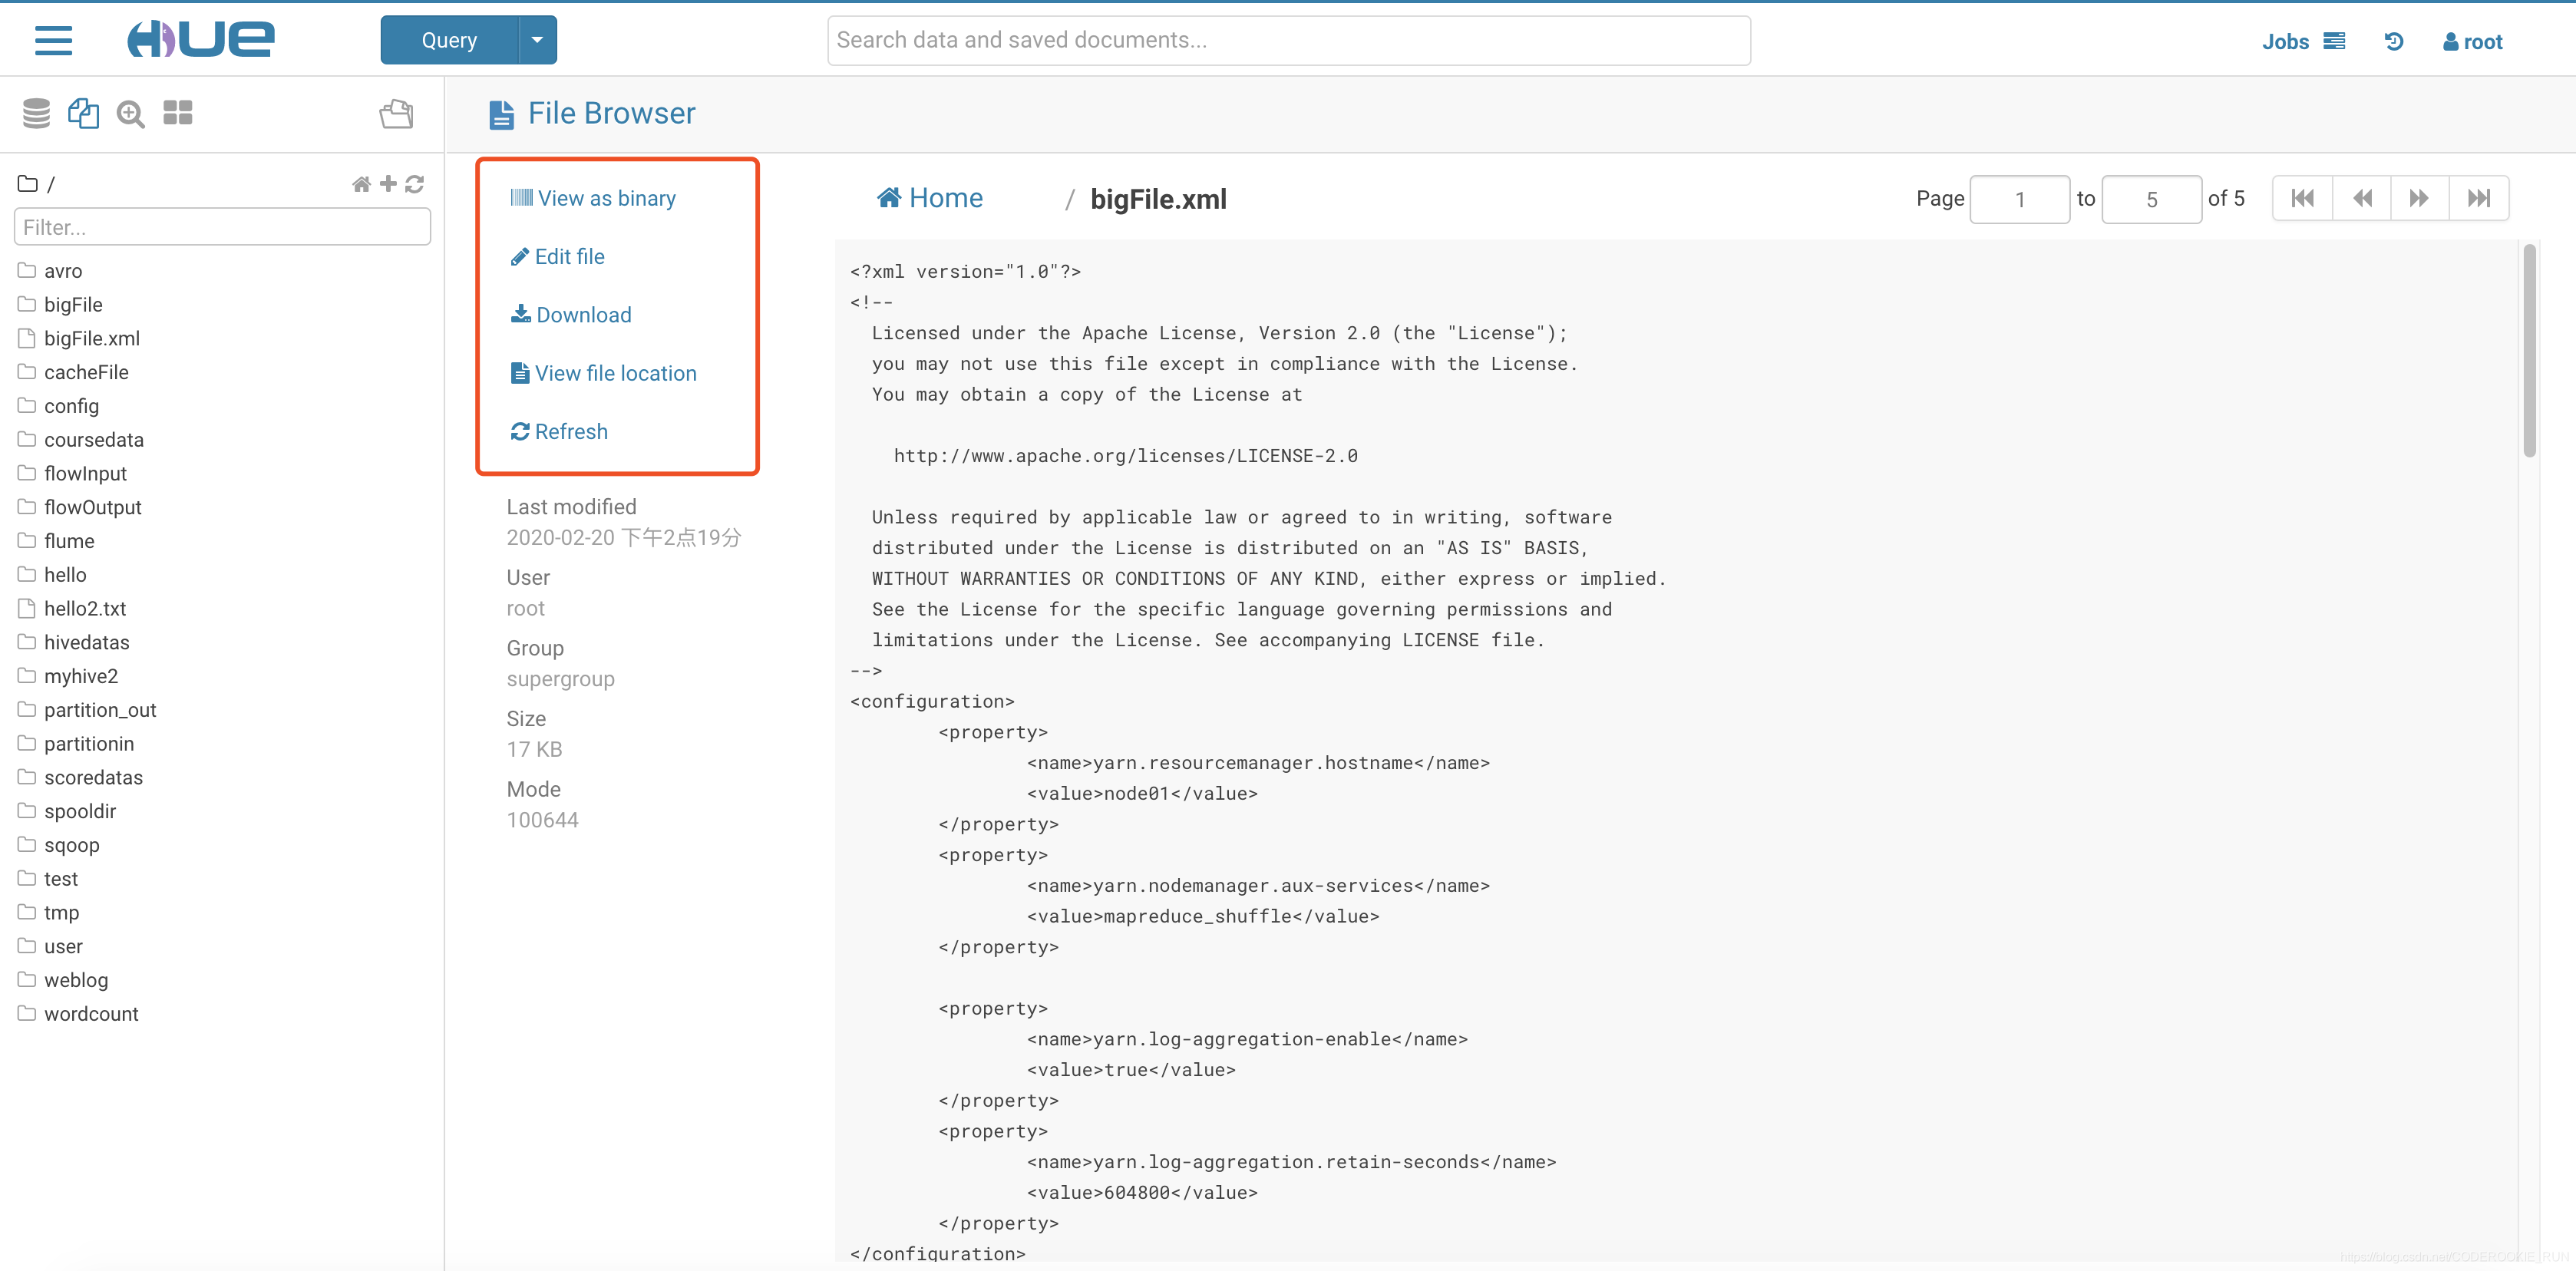
可以直接在网页对HDFS的文件进行操作
【Hadoop离线基础总结】Hue与Hadoop集成的更多相关文章
- 【Hadoop离线基础总结】Apache Hadoop的三种运行环境介绍及standAlone环境搭建
Apache Hadoop的三种运行环境介绍及standAlone环境搭建 三种运行环境 standAlone环境 单机版的hadoop运行环境 伪分布式环境 主节点都在一台机器上,从节点分开到其他机 ...
- 【Hadoop离线基础总结】Hue的简单介绍和安装部署
目录 Hue的简单介绍 概述 核心功能 安装部署 下载Hue的压缩包并上传到linux解压 编译安装启动 启动Hue进程 hue与其他框架的集成 Hue与Hadoop集成 Hue与Hive集成 Hue ...
- 【Hadoop离线基础总结】oozie的安装部署与使用
目录 简单介绍 概述 架构 安装部署 1.修改core-site.xml 2.上传oozie的安装包并解压 3.解压hadooplibs到与oozie平行的目录 4.创建libext目录,并拷贝依赖包 ...
- 【Hadoop离线基础总结】impala简单介绍及安装部署
目录 impala的简单介绍 概述 优点 缺点 impala和Hive的关系 impala如何和CDH一起工作 impala的架构及查询计划 impala/hive/spark 对比 impala的安 ...
- 【Hadoop离线基础总结】流量日志分析网站整体架构模块开发
目录 数据仓库设计 维度建模概述 维度建模的三种模式 本项目中数据仓库的设计 ETL开发 创建ODS层数据表 导入ODS层数据 生成ODS层明细宽表 统计分析开发 流量分析 受访分析 访客visit分 ...
- 【Hadoop离线基础总结】Sqoop常用命令及参数
目录 常用命令 常用公用参数 公用参数:数据库连接 公用参数:import 公用参数:export 公用参数:hive 常用命令&参数 从关系表导入--import 导出到关系表--expor ...
- 【Hadoop离线基础总结】Hive调优手段
Hive调优手段 最常用的调优手段 Fetch抓取 MapJoin 分区裁剪 列裁剪 控制map个数以及reduce个数 JVM重用 数据压缩 Fetch的抓取 出现原因 Hive中对某些情况的查询不 ...
- 【Hadoop离线基础总结】Hue与Mysql集成
Hue与Mysql集成 1.修改hue.ini配置文件 这里要去掉#,打开mysql注释,大概在1547行 [[[mysql]]] nice_name="My SQL DB" en ...
- 【Hadoop离线基础总结】Hue与Impala集成
Hue与Impala集成 1.修改hue.ini配置文件 [impala] server_host=node03 server_port=21050 impala_conf_dir=/etc/impa ...
随机推荐
- 在Python中该如何实现Java的重写与重载
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:清风python PS:如有需要Python学习资料的小伙伴可以加点击 ...
- Python 3.9 性能优化:更快的 list()、dict() 和 range() 等内置类型
Python 的 3.9.0 版本正在开发中,计划在 2020-10-05 发布 final 版本. 官方在 changelog 中披露了很多细节,其中有一项"vectorcall" ...
- scheduler_default_filters 详解
Filter scheduler 是 nova-scheduler 默认的调度器,调度过程分为两步: 通过过滤器(filter)选择满足条件的计算节点(运行 nova-compute) 通过权 ...
- Golang Map实现(一)
本文学习 Golang 的 Map 数据结构,以及map buckets 的数据组织结构. hash 表是什么 从大学的课本里面,我们学到:hash 表其实就是将key 通过hash算法映射到数组的某 ...
- 2019-2020-1 20199325《Linux内核原理与分析》第六周作业
正常的使用gdb跟踪分析函数调用 使用make rootfs命令 *用gdb跟踪分析一个系统调用内核函数 对于宏SAVE_ALL来说,这条语句会保存当前线程的现场,然后是执行system_call,跳 ...
- Windows挂载Gluster复制卷
本地挂载测试 mount -t glusterfs 127.0.0.1:/gv1 /mnt [root@gluster1 mnt]# df -h Filesystem Size Used Avail ...
- fedora 21下Virtual Box安装Windows XP SP3
Installing Virtual Box and Windows XP SP3 during Fedora 21 The first step:Download and Install Virtu ...
- java并发中的Synchronized关键词
文章目录 为什么要同步 Synchronized关键词 Synchronized Instance Methods Synchronized Static Methods Synchronized B ...
- Libra教程之:Libra protocol的逻辑数据模型
文章目录 Libra protocol简介 逻辑数据模型 账本状态 交易 账本历史 Libra protocol简介 Libra区块链本质上是一个加密数据库,这个数据库是通过Libra protoco ...
- CF1324 --- Maximum White Subtree
CF1324 --- Maximum White Subtree 题干 You are given a tree consisting of \(n\) vertices. A tree is a c ...