
Spark RDD概念学习系列之RDD的5大特点(五)
RDD的5大特点
1)有一个分片列表,就是能被切分,和Hadoop一样,能够切分的数据才能并行计算。
一组分片(partition),即数据集的基本组成单位,对于RDD来说,每个分片都会被一个计算任务处理,并决定并行计算的粒度。用户可以在创建RDD时指定RDD的分片个数,如果没有指定,那么就会采用默认值。默认值就是程序所分配到的CPU Core的数目。每个分配的存储是由BlockManager实现的,每个分区都会被逻辑映射成BlockManager的一个Block,而这个Block会被一个Task负责计算。
2)由一个函数计算每一个分片,这里指的是下面会提到的compute函数。
Spark中的RDD的计算是以分片为单位的,每个RDD都会实现compute函数以达到这个目的。compute函数会对迭代器进行复合,不需要保存每次计算的结果。
3)对其他RDD的依赖列表,依赖还具体分为宽依赖和窄依赖,但并不是所有的RDD都有依赖。
RDD的每次转换都会生成一个新的RDD,所以RDD之间就会形成类似于流水线一样的前后依赖关系。在部分分区数据丢失时,Spark可以通过这个依赖关系重新计算丢失的分区数据,而不是对RDD的所有分区进行重新计算。
4)可选:key-value型的RDD是根据哈希来分区的,类似于mapreduce当中的paritioner接口,控制Key分到哪个reduce。
一个partitioner,即RDD的分片函数。当前Spark中实现了两种类型的分片函数,一个是基于哈希的HashPartitioner,另外一个基于范围的RangePartitioner。只有对于key-value的RDD,才会有Partitioner,非key-value的RDD的Partitioner的值是None。Partitioner函数不但决定了RDD本身的分片数量,也决定了parent RDD Shuffle输出时的分片数量。
5)可选:每一分片的优先计算位置,比如HDFS的block的所在位置应该是优先计算的位置。
一个列表,存储存取每个Partition的优先位置(preferred location)。对于一个HDFS文件来说,这个列表保存的就是每个Partition所在的块的位置。按照“移动数据不如移动计算”的理念,Spark在进行任务调度的时候,会尽可能地将计算任务分配到其所要处理数据块的存储位置。
- 它是在集群节点上的不可变的、已分区的集合对象。
- 通过并行转换的方式来创建如(map, filter, join, etc)。
- 失败自动重建。
- 可以控制存储级别(内存、磁盘等)来进行重用。
- 必须是可序列化的。
- 是静态类型的。
进一步,说:
worker里有很多Excutor,真正完成计算的是Excutor,Excutor计算都是在内存进行计算,
Excutor里面有partitioner,partitioner里面的数据如果内存足够大的话放到内存中,它是一点一点读的。
RDD是分布式数据集,所说RDD就是这个。
RDD有5个特点:
1.a list of partiotioner有很多个partiotioner(这里有3个partiotioner),可以明确的说,一个分区在一台机器上,一个分区其实就是放在一台机器的内存上,一台机器上可以有多个分区。
2.a function for partiotioner一个函数作用在一个分区上。比如说一个分区有1,2,3 在rdd1.map(_*10),把RDD里面的每一个元素取出来乘以10,每个分片都应用这个map的函数。
3.RDD之间有一系列的依赖rdd1.map(_*10).flatMap(..).map(..).reduceByKey(...),构建成为DAG,这个DAG会构造成很多个阶段,这些阶段叫做stage,RDDstage之间会有依赖关系,后面根据前面的依赖关系来构建,如果前面的数据丢了,它会记住前面的依赖,从前面进行重新恢复。每一个算子都会产生新的RDD。textFile 与flatMap会产生两个RDD.
4.分区器hash & Integer.Max % partiotioner 决定数据到哪个分区里面,可选,这个RDD是key-value 的时候才能有
5.最佳位置。数据在哪台机器上,任务就启在哪个机器上,数据在本地上,不用走网络。不过数据进行最后汇总的时候就要走网络。(hdfs file的block块)
RDD有5个特点:
1、RDD是Spark提供的核心抽象,全称为Resillient Distributed Dataset,即弹性分布式数据集。
2、RDD在抽象上来说是一种元素集合,包含了数据。它是被分区的,分为多个分区,每个分区分布在集群中的不同节点上,从而让RDD中的数据可以被并行操作。(分布式数据集)
3、RDD通常通过Hadoop上的文件,即HDFS文件或者Hive表,来进行创建;有时也可以通过应用程序中的集合来创建。
4、RDD最重要的特性就是,提供了容错性,可以自动从节点失败中恢复过来。即如果某个节点上的RDD partition,因为节点故障,导致数据丢了,那么RDD会自动通过自己的数据来源重新计算该partition。这一切对使用者是透明的。
5、RDD的数据默认情况下存放在内存中的,但是在内存资源不足时,Spark会自动将RDD数据写入磁盘。(弹性)
推荐,阅读源码来进一步学习。可见,知识来自于源码
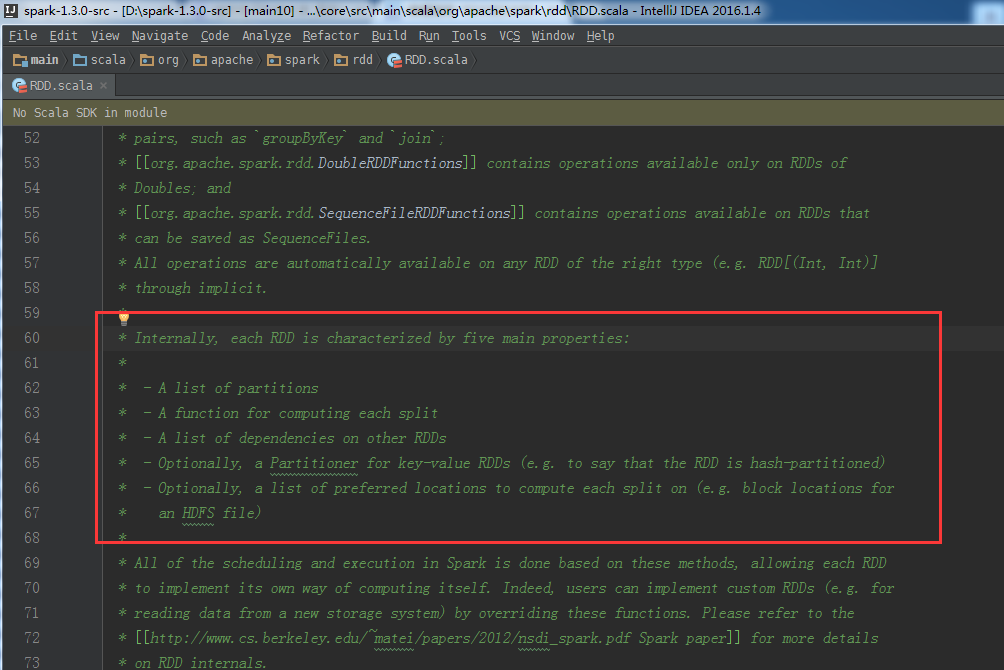
* Internally, each RDD is characterized by five main properties:** - A list of partitions* - A function for computing each split* - A list of dependencies on other RDDs* - Optionally, a Partitioner for key-value RDDs (e.g. to say that the RDD is hash-partitioned)* - Optionally, a list of preferred locations to compute each split on (e.g. block locations for* an HDFS file)
Spark RDD概念学习系列之RDD的5大特点(五)的更多相关文章
- Spark RDD概念学习系列之RDD的转换(十)
RDD的转换 Spark会根据用户提交的计算逻辑中的RDD的转换和动作来生成RDD之间的依赖关系,同时这个计算链也就生成了逻辑上的DAG.接下来以“Word Count”为例,详细描述这个DAG生成的 ...
- Spark RDD概念学习系列之RDD的checkpoint(九)
RDD的检查点 首先,要清楚.为什么spark要引入检查点机制?引入RDD的检查点? 答:如果缓存丢失了,则需要重新计算.如果计算特别复杂或者计算耗时特别多,那么缓存丢失对于整个Job的影响是不容 ...
- Spark RDD概念学习系列之RDD的缓存(八)
RDD的缓存 RDD的缓存和RDD的checkpoint的区别 缓存是在计算结束后,直接将计算结果通过用户定义的存储级别(存储级别定义了缓存存储的介质,现在支持内存.本地文件系统和Tachyon) ...
- Spark RDD概念学习系列之RDD的操作(七)
RDD的操作 RDD支持两种操作:转换和动作. 1)转换,即从现有的数据集创建一个新的数据集. 2)动作,即在数据集上进行计算后,返回一个值给Driver程序. 例如,map就是一种转换,它将数据集每 ...
- Spark RDD概念学习系列之RDD是什么?(四)
RDD是什么? 通俗地理解,RDD可以被抽象地理解为一个大的数组(Array),但是这个数组是分布在集群上的.详细见 Spark的数据存储 Spark的核心数据模型是RDD,但RDD是个抽象类 ...
- Spark RDD概念学习系列之RDD的依赖关系(宽依赖和窄依赖)(三)
RDD的依赖关系? RDD和它依赖的parent RDD(s)的关系有两种不同的类型,即窄依赖(narrow dependency)和宽依赖(wide dependency). 1)窄依赖指的是每 ...
- Spark RDD概念学习系列之RDD的缺点(二)
RDD的缺点? RDD是Spark最基本也是最根本的数据抽象,它具备像MapReduce等数据流模型的容错性,并且允许开发人员在大型集群上执行基于内存的计算. 为了有效地实现容错,(详细见ht ...
- Spark RDD概念学习系列之rdd持久化、广播、累加器(十八)
1.rdd持久化 2.广播 3.累加器 1.rdd持久化 通过spark-shell,可以快速的验证我们的想法和操作! 启动hdfs集群 spark@SparkSingleNode:/usr/loca ...
- Spark RDD概念学习系列之rdd的依赖关系彻底解密(十九)
本期内容: 1.RDD依赖关系的本质内幕 2.依赖关系下的数据流视图 3.经典的RDD依赖关系解析 4.RDD依赖关系源码内幕 1.RDD依赖关系的本质内幕 由于RDD是粗粒度的操作数据集,每个Tra ...
- Spark RDD概念学习系列之RDD的创建(六)
RDD的创建 两种方式来创建RDD: 1)由一个已经存在的Scala集合创建 2)由外部存储系统的数据集创建,包括本地文件系统,还有所有Hadoop支持的数据集,比如HDFS.Cassandra.H ...
随机推荐
- Android 第三方应用接入微信平台(1)
关键字:微信开放平台 Android第三方应用接入微信 微信平台开放后倒是挺火的,许多第三方应用都想试下接入微信这个平台, 毕竟可以利用微信建立起来的关系链来拓展自己的应用还是挺不错的,可 以节约 ...
- Win7平台下Cocos2d-x环境搭建
一.Win7下Cocos2d-x环境搭建 Cocos开发者平台官网——在这里下载游戏引擎 解压放到某个目录下即可 https://www.python.org/downloads/ ...
- 基础组件_Window(窗口)
窗口控件是一个浮动和可拖拽的面板可以用作应用程序窗口.默认情况下,窗口可以移动,调整大小和关闭.它的内容也可以被定义为静态html或要么通过ajax动态加载. 1. 通过标签创建窗口
- source导入错码解决办法
mysql -uroot -p --default-character-set=utf8 test < D:/bak/1.sql
- python执行mysqldump命令
本文简单讲述如何利用python执行一些sql语句,例如执行mysqldump命令,进行数据库备份,备份成sql文件 #!/usr/bin/python#导入os模块import os#导入时间模块i ...
- IOS中封装一个View的思路
一.封装一个View的思路 1.将View内部的业务逻辑(显示内容)封装到View中 2.一般情况下,View的位置应该由父控件来决定,也就是位置不应该固定死在View内部 3.至于View的宽高,根 ...
- mac出现一个白条
mac出现一个白条,除了finder没有任何程序运行,出现好几次了,怎么解决? 打开finder输中文出现 按esc键
- spring.net IOC容器
spring.net 通过配置文件的方式 帮我们实现了IoC功能,实现方式非常灵活,且多种多样. 点击查看 创建对象 我们只需定义接口和实现方法,spring.net帮我们实现了其他功能. 第一步,定 ...
- Github托管代码步骤
总结一下Github上项目托管步骤: Step 1:注册Github帐号,并创建一个repository,假如仓库名为test: Step 2:安装本地Git: sudo apt-get instal ...
- Java核心技术II读书笔记(二)
ch2 XML 有两种XML文档结构,DTD和Schema,用解释文档构成规则,这些规则指定了每个元素俺的合法子元素和属性. DTD DTD有多种提供方式,可以像下面这样加到XML中: <?xm ...