
相似度度量:欧氏距离与余弦相似度(Similarity Measurement Euclidean Distance Cosine Similarity)
在《机器学习---文本特征提取之词袋模型(Machine Learning Text Feature Extraction Bag of Words)》一文中,我们通过计算文本特征向量之间的欧氏距离,了解到各个文本之间的相似程度。当然,还有其他很多相似度度量方式,比如说余弦相似度。
在《皮尔逊相关系数与余弦相似度(Pearson Correlation Coefficient & Cosine Similarity)》一文中简要地介绍了余弦相似度。因此这里,我们比较一下欧氏距离和余弦相似度之间的区别。
首先来说一下欧氏距离(Euclidean Distance):
n维空间里两个向量X(x1,x2,…,xn)与Y(y1,y2,…,yn)之间的欧氏距离计算公式是: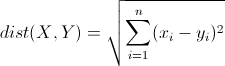
用矩阵表示法表示为:
再来说一下余弦相似度(Cosine Similarity):
n维空间里两个向量x(x1,x2,…,xn)与y(y1,y2,…,yn)之间的余弦相似度计算公式是:
用向量形式表示为:
相同之处:
在机器学习中都可以用来计算相似程度。欧氏距离是最常见的距离度量,而余弦相似度则是最常见的相似度度量。很多其他的距离度量和相似度度量都是基于这两者的变形和衍生。
区别:
借助三维坐标系来看下欧氏距离和余弦相似度的区别。(下图摘自:https://blog.csdn.net/lin00jian/article/details/51209715)
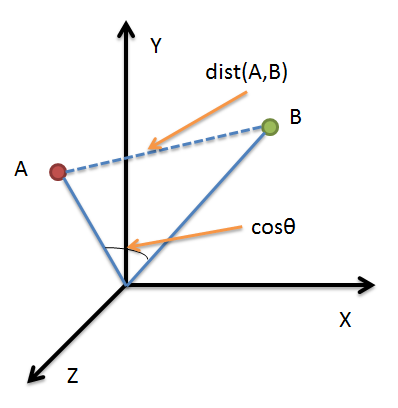
从图上可以看出欧式距离衡量的是空间中各点之间的绝对距离,和点所在的位置坐标(即个体各维度的特征数值)直接相关,距离越小,两向量之间越相似;而余弦相似度衡量的是空间中两向量之间的夹角,体现的是方向上的差异,夹角越小(余弦相似度越大),两向量之间越相似。如果保持A点的位置不变,B点朝原方向延伸,那么这个时候余弦相似度cosθ是保持不变的,因为夹角不变,而A、B两点间的距离显然在发生改变,这就是欧氏距离和余弦相似度的不同之处。
适用场景:
欧氏距离能够体现个体数值特征的绝对差异,所以更多的用于需要从维度的数值大小中体现差异的分析,比如使用用户行为作为指标分析用户价值的相似情况(比较不同用户的消费能力),这属于价值度量;而余弦相似度对绝对数值不敏感,更多的用于使用用户对内容的评分来分析用户兴趣的相似程度(用户是否喜欢某商品),这属于定性度量。
需要注意的是,欧氏距离和余弦相似度都需要保证各维度处于相同的刻度级别(量纲),所以一般需要对数据先进行标准化处理,否则很可能会引起偏差。比如用户对内容评分,假设为5分制,对用户甲来说评分3分以上就是自己喜欢的,而对于用户乙,评分4分以上才是自己喜欢的,这样就无法很好地衡量两个用户评分之间的相似程度。如果将评分数值减去平均值,那么就可以很好地解决问题。此时,就相当于用皮尔逊相关系数来度量相似程度。
相似度度量:欧氏距离与余弦相似度(Similarity Measurement Euclidean Distance Cosine Similarity)的更多相关文章
- Spark Mllib里相似度度量(基于余弦相似度计算不同用户之间相似性)(图文详解)
不多说,直接上干货! 常见的推荐算法 1.基于关系规则的推荐 2.基于内容的推荐 3.人口统计式的推荐 4.协调过滤式的推荐 协调过滤算法,是一种基于群体用户或者物品的典型推荐算法,也是目前常用的推荐 ...
- 余弦相似度-Cosine Similar(转载)
余弦相似度用向量空间中两个向量夹角的余弦值作为衡量两个个体间差异的大小.相比距离度量,余弦相似度更加注重两个向量在方向上的差异,而非距离或长度上. 与欧几里德距离类似,基于余弦相似度的计算方法也是把用 ...
- 皮尔逊相关系数与余弦相似度(Pearson Correlation Coefficient & Cosine Similarity)
之前<皮尔逊相关系数(Pearson Correlation Coefficient, Pearson's r)>一文介绍了皮尔逊相关系数.那么,皮尔逊相关系数(Pearson Corre ...
- 两矩阵各向量余弦相似度计算操作向量化.md
余弦相似度计算: \cos(\bf{v_1}, \bf{v_2}) = \frac{\left( v_1 \times v_2 \right)}{||v_1|| * ||v_2|| } \cos(\b ...
- 余弦相似度及基于python的三种代码实现、与欧氏距离的区别
1.余弦相似度可用来计算两个向量的相似程度 对于如何计算两个向量的相似程度问题,可以把这它们想象成空间中的两条线段,都是从原点([0, 0, ...])出发,指向不同的方向.两条线段之间形成一个夹角, ...
- Jackcard类似度和余弦类似度(向量空间模型)的java实现
版权声明:本文为博主原创文章,地址:http://blog.csdn.net/napoay,转载请留言. 总结Jackcard类似度和余弦类似度. 一.集合的Jackcard类似度 1.1Jackca ...
- 推荐系统之余弦相似度的Spark实现
推荐系统之余弦相似度的Spark实现 (1)原理分析 余弦相似度度量是相似度度量中最常用的度量关系,从程序分析中, 第一步是数据的输入, 其次是使用相似性度量公式 最后是对不同用户的递归计算. ...
- Sequence Model-week2编程题1-词向量的操作【余弦相似度 词类比 除偏词向量】
1. 词向量上的操作(Operations on word vectors) 因为词嵌入的训练是非常耗资源的,所以ML从业者通常 都是 选择加载训练好 的 词嵌入(Embedding)数据集.(不用自 ...
- 【Math】余弦相似度 和 Pearson相关系数
http://cucmakeit.github.io/2014/11/13/%E4%BF%AE%E6%AD%A3%E4%BD%99%E5%BC%A6%E7%9B%B8%E4%BC%BC%E5%BA%A ...
随机推荐
- Git 安装配置手册
Git 安装配置手册 首先我们要了解 Git 是类似于 SVN 用来管理项目的 首先要先下载 Git ,这个东西相当于一个核,是该功能的核心 下载地址(<https://gitforwindow ...
- C# 创建、更改Excel命名区域(NamedRange)
创建命名区域是指给选定的某个单元格或多个单元格区域设置名称,目的是方便我们在文件中的其他地方对该单元格区域进行引用能够简化公式引用或者方便数据管理.下面记录了具体的C#示例代码.这里创建命名区域分为了 ...
- 【JS】深拷贝与浅拷贝的区别,实现深拷贝的几种方法
1 借用JSON对象的parse和stringify function deepClone(obj){ let _obj = JSON.stringify(obj), objClone = JSON. ...
- android WebView技术笔记(存储技术)
作为刚刚开始工作的新手程序猿,各种知识还不算熟练,所以将学习到的知识记录一下以免以后忘记. WebView加载h5的知识现在可以说非常的常用,通过加载h5的网页可以在不更新app的情况下来更新app的 ...
- Numpy库的学习(五)
今天继续学习一下Numpy库,废话不多说,整起走 先说下Numpy中,经常会犯错的地方,就是数据的复制 这个问题不仅仅是在numpy中有,其他地方也同样会出现 import numpy as np a ...
- curl 命令-接口测试
在linux/Unix 为代表的os上, 对后端进行测试, 模拟连接请求都会书写脚本 场景: 在Linux 上接口测试工具有ab, restClient, postman等, 最常用的方法是curl进 ...
- Python第十四天 序列化 pickle模块 cPickle模块 JSON模块 API的两种格式
Python第十四天 序列化 pickle模块 cPickle模块 JSON模块 API的两种格式 目录 Pycharm使用技巧(转载) Python第一天 安装 shell 文件 Py ...
- centos7 永久添加静态路由
查看路由表 ip route show|column -t route -n 永久添加路由 vim /etc/sysconfig/network-scripts/route-ens224 via 17 ...
- win2008server R2 x64 部署.net core到IIS--ASP .NET Core HTTP Error 502.5 – Process Failure
服务器win2008server R2 x64 部署.net core到IIS 解决ASP .NET Core HTTP Error 502.5 – Process Failure 问题等 1.发布网 ...
- 记录display:table的使用
兼容性:不兼容IE7 1.左右对齐 <!DOCTYPE html> <html lang="en"> <head> <meta chars ...