
[scrapy]Item Loders
Items
Items就是结构化数据的模块,相当于字典,比如定义一个{"title":"","author":""},items_loders就是从网页中提取title和author字段填充到items里,比如{"title":"初学scrapy","author":"Alex"},然后items把结构化的数据传给pipeline,pipeline可以把数据插入进MySQL里.
实例
items.py
import scrapy

class JobBoleArticleItem(scrapy.Item):

    title = scrapy.Field()

    create_date = scrapy.Field()

    url = scrapy.Field()

    url_object_id = scrapy.Field()

    front_image_url = scrapy.Field()

    front_image_path = scrapy.Field()

    praise_nums = scrapy.Field()

    comment_nums = scrapy.Field()

    fav_nums = scrapy.Field()
jobbole.py
# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request

from scrapy.loader import ItemLoader

from urllib import parse

import re

import  datetime

from ArticleSpider.items import JobBoleArticleItem

from utils.common import get_md5

class JpbboleSpider(scrapy.Spider):

    name = 'jobbole'

    allowed_domains = ['blog.jobbole.com']

    start_urls = ['http://blog.jobbole.com/all-posts/']  #先下载http://blog.jobbole.com/all-posts/这个页面,然后传给parse解析

    def parse(self, response):

        #1.start_urls下载页面http://blog.jobbole.com/all-posts/,然后交给parse解析,parse里的post_urls获取这个页面的每个文章的url,Request下载每个文章的页面,然后callback=parse_detail,交给parse_detao解析

        #2.等post_urls这个循环执行完,说明这一个的每个文章都已经解析完了, 就执行next_url,next_url获取下一页的url,然后Request下载,callback=self.parse解析,parse从头开始,先post_urls获取第二页的每个文章的url,然后循环每个文章的url,交给parse_detail解析

        #获取http://blog.jobbole.com/all-posts/中所有的文章url,并交给Request去下载,然后callback=parse_detail,交给parse_detail解析

        post_nodes = response.css("#archive  .floated-thumb .post-thumb a")

        for post_node in post_nodes:

            image_url = post_node.css("img::attr(src)").extract_first("")

            post_url = post_node.css("::attr(href)").extract_first("")

            yield Request(url=parse.urljoin(response.url,post_url),meta={"front_image_url":image_url},callback=self.parse_detail)

        #获取下一页的url地址,交给Request下载,然后交给parse解析

        next_url = response.css(".next.page-numbers::attr(href)").extract_first("")

        if next_url:

            yield Request(url=next_url,callback=self.parse)

    def parse_detail(self,response):

        article_item = JobBoleArticleItem()  #实例化定义的items

        item_loader = ItemLoader(item=JobBoleArticleItem(),response=response) #实例化item_loader,把我们定义的item传进去,再把下载器下载的网页穿进去

        #针对直接取值的情况

        item_loader.add_value("url",response.url)

        item_loader.add_value("url_object_id",get_md5(response.url))

        item_loader.add_value("front_image_url",[front_image_url])

        #针对css选择器

        item_loader.add_css("title",".entry-header h1::text")

        item_loader.add_css("create_date","p.entry-meta-hide-on-mobile::text")

        item_loader.add_css("praise_nums",".vote-post-up h10::text")

        item_loader.add_css("comment_nums","a[href='#article-comment'] span::text")

        item_loader.add_css("fav_nums",".bookmark-btn::text")

        #把结果返回给items

        article_item = item_loader.load_item()
- .add_value:把直接获取到的值,复制给字段
- .add_css:需要通过css选择器获取到的值
- .add_xpath:需要通过xpath选择器获取到的值
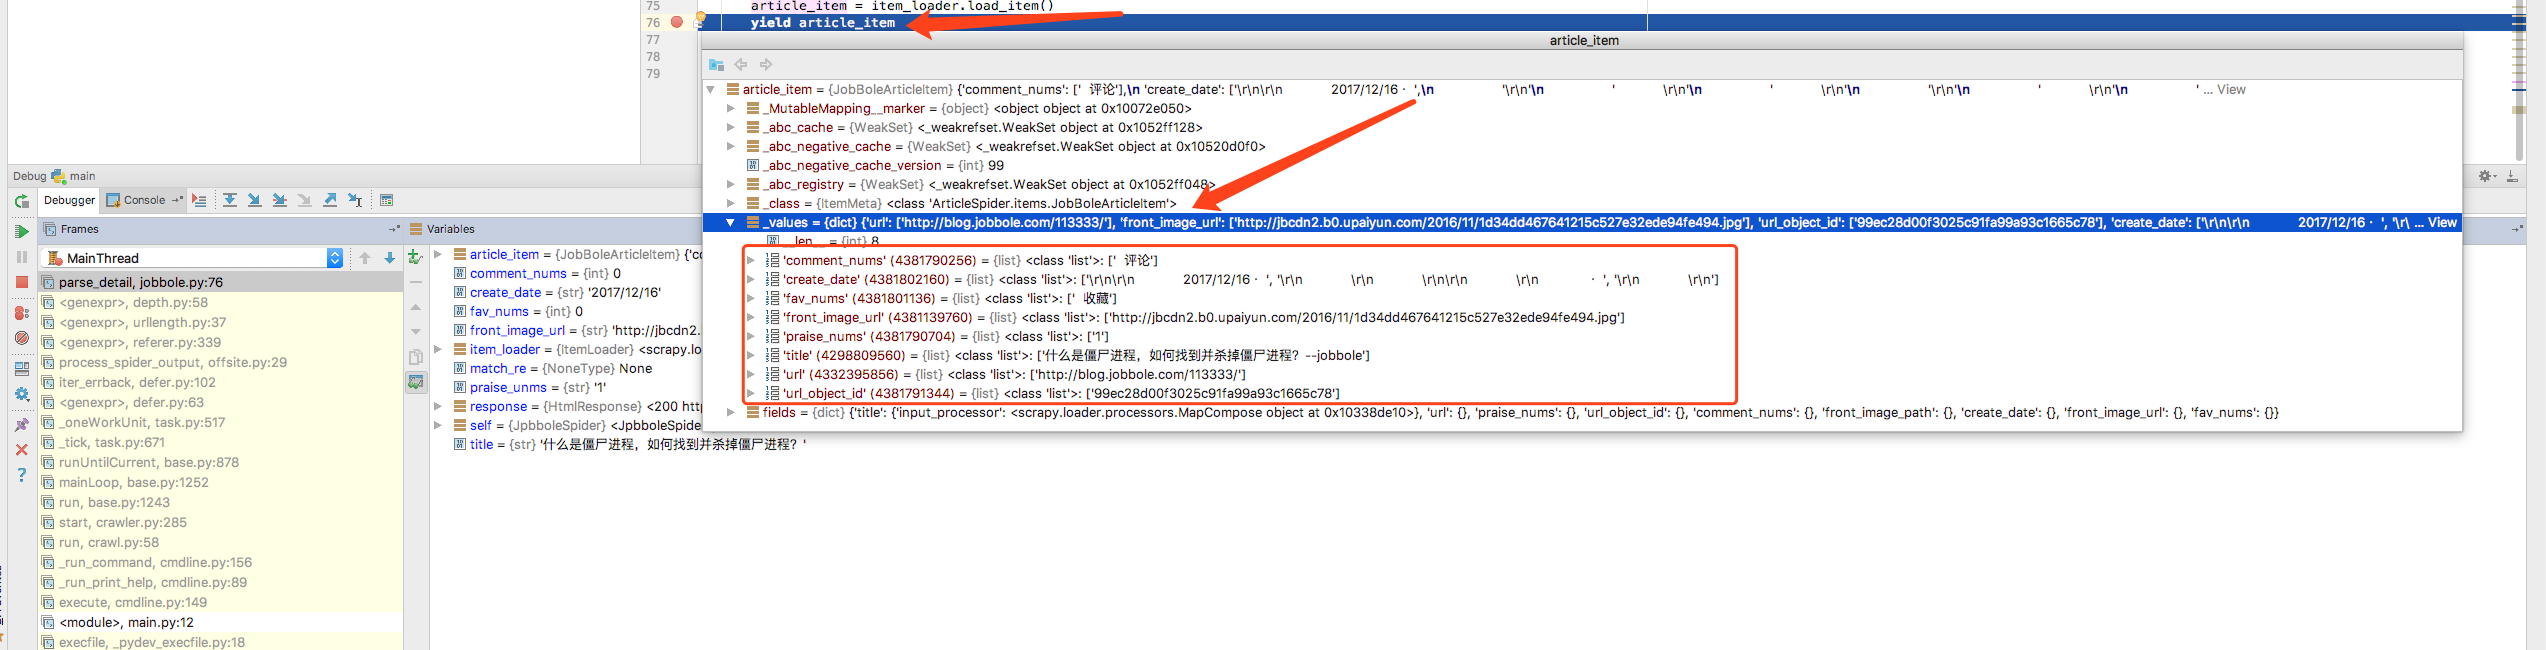
debug调试,可以看到拿到的信息
[scrapy]Item Loders的更多相关文章
- 第三百四十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制
第三百四十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制 用命令创建自动爬虫文件 创建爬虫文件是根据scrap ...
- 二十三 Python分布式爬虫打造搜索引擎Scrapy精讲—craw母版l创建自动爬虫文件—以及 scrapy item loader机制
用命令创建自动爬虫文件 创建爬虫文件是根据scrapy的母版来创建爬虫文件的 scrapy genspider -l 查看scrapy创建爬虫文件可用的母版 Available templates: ...
- scrapy item
item item定义了爬取的数据的model item的使用类似于dict 定义 在items.py中,继承scrapy.Item类,字段类型scrapy.Field() 实例化:(假设定义了一个名 ...
- 第十篇 scrapy item loader机制
在我们执行scrapy爬取字段中,会有大量的和下面的代码,当要爬取的网站多了,要维护起来很麻烦,为解决这类问题,我们可以根据scrapy提供的loader机制 def parse_detail(sel ...
- scrapy item pipeline
item pipeline process_item(self, item, spider) #这个是所有pipeline都必须要有的方法在这个方法下再继续编辑具体怎么处理 另可以添加别的方法 ope ...
- 使用sqlalchemy用orm方式写pipeline将scrapy item快速存入 MySQL
传统的使用scrapy爬下来的数据存入mysql,用的是在pipeline里用pymysql存入数据库, 这种方法需要写sql语句,如果item字段数量非常多的 情况下,编写起来会造成很大的麻烦. 我 ...
- Scrapy Item用法示例(保存item到MySQL数据库,MongoDB数据库,使用官方组件下载图片)
需要学习的地方: 保存item到MySQL数据库,MongoDB数据库,下载图片 1.爬虫文件images.py # -*- coding: utf-8 -*- from scrapy import ...
- scrapy item处理----cooperator和parallel()函数
twisted的task之cooperator和scrapy的parallel()函数 本文是关于下载结果返回后调用item处理的过程实现研究. 从scrapy的结果处理说起 def handle_s ...
- Scrapy系列教程(2)------Item(结构化数据存储结构)
Items 爬取的主要目标就是从非结构性的数据源提取结构性数据,比如网页. Scrapy提供 Item 类来满足这种需求. Item 对象是种简单的容器.保存了爬取到得数据. 其提供了 类似于词典(d ...
随机推荐
- 《嵌入式linux应用程序开发标准教程》笔记——7.进程控制开发
进程是系统资源的最小单元,很重要. 7.1 linux进程的基本概念 定义:一个程序的一次执行过程,同时也是资源分配的最小单元.程序是静态的,而进程是动态的. 进程控制块:linux系统用进程控制块描 ...
- shell中test的使用
#/secondin/secondfirstshecho “please enter two numseconder”read firstread secondif test $first -eq $ ...
- linux 使用mail 发送邮件
配置: /etc/mail.rc 追加配置参数 set from=lynctest@iclinux.com smtp="mail.iclinux.com"smtp-auth-use ...
- sql server 2008启动时:已成功与服务器建立连接,但是在登录过程中发生错误。(provider:命名管道提供程序,error:0-管道的另一端上无任何进程。)(Microsoft SQL Server,错误:233) 然后再连接:错误:18456
问题:sql server 2008启动时:已成功与服务器建立连接,但是在登录过程中发生错误.(provider:命名管道提供程序,error:0-管道的另一端上无任何进程.)(Microsoft S ...
- Windows 通过 SecureCRT 8.x 上传文件到Linux服务器
1.SecureCRT 连接 Linux 服务器,这一步操作简单: 2.连接并登录成功后,直接在连接成功的页签上 右键 -> Connect SFTP Session 打开SFTP窗口: 3. ...
- 图论trainning-part-1 F. Highways
F. Highways Time Limit: 1000ms Memory Limit: 10000KB 64-bit integer IO format: %lld Java class ...
- Flutter 发布APK时,release版本和debug版本的默认权限不同
Flutter 发布APK时,release版本和debug版本的默认权限不同 @author ixenos 在调试模式下,默认情况下启用服务扩展和多个权限(在flutter中) 当您处于发布模式时, ...
- Git x SVN rebase事故
Git x SVN rebase事故 @author ixenos 2019-01-09 14:21:21 前言: 昨天在Git x SVN 中进行git svn dcommit的时候,提示需要再进行 ...
- Oracle spool 用法小结
关于SPOOL(SPOOL是SQLPLUS的命令,不是SQL语法里面的东西.) 对于SPOOL数据的SQL,最好要自己定义格式,以方便程序直接导入,SQL语句如: select taskindex|| ...
- 推荐两个不错的flink项目
最近flink真是风生水起,但是浪院长看来这不过是阿里错过了创造spark影响力之后,想要在flink领域创建绝对的影响力.但是,不可否认flink在实时领域确实目前来看独树一帜,当然也有它不适合的地 ...