
Lucene介绍及简单入门案例(集成ik分词器)
介绍
Lucene是apache软件基金会4 jakarta项目组的一个子项目,是一个开放源代码的全文检索引擎工具包,但它不是一个完整的全文检索引擎,而是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎,部分文本分析引擎(英文与德文两种西方语言)。Lucene的目的是为软件开发人员提供一个简单易用的工具包,以方便的在目标系统中实现全文检索的功能,或者是以此为基础建立起完整的全文检索引擎。Lucene是一套用于全文检索和搜寻的开源程式库,由Apache软件基金会支持和提供。Lucene提供了一个简单却强大的应用程式接口,能够做全文索引和搜寻。在Java开发环境里Lucene是一个成熟的免费开源工具。就其本身而言,Lucene是当前以及最近几年最受欢迎的免费Java信息检索程序库。人们经常提到信息检索程序库,虽然与搜索引擎有关,但不应该将信息检索程序库与搜索引擎相混淆。
Lucene是Apache提供的一个开源的全文检索引擎工具包, 其本质就是一个工具包, 而非一个完整的搜索引擎, 但是我们可以通过Lucene来构建一个搜索引擎,比如solr和elasticsearch都是基于Lucene的搜索引擎。
使用Lucene如何构建索引
第一步:导入相关的jar包
<dependency>

    <groupId>org.apache.lucene</groupId>

    <artifactId>lucene-core</artifactId>

    <version>4.10.2</version>

</dependency>

<dependency>

    <groupId>org.apache.lucene</groupId>

    <artifactId>lucene-queries</artifactId>

    <version>4.10.2</version>

</dependency>

<dependency>

    <groupId>org.apache.lucene</groupId>

    <artifactId>lucene-test-framework</artifactId>

    <version>4.10.2</version>

</dependency>

<dependency>

    <groupId>org.apache.lucene</groupId>

    <artifactId>lucene-analyzers-common</artifactId>

    <version>4.10.2</version>

</dependency>

<dependency>

    <groupId>org.apache.lucene</groupId>

    <artifactId>lucene-queryparser</artifactId>

    <version>4.10.2</version>

</dependency>

<dependency>

    <groupId>org.apache.lucene</groupId>

    <artifactId>lucene-highlighter</artifactId>

    <version>4.10.2</version>

</dependency>
第二步:书写写入索引的代码
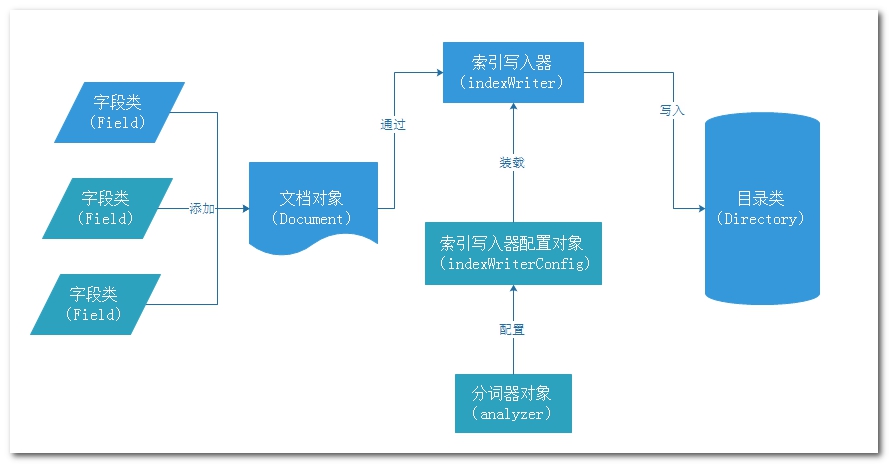
简单案例:
public class LuceneIndex {

    public static void main(String[] args) throws IOException {

        //1 创建indexwriter对象

        //1.1 创建索引库

        FSDirectory directory = FSDirectory.open(new File("H:\\test"));

        //1.2 创建写入器配置对象 参数1 版本号, 参数2 分词器

        IndexWriterConfig config = new IndexWriterConfig(Version.LATEST, new StandardAnalyzer());

        //1.3 创建indexwriter对象

        IndexWriter indexWriter = new IndexWriter(directory, config);

        //2 写入文档

        //2.1 创建文档对象(lucene的document对象)

        Document document = new Document();

        //2.2 添加文档属性(字段)   new xxxField(字段名,字段值,是否保存)

        document.add(new IntField("id", 1, Field.Store.YES));

        document.add(new StringField("title", "Lucene介绍", Field.Store.YES));

        document.add(new TextField("content", "Lucene是一个全文检索的工具包", Field.Store.YES));

        //2.3 写入文档

        indexWriter.addDocument(document);

        //3 提交数据

        indexWriter.commit();

        //释放资源

        indexWriter.close();

    }

}
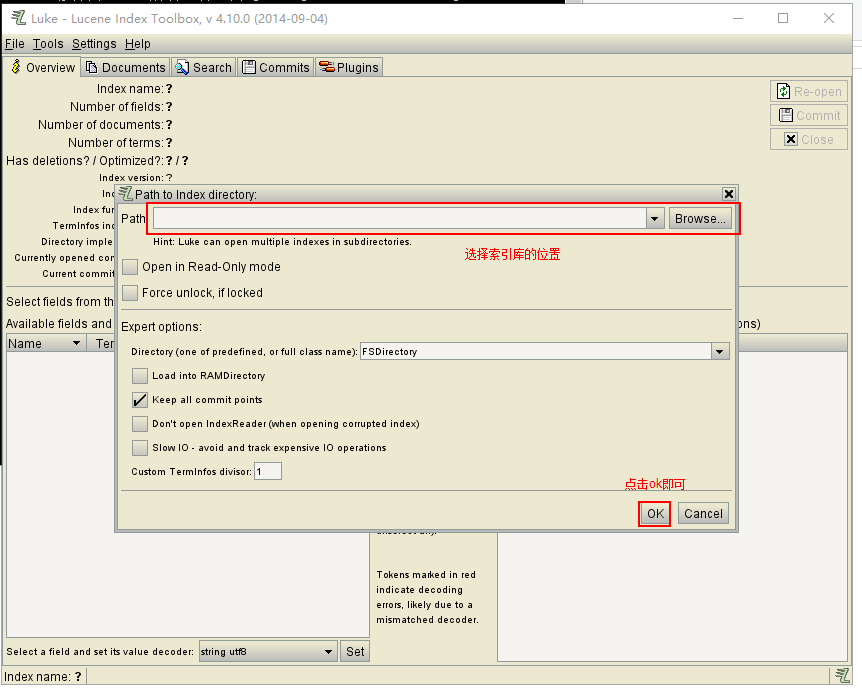
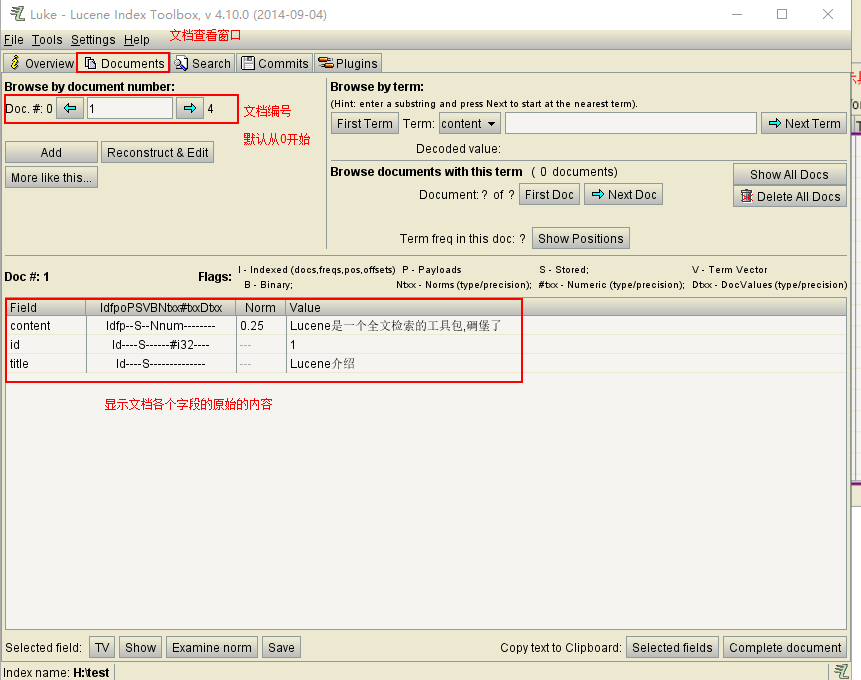
使用索引查看工具查看插入的索引信息
下载一个lukeall-xxxx(版本信息).jar, cmd运行这个工具jar包:

Lucene集成IKAnalyzer 中文分词器
Analyzer: 分词器:
用于对文档中的数据进行分词, 其分词的效果取决于分词器的选择, Lucene中根据各个国家制定了各种语言的分词器,对中文有一个ChineseAnalyzer 但是其分词的效果, 是将中文进行一个一个字的分开
针对中文分词一般只能使用第三方的分词词,比如IKAnalyzer
首先要引入jar包:
<!-- 引入IK分词器 -->

<dependency>

    <groupId>com.janeluo</groupId>

    <artifactId>ikanalyzer</artifactId>

    <version>2012_u6</version>

</dependency>
代码部分只需要修改我们上面案例的分词器对象即可:
//1.2 创建写入器配置对象 参数1 版本号, 参数2 分词器

IndexWriterConfig config = new IndexWriterConfig(Version.LATEST, new IKAnalyzer());
高级使用:
ik分词器在2012年更新后, 就在没有更新, 其原因就取决于其强大的扩展功能,以保证ik能够持续使用
ik支持对自定义词库, 其可以定义两个扩展的词典
1) 扩展词典(新创建词功能):有些词IK分词器不识别 例如:“剑来”,“剑九黄”
2) 停用词典(停用某些词功能)有些词不需要建立索引 例如:“哦”,“啊”,“的”
如何使用:
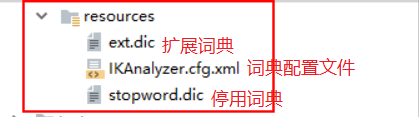
在resources内创建者三个文件,在ext.dic中设置需要进行分词的内容即可, 在stopword中设置不被分词的内容即可,xml文件内容格式如下:
<?xml version="1.0" encoding="UTF-8"?>

<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">

<properties>

    <comment>IK Analyzer 扩展配置</comment>

    <!--用户可以在这里配置自己的扩展字典 -->

    <entry key="ext_dict">ext.dic;</entry>

    <!--用户可以在这里配置自己的扩展停止词字典-->

    <entry key="ext_stopwords">stopword.dic;</entry>

</properties>
其他两个词典内容格式:
剑来

剑九黄

剑开天门
API详解:
IndexWriter: 索引写入器对象
其主要的作用, 添加索引, 修改索引和删除索引
创建此对象的时候, 需要传入Directory和indexWriterConfig对象
Directory: 目录类, 用来指定索引库的目录
常用的实现类:
FSDirectory: 用来指定文件系统的目录, 将索引信息保存到磁盘上
优点: 索引可以进行长期保存, 安全系数高
缺点: 读取略慢
RAMDriectory: 内存目录, 将索引库信息存放到内存中
优点: 读取速度快
缺点: 不安全, 无法长期保存, 关机后就消失了
IndexWriterConfig: 索引写入器的配置类
创建此对象, 需要传递Lucene的版本和分词器
作用:
作用1 : 指定Lucene的版本和需要使用的分词器
作用2: 设置Lucene的打开索引库的方式: setOpenMode();
//参数值: APPEND CREATE   CREATE_OR_APPEND

/**

 * APPEND: 表示追加, 如果索引库存在, 就会向索引库中追加数据, 如果索引库不存在, 直接报错

 *

 * CREATE: 表示创建, 不管索引库有没有, 每一次都是重新创建一个新的索引库

 *

 * CREATE_OR_APPEND: 如果索引库有, 就会追加, 如果没有 就会创建索引库

         默认值也是 CREATE_OR_APPEND

 */

config.setOpenMode(IndexWriterConfig.OpenMode.CREATE_OR_APPEND);
Document: 文档
在Lucene中, 每一条数据以文档的形式进行存储, 文档中也有其对应的属性和值, Lucene中一个文档类似数据库的一个表, 表中的字段类似于文档中的字段,只不过这个文档只能保存一条数据
Document看做是一个文件, 文件的属性就是文档的属性, 文件对应属性的值就是文档的属性的值 content
一个文档中可以有多个字段, 每一个字段就是一个field对象,不同的文档可以有不同的属性
字段也有其对应数据类型, 故Field类也提供了各种数据类型的实现类
| Field类 | 数据类型 | Analyzed是否分析 | Indexed是否索引 | Stored是否存储 | 说明 |
|---|---|---|---|---|---|
| StringField(FieldName, FieldValue,Store.YES)) | 字符串 | N | Y | Y或N | 这个Field用来构建一个字符串Field,但是不会进行分析,会将整个串存储在索引中,比如(订单号,姓名等)是否存储在文档中用Store.YES或Store.NO决定 |
| LongField(FieldName, FieldValue,Store.YES) | Long型 | Y | Y | Y或N | 这个Field用来构建一个Long数字型Field,进行分析和索引,比如(价格)是否存储在文档中用Store.YES或Store.NO决定 |
| StoredField(FieldName, FieldValue) | 重载方法,支持多种类型 | N | N | Y | 这个Field用来构建不同类型Field不分析,不索引,但要Field存储在文档中 |
| TextField(FieldName, FieldValue, Store.NO)或TextField(FieldName, reader) | 字符串或流 | Y | Y | Y或N | 如果是一个Reader, lucene猜测内容比较多,会采用Unstored的策略. |
更改和删除索引:
    /**

     * 更新索引

     * 本质先删除再添加

     * 先删除所有满足条件的文档,再创建文档

     * 因此,更新索引通常要根据唯一字段

     */

    @Test

    public void testUpdate() throws Exception {

        // 创建更改后的文档对象

        Document document = new Document();

        document.add(new StringField("id", "3", Field.Store.YES));

        document.add(new TextField("title", "更改后的titlek", Field.Store.YES));

        // 索引库对象

        Directory directory = FSDirectory.open(new File("H:\\test"));

        // 索引写入器配置对象

        IndexWriterConfig conf = new IndexWriterConfig(Version.LATEST, new IKAnalyzer());

        // 索引写入器对象

        IndexWriter indexWriter = new IndexWriter(directory, conf);

        // 执行更新操作 参数1 要更改的对象, 参数2 更改后的对象

        indexWriter.updateDocument(new Term("id", "1"), document);

        // 提交

        indexWriter.commit();

        // 关闭

        indexWriter.close();

    }

    // 删除索引

    @Test

    public void testDelete() throws Exception {

        // 创建目录对象

        Directory directory = FSDirectory.open(new File("H:\\test"));

        // 创建索引写入器配置对象

        IndexWriterConfig conf = new IndexWriterConfig(Version.LATEST, new IKAnalyzer());

        // 创建索引写入器对象

        IndexWriter indexWriter = new IndexWriter(directory, conf);

        // 执行删除操作(根据词条),要求id字段必须是字符串类型

        indexWriter.deleteDocuments(new Term("id", "5"));

        // 根据查询条件删除

        // indexWriter.deleteDocuments(NumericRangeQuery.newLongRange("id", 2l, 4l, true, false));

        // 删除所有

        //indexWriter.deleteAll();

        // 提交

        indexWriter.commit();

        // 关闭

        indexWriter.close();

    }
Lucene介绍及简单入门案例(集成ik分词器)的更多相关文章
- (2)ElasticSearch在linux环境中集成IK分词器
1.简介 ElasticSearch默认自带的分词器,是标准分词器,对英文分词比较友好,但是对中文,只能把汉字一个个拆分.而elasticsearch-analysis-ik分词器能针对中文词项颗粒度 ...
- ES系列一、CentOS7安装ES 6.3.1、集成IK分词器
Elasticsearch 6.3.1 地址: wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.3. ...
- Elasticsearch集成ik分词器
1.插件地址https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.0.0/elasticsearch-anal ...
- Elasticsearch学习系列一(部署和配置IK分词器)
Elasticsearch简介 Elasticsearch是什么? Elaticsearch简称为ES,是一个开源的可扩展的分布式的全文检索引擎,它可以近乎实时的存储.检索数据.本身扩展性很好,可扩展 ...
- Restful认识和 IK分词器的使用
什么是Restful风格 Restful是一种面向资源的架构风格,可以简单理解为:使用URL定位资源,用HTTP动词(GET,POST,DELETE,PUT)描述操作. 使用Restful的好处: 透 ...
- _00017 Kafka的体系结构介绍以及Kafka入门案例(0基础案例+Java API的使用)
博文作者:妳那伊抹微笑 itdog8 地址链接 : http://www.itdog8.com(个人链接) 博客地址:http://blog.csdn.net/u012185296 博文标题:_000 ...
- MyBatis学习总结(一)简单入门案例
MyBatis学习总结(一)简单入门案例 主要内容:本文主要通过对数据库中的use表进行增删改查总结mybatis的环境搭建和基本入门使用 一.需要的jar包: 1.核心包 2.依赖包 3.jdbc数 ...
- springcloud+eureka简单入门案例
springcloud+eureka简单入门案例 一.服务提供者 直接提供服务,入门案例没有特别要设置的地方,注意下端口,由于要启动多个服务,可能会冲突 配置文件(src/main/resources ...
- Solr4.4入门,介绍Solr的安装、IK分词器的配置及高亮查询结果(转)
一.Windows下安装solr-4.4.0 1. 下载solr.4.4 2. 下载绿色版tomcat6.0.18 3. 解压下载的solr到d:\study\solr,将dist目录下的sol ...
随机推荐
- npm 可执行模块的开发&&私服发布
备注: 大家日常在使用npm 安装依赖的时候有一些是命令行工具,比如vue-cli,具体的开发比较简单,同时 可以基于此开发一些脚手架,方便开发. 1. 项目初始化 npm init 备注:按照 ...
- 异常处理—Exception(三)
最近有点事,把这个系列给落下了,给大家道个歉,这里还要感谢我的老婆,谢谢她一直对我的支持:) 系列回顾: 1.异常处理--Exception(一) 2.异常处理—Exception(二) 上一篇中主要 ...
- cocostudio ui编辑器 使用心得
1 c++包含路径 2九宫格设置 cocostudio ui编辑器设置九宫格x,y,w,h是从图片左上角开始测量,然后调整尺寸就行了. 2. 如果点了自适应 panel会在加载json的时候被设置 ...
- web 前端 html
1,什么是web 在网络中,大量的数据需要有一个载体,而很多人都能够访问这个载体,利用浏览器的这个窗口链接一个有一个载体,这个载体就是网站也就是web的前身. 1,web标准:结构标准,表现标准,行为 ...
- 【转载】Leaflet 中文api
L.Map API各种类中的核心部分,用来在页面中创建地图并操纵地图. 使用 example // initialize the map on the "map" div with ...
- CentOS(五)--Linux系统的分区概念
一.系统分区 首先先普及一下有关系统分区的一些知识: 硬盘分区有三种,主磁盘分区.扩展磁盘分区.逻辑分区. 一个硬盘主分区至少有1个,最多4个,扩展分区可以没有,最多1个.且主分区+扩展分区总共不能超 ...
- 基于STL优先队列和邻接表的dijkstra算法
首先说下STL优先队列的局限性,那就是只提供入队.出队.取得队首元素的值的功能,而dijkstra算法的堆优化需要能够随机访问队列中某个节点(来更新源点节点的最短距离). 看似可以用vector配合m ...
- dts、dtb编译
设备树(Device Tree)包括DTC(device tree compiler),DTS(device tree source和DTB(device tree blob). dtc编译器能够把 ...
- (转)Inno Setup入门(十二)——Pascal脚本(1)
本文转载自:http://blog.csdn.net/yushanddddfenghailin/article/details/17250917 事件函数(1) Inno Setup支持以下函数和过程 ...
- Nginx+jwPlay搭建流媒体服务器,记忆播放
1.具体的流媒体服务器的搭建参考博客: http://blog.chinaunix.net/uid-20639775-id-154556.html 具体可能编译的时候有个地方报错 /root/ngin ...