
SparkStreaming 整合kafka Demo
这里使用的是低级API,因为高级API非常不好用,需要繁琐的配置,也不够自动化,却和低级API的效果一样,所以这里以低级API做演示
你得有zookeeper和kafka
我这里是3台节点主机
架构图

与高级API的区别,简单并行(不需要创造多个输入流,它会自动并行读取kafka的数据),高效(不会像receiver数据被copy两次),一次性语义(缺点:无法使用zookeeper的监控工具)
1.创建maven工程
首先添加pom依赖,其它运行依赖请参考 sparkStreaming整合WordCount
<dependency>

    <groupId>org.apache.spark</groupId>

    <artifactId>spark-streaming-kafka-0-8_2.11</artifactId>

    <version>2.0.2</version>

</dependency>
2.启动zookeeper集群
我把zookeeper集群弄成了个脚本,直接执行脚本启动所有zookeeper

启动成功
3.启动kafka集群
我这里是3台主机,三台都需要
进入目录
cd /export/servers/kafka/bin/
启动
kafka-server-start.sh -daemon /export/servers/kafka/config/server.properties
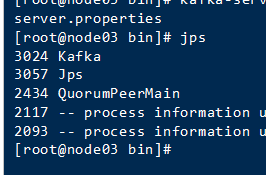
成功
4.测试kafka
创建topic
cd /export/servers/kafka_2.11-0.10.2.1
bin/kafka-topics.sh --create --zookeeper node01:2181 --replication-factor 1 --partitions 1 --topic kafka_spark
通过生产者发送消息
cd /export/servers/kafka_2.11-0.10.2.1
bin/kafka-console-producer.sh --broker-list node01:9092 --topic kafka_spark
想发啥,发啥。此时通过创建AP接收生产者发送的数据

编写代码
package SparkStreaming

import kafka.serializer.StringDecoder

import org.apache.spark.streaming.dstream.{DStream, InputDStream}

import org.apache.spark.streaming.kafka.KafkaUtils

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.{SparkConf, SparkContext}

object SparkStreamingKafka {

  def main(args: Array[String]): Unit = {

    // 1.创建SparkConf对象

    val conf: SparkConf = new SparkConf()

      .setAppName("SparkStreamingKafka_Direct")

      .setMaster("local[2]")

    // 2.创建SparkContext对象

    val sc: SparkContext = new SparkContext(conf)

    sc.setLogLevel("WARN")

    // 3.创建StreamingContext对象

    /**

      * 参数说明:

      *   参数一:SparkContext对象

      *   参数二:每个批次的间隔时间

      */

    val ssc: StreamingContext = new StreamingContext(sc,Seconds(5))

    //设置checkpoint目录

    ssc.checkpoint("./Kafka_Direct")

    // 4.通过KafkaUtils.createDirectStream对接kafka(采用是kafka低级api偏移量不受zk管理)

    // 4.1.配置kafka相关参数

    val kafkaParams=Map("metadata.broker.list"->"192.168.52.110:9092,192.168.52.120:9092,192.168.52.130:9092","group.id"->"kafka_Direct")

    // 4.2.定义topic

    val topics=Set("kafka_spark")

    val dstream: InputDStream[(String, String)] = KafkaUtils

      .createDirectStream[String,String,StringDecoder,StringDecoder](ssc,kafkaParams,topics)

    // 5.获取topic中的数据

    val topicData: DStream[String] = dstream.map(_._2)

    // 6.切分每一行,每个单词计为1

    val wordAndOne: DStream[(String, Int)] = topicData.flatMap(_.split(" ")).map((_,1))

    // 7.相同单词出现的次数累加

    val resultDS: DStream[(String, Int)] = wordAndOne.reduceByKey(_+_)

    // 8.通过Output Operations操作打印数据

    resultDS.print()

    // 9.开启流式计算

    ssc.start()

    // 阻塞一直运行

    ssc.awaitTermination()

  }

}
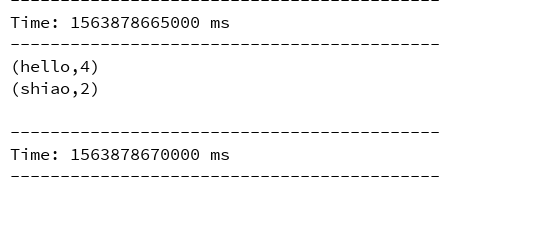
生产者生产数据

API接收控制台打印计算结果
SparkStreaming 整合kafka Demo的更多相关文章
- 基于Java+SparkStreaming整合kafka编程
一.下载依赖jar包 具体可以参考:SparkStreaming整合kafka编程 二.创建Java工程 太简单,略. 三.实际例子 spark的安装包里面有好多例子,具体路径:spark-2.1.1 ...
- 大数据学习day32-----spark12-----1. sparkstreaming(1.1简介,1.2 sparkstreaming入门程序(统计单词个数,updateStageByKey的用法,1.3 SparkStreaming整合Kafka,1.4 SparkStreaming获取KafkaRDD的偏移量,并将偏移量写入kafka中)
1. Spark Streaming 1.1 简介(来源:spark官网介绍) Spark Streaming是Spark Core API的扩展,其是支持可伸缩.高吞吐量.容错的实时数据流处理.Sp ...
- SparkStreaming整合kafka编程
1.下载spark-streaming-kafka插件包 由于Linux集群环境我使用spark是spark-2.1.1-bin-hadoop2.7,kafka是kafka_2.11-0.8.2.1, ...
- scala spark-streaming整合kafka (spark 2.3 kafka 0.10)
Maven组件如下: ) { System.err.println() } StreamingExamples.setStreamingLogLevels() )) ) { System.) } )) ...
- 大数据学习——SparkStreaming整合Kafka完成网站点击流实时统计
1.安装并配置zk 2.安装并配置Kafka 3.启动zk 4.启动Kafka 5.创建topic [root@mini3 kafka]# bin/kafka-console-producer. -- ...
- Spark之 Spark Streaming整合kafka(并演示reduceByKeyAndWindow、updateStateByKey算子使用)
Kafka0.8版本基于receiver接受器去接受kafka topic中的数据(并演示reduceByKeyAndWindow的使用) 依赖 <dependency> <grou ...
- 【Spark】SparkStreaming和Kafka的整合
文章目录 Streaming和Kafka整合 概述 使用0.8版本下Receiver DStream接收数据进行消费 步骤 一.启动Kafka集群 二.创建maven工程,导入jar包 三.创建一个k ...
- 图解SparkStreaming与Kafka的整合,这些细节大家要注意!
前言 老刘是一名即将找工作的研二学生,写博客一方面是复习总结大数据开发的知识点,一方面是希望帮助更多自学的小伙伴.由于老刘是自学大数据开发,肯定会存在一些不足,还希望大家能够批评指正,让我们一起进步! ...
- SparkStreaming和Kafka基于Direct Approach如何管理offset实现exactly once
在之前的文章<解析SparkStreaming和Kafka集成的两种方式>中已详细介绍SparkStreaming和Kafka集成主要有Receiver based Approach和Di ...
随机推荐
- cookie --中间件
Cookie简介 cookie是服务器存储在用户计算机中的变量,可以让我们用同一个浏览器访问同一个域名的时共享数据. HTTP是一种无状态协议,简单来说,当你从一个页面,然后跳转到同站点的另一个页面时 ...
- 代码提示—ArcGIS API forJavaScript for JavaScript 编辑器代码提示(支持3.x和4.x)
我一般用WebStorm来arcgis api for js的代码,因为api中的内容太多,每次写代码都要去官方API网站查询,很不方便,所以决定配置一个代码补全,方便写接口. 通过ArcGIS AP ...
- [iOS开发]关于cocoapods的使用
CocoaPods的使用 关于CocoaPods,相信做iOS开发的应该都比较熟悉了.Cocoapods是一个用来管理第三方库的比较好用的管理工具.关于Cocoapods的东西不再多说,接下来进入正题 ...
- 剑指offer 23:从上往下打印二叉树
题目描述 从上往下打印出二叉树的每个节点,同层节点从左至右打印. 解题思路 按照从左往右从上到下的顺序打印节点,需要我们维护一个队列,这个队列放入元素的顺序是访问队头节点(起始先放入根节点),则若当前 ...
- 从零开始的SpringBoot项目搭建
前言 今天是我加入博客园的第一天今天刚好学习到SpringBoot,就顺便记录一下吧 一.创建项目 1.创建工程 ① 通过File > New > Project,新建工程,选择Sprin ...
- 使用docker简单搭建个人博客
首先介绍需要的yml文件,docker-compose.yml: version: '3.3' services: db: image: mysql:5.7 volumes: - db_data:/v ...
- Linux下磁盘实战操作命令
企业真实场景由于硬盘常年大量读写,经常会出现坏盘,需要更换硬盘.或者由于磁盘空间不足,需添加新硬盘,新添加的硬盘需要经过格式化.分区才能被 Linux 系统所使用. 虚拟机 CentOS 7 Linu ...
- leetcode 双周赛9 找出所有行中最小公共元素
给你一个矩阵 mat,其中每一行的元素都已经按 递增 顺序排好了.请你帮忙找出在所有这些行中 最小的公共元素. 如果矩阵中没有这样的公共元素,就请返回 -1. 示例: 输入:mat = [[,,,,] ...
- 第05组 Beta冲刺(1/4)
第05组 Beta冲刺(1/4) 队名:天码行空 组长博客连接 作业博客连接 团队燃尽图(共享): GitHub当日代码/文档签入记录展示(共享): 组员情况: 组员1:卢欢(组长) 过去两天完成了哪 ...
- shutil模块(了解)
目录 一.shutil模块 1.1 zipfile压缩解压缩 1.2 tarfile压缩解压缩 一.shutil模块 高级的文件.文件夹.压缩包处理模块. import shutil # shutil ...