
base64解析爬取糗百
一、缘由
这是我之前刚开始学习的时候爬取糗百的练习内容,主要练习的是bs64解析。虽然现在用的不是特别的多,但是当初的时候用起来还是非常的顺手的。
二、代码实现
#coding:utf-8

import requests

from bs4 import BeautifulSoup

def download_page(url):

    headers={

        'User - Agent':"Mozilla / 5.0(Windows NT 10.0; WOW64) AppleWebKit / 537.36(KHTML, like Gecko) Chrome / 86.0.4240.198  Safari / 537.36"

    }  #模拟请求登录

    r=requests.get(url,headers=headers)

    return r.text

def get_content(html,page):

    output='''第{}页  作者:{}性别:{}年龄:{}点赞:{}\n{}\n----------\n\n'''

    soup=BeautifulSoup(html,'html.parser')

    con=soup.find('div',id='content')

    con_list=con.find_all('div',class_='article')

    for i in con_list:

       # hot_comments = i.find('div', class_='main-text').get_text() # 获取热评

        vote = i.find('i', class_='number').string  # 点赞数

        author=i.find('h2').string       #获得作者的名字

        content=i.find('div',class_='content').find('span').get_text()  #获取内容

        author_info=i.find('div',class_='artciGender') #获取性别,年龄等

        if author_info is not None:

            class_list=author_info['class']

            if 'womenIcon' in class_list:

                 gender='女'

            elif 'manIcon' in class_list:

                 gender='男'

            else:

                gender=''

            age=author_info.string

        else:

            gender=''

            age=''

        save_txt(output.format(page,author,gender,age,vote,content,))#hot_comments

def save_txt(*args):

    for i in args:

        with open('qiubai.txt','a',encoding='utf-8') as f:

            f.write(i)

            print(i)

def main():

        for i in range(1,14):

            url=f'''https://www.qiushibaike.com/text/page/{i}/'''

            html=download_page(url)

            get_content(html, i)

if __name__ == '__main__':

    main()
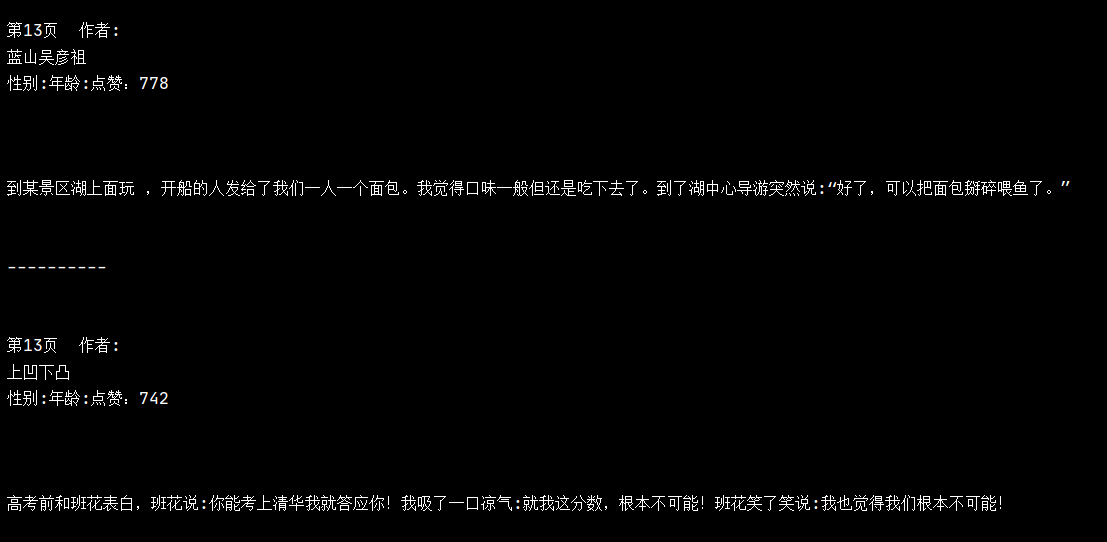
三、效果展示
base64解析爬取糗百的更多相关文章
- Python 爬虫入门(一)——爬取糗百
爬取糗百内容 GitHub 代码地址https://github.com/injetlee/Python/blob/master/qiubai_crawer.py 微信公众号:[智能制造专栏],欢迎关 ...
- Java - XPath解析爬取内容
code { margin: 0; padding: 0; white-space: pre; border: none; background: transparent; } pre { backg ...
- Beautifulsoup网页解析——爬取豆瓣排行榜分类接口
我们在网页爬取的过程中,会通过requests成功的获取到所需要的信息,而且,在返回的网页信息中,也是通过HTML代码的形式进行展示的.HTML代码都是通过固定的标签组合来实现页面信息的展示,所以,最 ...
- BS4爬取糗百
-- coding: cp936 -- import urllib,urllib2 from bs4 import BeautifulSoup user_agent='Mozilla/5.0 (Win ...
- python爬取糗百第一页的笑话
自学python网络爬虫,发现request比urllib还是要好用一些,因此利用request和BeautifulSoup来实现糗百的首页笑话的抓取.BeautifulSoup通过find和find ...
- 爬虫实例之使用requests和Beautifusoup爬取糗百热门用户信息
这次主要用requests库和Beautifusoup库来实现对糗百的热门帖子的用户信息的收集,由于糗百的反爬虫不是很严格,也不需要先登录才能获取数据,所以较简单. 思路,先请求首页的热门帖子获得用户 ...
- python爬取糗百内容
#-*- coding: utf-8 -*- import urllib import urllib2 import re #页面为1 page=1 url='http://www.qiushibai ...
- 接着上次的python爬虫,今天进阶一哈,局部解析爬取网页数据
*解析网页数据的仓库 用Beatifulsoup基于lxml包lxml包基于html和xml的标记语言的解析包.可以去解析网页的内容,把我们想要的提取出来. 第一步.导入两个包,项目中必须包含beau ...
- 全栈爬取-Scrapy框架(CrawlSpider)
引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法 ...
- scrapy框架基于CrawlSpider的全站数据爬取
引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法 ...
随机推荐
- 关于Loki中promtail组件收集日志的几点思考
promtail组件是采用docker方式运行的,配置文件也是在docker容器中,宿主机中没有挂载点,这就有问题了. 宿主机中没有挂载配置文件,也就没法修改,登录promtail的docker容器中 ...
- Docker网络详细理解-容器网络互通
这篇文章主要解决以下几个问题: 1.同一个网段的容器互相之间通过ip进行ping通 2.同一个网段的容器互相之间通过容器名,通过使用--link进行ping通,已放弃这种方法 3.同一个网段的容器互相 ...
- 利用curl命令访问Kubernetes API server
kubectl 通过访问 Kubernetes API 来执行命令.我们也可以通过对应的TLS key, 使用curl 或是 golang client做同样的事. API 请求必须使用 JSON 格 ...
- aardio + PHP 可视化快速开发独立 EXE 桌面程序
aardio 支持与很多编程语言混合开发.网络上大家分享的 aardio + Python 混合开发的文章很多,aardio + PHP 的文章却很少. 其实 aardio 与 PHP 混合开发是真的 ...
- Dubbo 02: 直连式
直连式 需要用到两个相互独立的maven的web项目 项目1:o1-link-userservice-provider 作为服务的提供者 项目2:o2-link-consumer 作为使用服务的消费者 ...
- 齐博x1频道的二次开发入门讲解
要进行频道的二次开发,首先我们要先了解一下频道的目录结构,如下图最基本的几个目录admin 后台文件存放目录index 前台文件存放目录member 会员中心存放目录model 数据表模型目录trai ...
- 齐博x1云市场注意事项
安装云市场应用注意事项 大到频道,小到插件甚至钩子及风格都可以在线安装,在线升级. 但是有一个大家务必注意的地方,就是重装系统后,再安装有可能导致重复收费. 这个问题是可以解决的.当然如果不是重装系统 ...
- NLP之基于词嵌入(WordVec)的嵌入矩阵生成并可视化
词嵌入 @ 目录 词嵌入 1.理论 1.1 为什么使用词嵌入? 1.2 词嵌入的类比推理 1.3 学习词嵌入 1.4 Word2Vec & Skip-Gram(跳字模型) 1.5 分级& ...
- 4.websocket基本概念
websockey的模式就是在于当前端向后端发送请求创建一个websocket链连接之后,连接默认不断开,前端和服务端就维护了一个连接,前端可以通过连接给服务端发消息,服务端也可以通过连接给前端发消息 ...
- 8_vue是如何进行数据代理的
在了解了关于js当中的Object.defineProperty()这个方法后,我们继续对vue当中的数据代理做一个基于现在的解析 建议观看之前先了解下js当中的Obejct.defineProper ...