
接着上次的python爬虫,今天进阶一哈,局部解析爬取网页数据
*解析网页数据的仓库
用Beatifulsoup基于lxml包
lxml包基于html和xml的标记语言的解析包。可以去解析网页的内容,把我们想要的提取出来。
第二步、先去获取网页的数据
def get_html():
    url="http://www.scetc.net"
    response=request.get(url)
    response.encoding="UTF-8"
    return response.text
from bs4 import BeautifulSoup
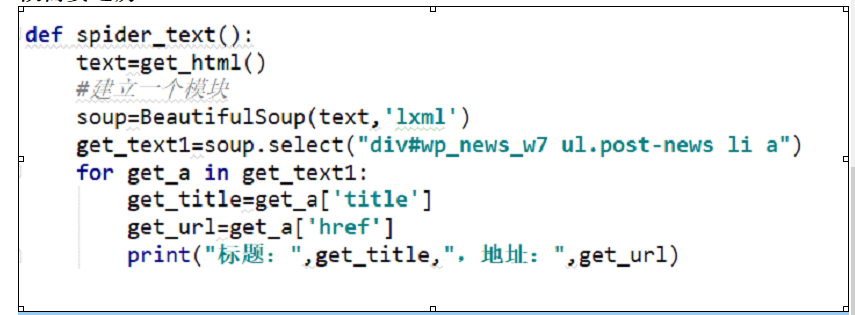
解析的方式文本格式就是 :
标记#id或者.class,如果有层次标记则空格 在后面加标记就可以了。
请注意一点就是select方法返回的肯定是列表,所以获取数据的时候需要遍历
*下载网上的其他资源
案例就是下载图片资源:
res = requests.get(url+stu_id+".jpg", stream=True)
file=open(stu_id+".jpg",'wb')
for chunk in res.iter_content(chunk_size=32):
file.write(chunk)
file.close()
接着上次的python爬虫,今天进阶一哈,局部解析爬取网页数据的更多相关文章
- 吴裕雄--天生自然PYTHON爬虫:安装配置MongoDBy和爬取天气数据并清洗保存到MongoDB中
1.下载MongoDB 官网下载:https://www.mongodb.com/download-center#community 上面这张图选择第二个按钮 上面这张图直接Next 把bin路径添加 ...
- Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(人人网)(下)
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(下) 自动使用cookie的方法,告别手动拷贝cookie http模块包含一些关于cookie的模块,通过他们我们可以自动的使用co ...
- [Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息
[Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息 2018-07-21 23:53:02 larger5 阅读数 4123更多 分类专栏: 网络爬虫 版权声明: ...
- Python使用urllib,urllib3,requests库+beautifulsoup爬取网页
Python使用urllib/urllib3/requests库+beautifulsoup爬取网页 urllib urllib3 requests 笔者在爬取时遇到的问题 1.结果不全 2.'抓取失 ...
- python之爬取网页数据总结(一)
今天尝试使用python,爬取网页数据.因为python是新安装好的,所以要正常运行爬取数据的代码需要提前安装插件.分别为requests Beautifulsoup4 lxml 三个插件 ...
- 爬虫系列4:Requests+Xpath 爬取动态数据
爬虫系列4:Requests+Xpath 爬取动态数据 [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]:参 ...
- python爬虫学习之使用BeautifulSoup库爬取开奖网站信息-模块化
实例需求:运用python语言爬取http://kaijiang.zhcw.com/zhcw/html/ssq/list_1.html这个开奖网站所有的信息,并且保存为txt文件和excel文件. 实 ...
- python爬虫——爬取网页数据和解析数据
1.网络爬虫的基本概念 网络爬虫(又称网络蜘蛛,机器人),就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序.只要浏览器能够做的事情,原则上,爬虫都能够做到. 2 ...
- 另类爬虫:从PDF文件中爬取表格数据
简介 本文将展示一个稍微不一样点的爬虫. 以往我们的爬虫都是从网络上爬取数据,因为网页一般用HTML,CSS,JavaScript代码写成,因此,有大量成熟的技术来爬取网页中的各种数据.这次, ...
随机推荐
- SQL:分区拾忆
1.文件组与文件 数据库属性——可以先添加多个文件组(抽象分割) 单个文件组可以有多文件(物理上的分割),可以添加文件然后指定文件组 例如: 2.分区函数 语法: CREATE PARTITION F ...
- text-transform
text-transform 语法: text-transform:none | capitalize | uppercase | lowercase | 默认值:none 适用于:所有元素 继承性 ...
- 学到了林海峰,武沛齐讲的Day16完
函数嵌套 foo()()() ==== foo()>>>gxr gxr()>>>wsb wsb()>>执行wsb函数 lambda 一行 ...
- 使用 Java 创建聊天客户端-2
1.项目截图 java聊天核心代码: MyJavaChatClient ================================================================ ...
- hud 6184
$n$ 点 $m$ 边的图求多少对三元环公用一条边变无向图为有向图 建图方法:对于每条无向边 度数小的端点向度数大的端点连边度数相同则编号小的点向编号大的点连边这样就构成 $DAG$遍历: 遍历每条边 ...
- 使用python画一颗圣诞树
# -*- coding: utf-8 -*- # @Time : 18-12-26 上午9:32 # @Author : Felix Wang import turtle # 定义圣诞树的绿叶函数 ...
- 传统PC机I/O位址空间范围
空间范围是0x000--0x3FF,有1024个I/O端口位址可供使用! 使用EISA或PCI等汇流排结构的现代PC机,有64KB的I/O位址空间可供使用.在普通Linux系统下透过查看/proc/i ...
- Python geometry_msgs.msg.PoseStamped() Examples
https://www.programcreek.com/python/example/70252/geometry_msgs.msg.PoseStampedhttps://programtalk.c ...
- Effective Java 3
<Effective Java>作者是美国的Joshua Bloch,连Gosling都说需要看的书,讨论的是更深层次的Java开发技术,适合于有一定Java基础的人看. 这是一本分享经验 ...
- Alphat【翻译】
翻译自:CFD-online 帖子地址:http://www.cfd-online.com/Forums/openfoam-solving/144625-alphat.html Wien3: 早上好 ...